🏗️ Transformer架构与注意力机制面试题
面试优先顺序(通用 AI 应用开发岗位):Q1、Q3、Q4、Q5、Q11、Q12、Q13、Q15、Q17。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
难度: ⭐⭐⭐⭐ 更新: 2026-08-21 考点: Transformer、Self-Attention、BERT、GPT、位置编码
📋 目录
一、Transformer基础
Q1: 什么是Transformer?为什么要引入Transformer?
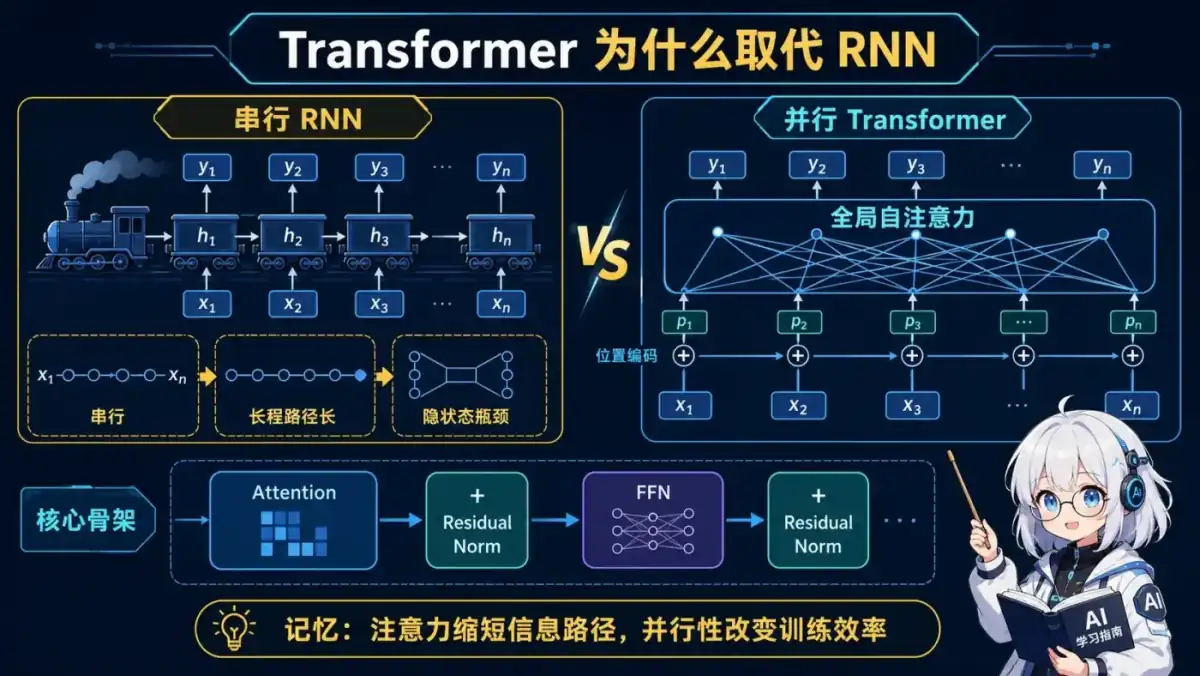
🧠 图解记忆:注意力缩短信息路径,并行性改变训练效率;点击图片可查看原图。
💡 答案要点
Transformer = 基于自注意力机制的序列到序列模型
为什么需要Transformer?
RNN/LSTM 的问题:
| 问题 | 说明 | 影响 |
|---|---|---|
| 串行计算 | 必须逐个处理token | 训练慢,无法并行 |
| 长程依赖 | 梯度消失/爆炸 | 难以捕捉远距离关系 |
| 信息瓶颈 | 所有信息压缩到隐状态 | 信息丢失 |
Transformer 的优势:
┌─────────────────────────────────────────────────────────┐
│                  Transformer 架构                        │
└─────────────────────────────────────────────────────────┘

输入序列 → Embedding + 位置编码
     ↓
Encoder (N × 6 层)
├── Multi-Head Self-Attention
├── Add & Norm
├── Feed-Forward Network
└── Add & Norm
     ↓
Decoder (N × 6 层)
├── Masked Multi-Head Self-Attention
├── Add & Norm
├── Encoder-Decoder Cross-Attention
├── Add & Norm
├── Feed-Forward Network
└── Add & Norm
     ↓
Linear + Softmax → 输出概率分布
核心创新:
Self-Attention(自注意力)
- 每个token都能直接"看到"所有其他token
- 复杂度:O(n²),但可以并行
Multi-Head Attention(多头注意力)
- 多个注意力头,捕捉不同维度的关系
- 8 或 16 个头
位置编码(Positional Encoding)
- 注入序列位置信息
- sin/cos 函数编码
残差连接 + Layer Norm
- 解决梯度消失
- 稳定训练
性能对比(机器翻译任务):
| 模型 | BLEU | 训练时间 | 参数量 |
|---|---|---|---|
| LSTM | 25.3 | 10天 | 200M |
| Transformer Base | 27.3 | 12小时 | 65M |
| Transformer Big | 28.4 | 3.5天 | 213M |
面试话术:
"Transformer 通过自注意力机制替代了RNN的串行计算。每个token可以直接关注所有其他token,实现了并行计算,训练速度提升10-100倍。虽然复杂度是O(n²),但在实际应用中,并行带来的收益远大于复杂度的损失。"
Q2: Transformer的Encoder和Decoder有什么区别?
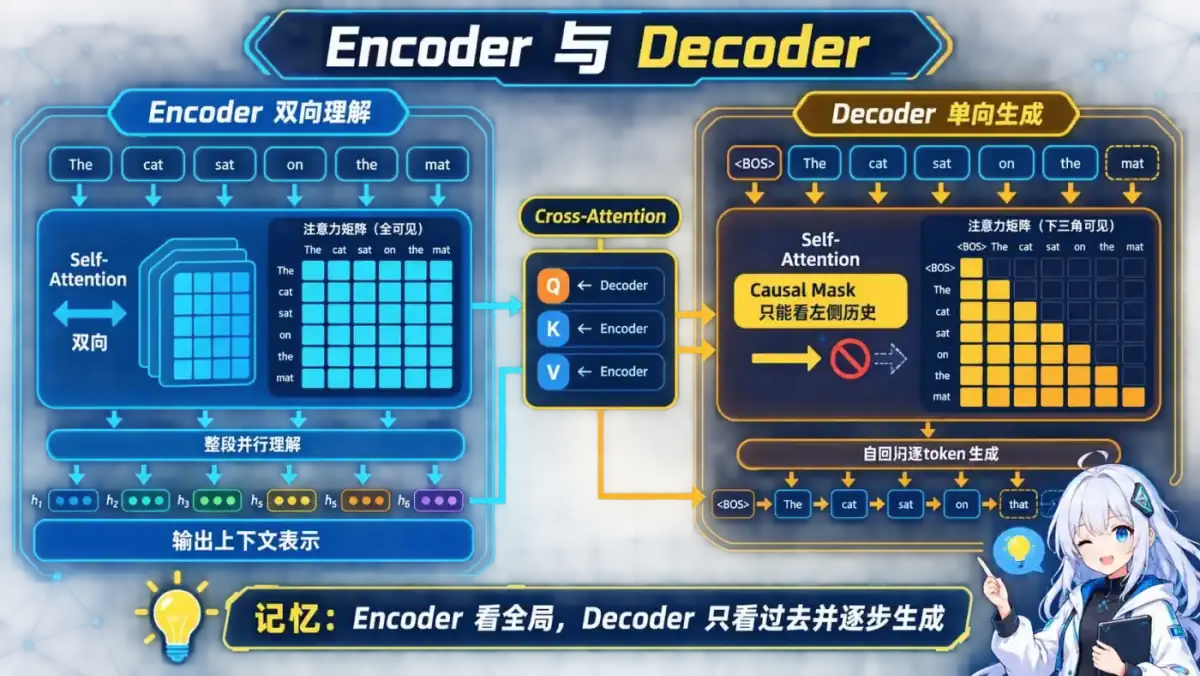
🧠 图解记忆:Encoder 看全局,Decoder 只看过去并逐步生成;点击图片可查看原图。
💡 答案要点
核心区别:Encoder是双向的,Decoder是单向的
Encoder(编码器):
# Encoder 结构(重复N次,通常N=6)
for layer in range(N):
    # 1. Multi-Head Self-Attention
    # 可以看到整个输入序列(双向)
    attn_output = MultiHeadAttention(
        Q=x, K=x, V=x  # Query、Key、Value 都来自输入
    )
    x = LayerNorm(x + attn_output)  # 残差 + 归一化

    # 2. Feed-Forward Network
    ffn_output = FeedForward(x)
    x = LayerNorm(x + ffn_output)
特点:
- ✅ 双向注意力(可以看到前后文)
- ✅ 并行处理所有token
- ✅ 输出:编码后的表示(上下文向量)
Decoder(解码器):
# Decoder 结构(重复N次,通常N=6)
for layer in range(N):
    # 1. Masked Multi-Head Self-Attention
    # 只能看到当前及之前的token(单向)
    masked_attn = MaskedMultiHeadAttention(
        Q=y, K=y, V=y,  # 来自目标序列
        mask=causal_mask  # 上三角mask
    )
    y = LayerNorm(y + masked_attn)

    # 2. Encoder-Decoder Cross-Attention
    # Query来自Decoder,Key和Value来自Encoder输出
    cross_attn = MultiHeadAttention(
        Q=y,  # 来自 Decoder
        K=encoder_output,  # 来自 Encoder
        V=encoder_output   # 来自 Encoder
    )
    y = LayerNorm(y + cross_attn)

    # 3. Feed-Forward Network
    ffn_output = FeedForward(y)
    y = LayerNorm(y + ffn_output)
特点:
- ⚠️ 单向注意力(Masked,只能看之前的)
- ✅ 包含Cross-Attention(连接Encoder和Decoder)
- ⚠️ 自回归生成(逐个token生成)
关键差异对比:
| 维度 | Encoder | Decoder |
|---|---|---|
| Self-Attention | 双向(无mask) | 单向(有mask) |
| Cross-Attention | ❌ 无 | ✅ 有(连接Encoder) |
| 输入 | 源序列(如英文) | 目标序列(如中文) |
| 输出 | 编码表示 | 生成序列 |
| 应用 | BERT(仅Encoder) | GPT(仅Decoder) |
Mask 机制详解:
# Encoder: 无mask,所有token都能互相看到
Input:  [I, love, AI]
Attention Matrix:
      I   love  AI
I    ✓    ✓    ✓
love ✓    ✓    ✓
AI   ✓    ✓    ✓

# Decoder: Causal Mask,只能看当前及之前
Input:  [我, 喜欢, 人工智能]
Attention Matrix:
        我  喜欢  人工智能
我      ✓   ✗    ✗
喜欢    ✓   ✓    ✗
人工智能 ✓   ✓    ✓
面试话术:
"Encoder用双向Self-Attention理解输入,Decoder用单向Masked Attention生成输出。Decoder还有Cross-Attention层,让生成的每个token都能关注Encoder的所有输出。BERT只用Encoder(理解任务),GPT只用Decoder(生成任务)。"
二、注意力机制
Q3: Self-Attention(自注意力)是如何计算的?
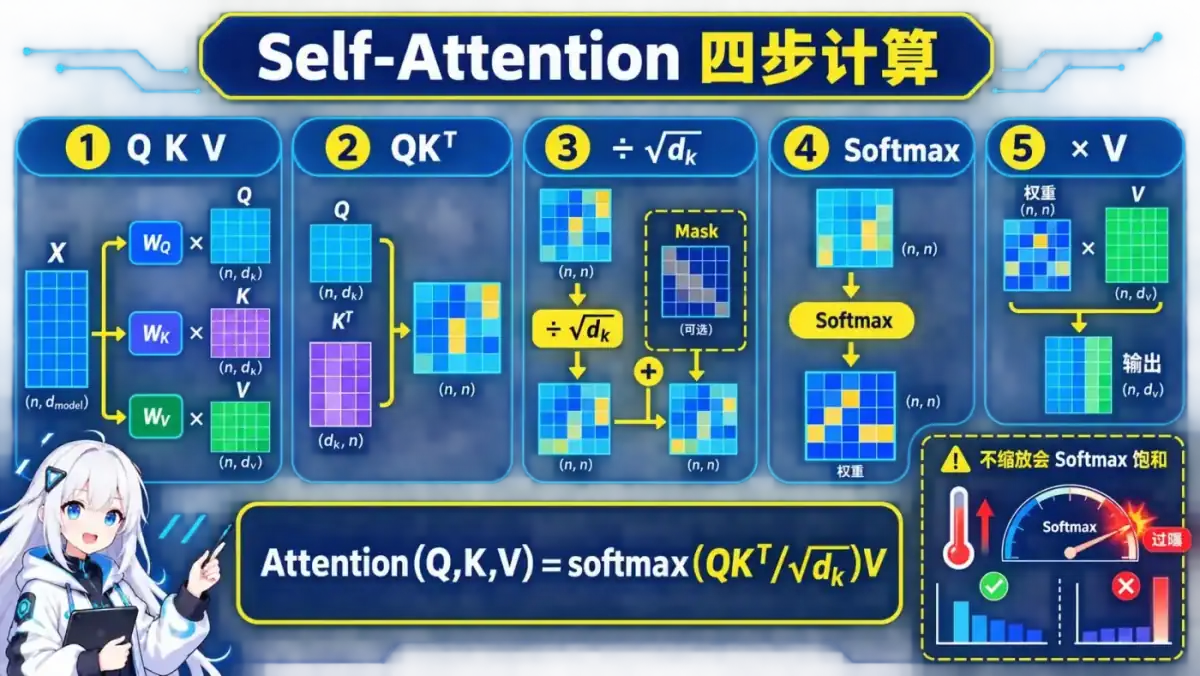
🧠 图解记忆:Q 和 K 算关注权重,缩放稳定 Softmax,再用权重汇总 V;点击图片可查看原图。
💡 答案要点
Self-Attention = 让序列中的每个元素都能关注其他所有元素
数学公式:
Attention(Q, K, V) = softmax(QK^T / √d_k) V详细步骤:
1. 生成 Q、K、V:
# 输入:X (batch_size, seq_len, d_model)
# 例如:(1, 5, 512)

# 通过线性变换生成 Q、K、V
Q = X @ W_Q  # (batch_size, seq_len, d_k)
K = X @ W_K  # (batch_size, seq_len, d_k)
V = X @ W_V  # (batch_size, seq_len, d_v)

# W_Q, W_K, W_V 是可学习的权重矩阵
# d_k = d_v = d_model / num_heads (通常 64)
2. 计算注意力分数:
# 点积计算相似度
scores = Q @ K.T  # (batch_size, seq_len, seq_len)
# 例如:(1, 5, 5)

# 缩放(避免点积随维度增大,使 Softmax 过度饱和)
scores = scores / math.sqrt(d_k)

# 应用mask(可选,Decoder用)
if mask is not None:
    scores = scores.masked_fill(mask == 0, -1e9)
3. Softmax归一化:
# 每一行做softmax,得到注意力权重
attention_weights = softmax(scores, dim=-1)
# (batch_size, seq_len, seq_len)

# 权重和为1
assert attention_weights.sum(dim=-1) == 1.0
4. 加权求和:
# 用注意力权重加权V
output = attention_weights @ V
# (batch_size, seq_len, d_v)
完整示例(序列长度=3):
展开 Python 代码示例(31 行)
# 输入
X = [[1.0, 0.5],  # token 1
     [0.8, 1.0],  # token 2
     [0.5, 0.9]]  # token 3

# 假设 W_Q = W_K = W_V = I(单位矩阵)
Q = K = V = X

# 1. 计算相似度矩阵
scores = Q @ K.T
# [[1.25, 1.3, 0.95],
#  [1.3,  1.64, 1.3],
#  [0.95, 1.3, 1.06]]

# 2. 缩放(假设 d_k=2)
scores = scores / sqrt(2)
# [[0.88, 0.92, 0.67],
#  [0.92, 1.16, 0.92],
#  [0.67, 0.92, 0.75]]

# 3. Softmax
attention_weights = softmax(scores, dim=-1)
# [[0.32, 0.35, 0.33],  # token 1 对 3 个token的注意力
#  [0.28, 0.44, 0.28],  # token 2 对 3 个token的注意力
#  [0.29, 0.37, 0.34]]  # token 3 对 3 个token的注意力

# 4. 加权求和
output = attention_weights @ V
# [[0.77, 0.80],  # token 1的输出
#  [0.76, 0.87],  # token 2的输出
#  [0.74, 0.82]]  # token 3的输出
为什么要缩放(除以√d_k)?
问题:
  当 d_k 很大时(如512),QK^T 的值会很大
  → Softmax 梯度接近0(饱和)
  → 梯度消失

解决:
  除以 √d_k,将方差缩放到1
  → 保持Softmax输入在合理范围
  → 梯度稳定
面试话术:
"Self-Attention 先用 QK^T 计算相关性,再除以 √d_k,避免维度增大时点积过大导致 Softmax 饱和;随后归一化权重并对 V 加权求和。"
Q4: Multi-Head Attention(多头注意力)是什么?为什么要用多头?
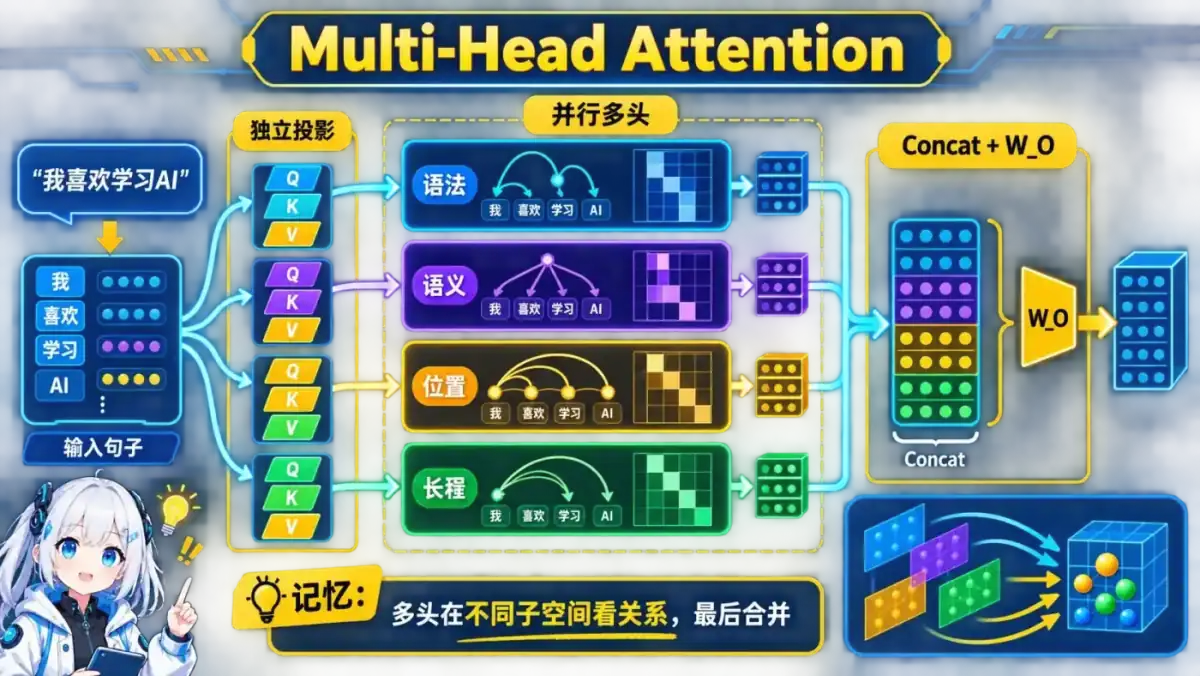
🧠 图解记忆:多头在不同子空间看关系,最后合并;点击图片可查看原图。
💡 答案要点
Multi-Head Attention = 多个Self-Attention并行,捕捉不同类型的关系
为什么需要多头?
单头的局限:
单个注意力头只能学习一种模式
例如:
  "我 爱 吃 苹果"

单头可能只关注:
  语法关系:"我" ← "爱"(主谓)

但错过了:
  语义关系:"吃" ← "苹果"(动宾)
  共指关系:"我" → "我"(指代)
多头的优势:
8个头可以学习不同的模式:
  Head 1: 语法关系(主谓宾)
  Head 2: 语义关系(实体-动作)
  Head 3: 位置关系(相邻词)
  Head 4: 长程依赖(句首-句尾)
  ...
  Head 8: 其他模式
架构:
展开 Python 代码示例(46 行)
class MultiHeadAttention:
    def __init__(self, d_model=512, num_heads=8):
        self.num_heads = num_heads
        self.d_k = d_model // num_heads  # 64

        # 每个头有独立的 Q、K、V 权重
        self.W_Q = nn.Linear(d_model, d_model)
        self.W_K = nn.Linear(d_model, d_model)
        self.W_V = nn.Linear(d_model, d_model)

        # 输出投影
        self.W_O = nn.Linear(d_model, d_model)

    def forward(self, Q, K, V, mask=None):
        batch_size = Q.size(0)

        # 1. 线性变换并分头
        # (batch, seq_len, d_model) → (batch, seq_len, num_heads, d_k)
        Q = self.W_Q(Q).view(batch_size, -1, self.num_heads, self.d_k)
        K = self.W_K(K).view(batch_size, -1, self.num_heads, self.d_k)
        V = self.W_V(V).view(batch_size, -1, self.num_heads, self.d_k)

        # 转置以并行计算多头
        # (batch, num_heads, seq_len, d_k)
        Q = Q.transpose(1, 2)
        K = K.transpose(1, 2)
        V = V.transpose(1, 2)

        # 2. 每个头独立计算注意力
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        attention = F.softmax(scores, dim=-1)
        output = torch.matmul(attention, V)

        # 3. 合并多头
        # (batch, num_heads, seq_len, d_k) → (batch, seq_len, d_model)
        output = output.transpose(1, 2).contiguous()
        output = output.view(batch_size, -1, self.num_heads * self.d_k)

        # 4. 输出投影
        output = self.W_O(output)

        return output
可视化示例(8个头):
输入:"The cat sat on the mat"

Head 1(主语-谓语):
  cat → sat (0.9)

Head 2(谓语-宾语):
  sat → mat (0.8)

Head 3(修饰关系):
  the → cat (0.7)
  the → mat (0.6)

Head 4(位置关系):
  on → the (0.9)

...

最终输出 = Concat(Head1, Head2, ..., Head8) @ W_O
参数对比:
| 方案 | 参数量 | 表达能力 |
|---|---|---|
| 单头(d_model=512) | 512² × 3 = 786K | 低 |
| 8头(d_k=64) | 512² × 3 + 512² = 1.05M | 高 |
实验证明(BLEU分数,机器翻译):
| 头数 | BLEU | 说明 |
|---|---|---|
| 1 | 25.8 | 单头 |
| 2 | 26.4 | +0.6 |
| 4 | 27.1 | +1.3 |
| 8 | 27.3 | 最佳 |
| 16 | 27.2 | 过多反而下降 |
面试话术:
"Multi-Head Attention让模型同时学习多种注意力模式。8个头可以分别关注语法、语义、位置等不同维度的关系。虽然参数量略增,但表达能力大幅提升。实验表明8头是最佳选择。"
Q5: 位置编码(Positional Encoding)是什么?为什么需要它?
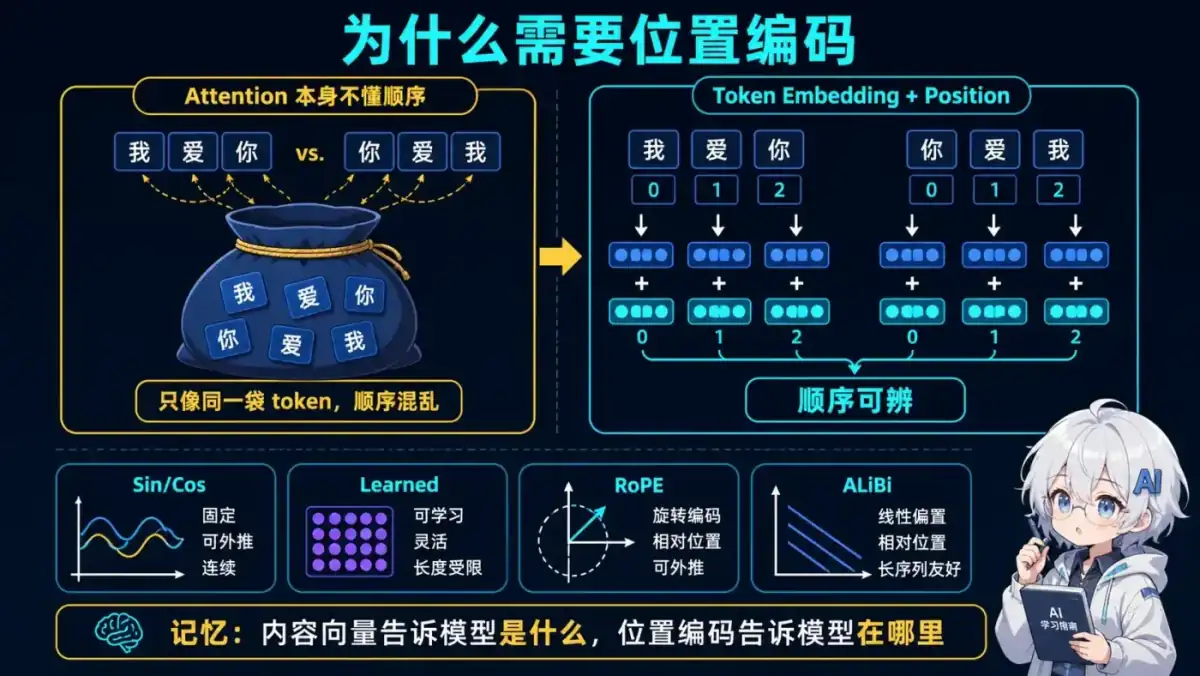
🧠 图解记忆:内容向量告诉模型是什么,位置编码告诉模型在哪里;点击图片可查看原图。
💡 答案要点
位置编码 = 给每个token注入位置信息
为什么需要?
问题:
  Self-Attention 是置换不变的(permutation-invariant)

例子:
  "我 爱 你" 和 "你 爱 我"
  如果没有位置编码,Attention 输出可能相同
  → 无法区分顺序

解决:
  加入位置信息,让模型知道每个token的位置
Transformer 的位置编码(Sinusoidal):
公式:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))

其中:
  pos: 位置(0, 1, 2, ...)
  i:   维度索引(0 到 d_model/2)
  d_model: 模型维度(如512)
实现:
def positional_encoding(max_len, d_model):
    # 创建位置矩阵
    position = torch.arange(max_len).unsqueeze(1)  # (max_len, 1)

    # 创建维度矩阵
    div_term = torch.exp(
        torch.arange(0, d_model, 2) *
        -(math.log(10000.0) / d_model)
    )  # (d_model/2,)

    # 初始化位置编码
    pe = torch.zeros(max_len, d_model)

    # 偶数维度用sin
    pe[:, 0::2] = torch.sin(position * div_term)

    # 奇数维度用cos
    pe[:, 1::2] = torch.cos(position * div_term)

    return pe

# 使用
pe = positional_encoding(max_len=100, d_model=512)
# pe.shape: (100, 512)

# 加到输入上
x = embedding(input_ids) + pe[: input_ids.size(1)]
为什么用sin/cos?
优势:
- 确定性:位置固定,不需要学习
- 可生成任意位置的编码:公式能计算训练长度之外的位置,但模型在更长序列上的有效能力仍需实测
- 周期性:不同位置间有规律的相对关系
相对位置关系:
# PE(pos + k) 可以表示为 PE(pos) 的线性组合
# 这让模型能学习相对位置

例如:
  PE(5) 和 PE(10) 的距离
  = PE(1) 和 PE(6) 的距离
  (相对距离都是5)
可视化(前10个位置,前64维):
位置  维度0  维度1  维度2  维度3  ...
0     0.00   1.00   0.00   1.00
1     0.84   0.54   0.01   1.00
2     0.91  -0.42   0.02   1.00
3     0.14  -0.99   0.03   1.00
...
其他位置编码方案:
| 方案 | 优点 | 缺点 | 应用 |
|---|---|---|---|
| Sinusoidal | 确定性,可计算更长位置 | 训练长度外效果无保证 | Transformer |
| Learned | 可学习,灵活 | 超出已训练位置通常需要扩展并继续训练 | BERT |
| RoPE | 相对位置,旋转 | 实现复杂 | LLaMA |
| ALiBi | 注意力偏置 | 需要重训练 | BLOOM |
现代改进:RoPE(Rotary Position Embedding):
# LLaMA/GPT-NeoX 使用
# 核心思想:在注意力计算时旋转 Q 和 K

def apply_rotary_emb(q, k, cos, sin):
    # 旋转 Q 和 K
    q_rot = rotate_half(q)
    k_rot = rotate_half(k)

    q = q * cos + q_rot * sin
    k = k * cos + k_rot * sin

    return q, k

# 优势:
#   - 相对位置编码
#   - 便于表达相对位置信息
#   - 长度扩展仍需要缩放策略并通过目标任务验证
面试话术:
"Transformer 需要额外注入位置信息。Sin/Cos 编码无训练参数且能计算任意位置;RoPE 通过旋转 Q、K 让注意力分数自然携带相对位置信息。两者在训练长度外都不能只凭公式宣称有效,必须做长上下文评测。"
三、BERT与GPT
Q6: BERT 和 GPT 有什么区别?
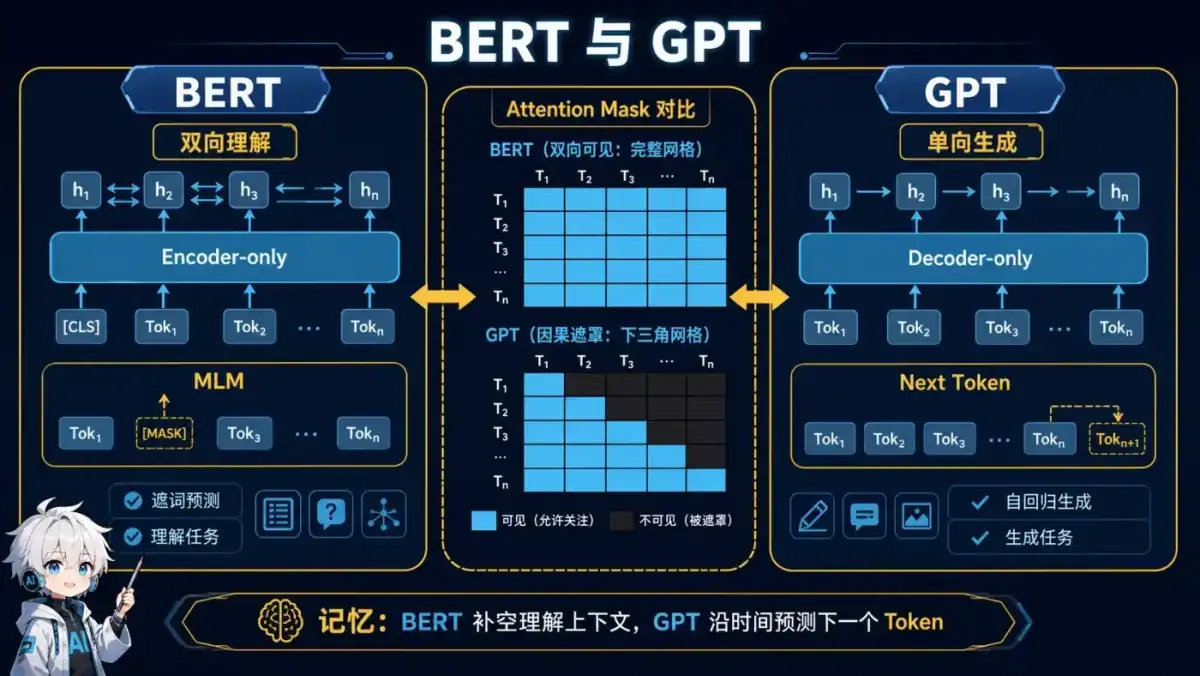
🧠 图解记忆:BERT 补空理解上下文,GPT 沿时间预测下一个 Token;点击图片可查看原图。
💡 答案要点
核心区别:BERT是双向理解,GPT是单向生成
架构对比:
| 维度 | BERT | GPT |
|---|---|---|
| 架构 | 仅Encoder | 仅Decoder |
| 注意力 | 双向(无mask) | 单向(causal mask) |
| 训练目标 | MLM + NSP | 自回归语言模型 |
| 任务类型 | 理解(分类、NER) | 生成(文本生成) |
| 参数 | 110M-340M | 117M-175B |
BERT(Bidirectional Encoder Representations from Transformers):
┌─────────────────────────────────────────────────────────┐
│                    BERT 架构                             │
└─────────────────────────────────────────────────────────┘

输入:"The [MASK] sat on the mat"
  ↓
Embedding + Positional Encoding
  ↓
Transformer Encoder (12/24 层)
├── Multi-Head Self-Attention(双向)
└── Feed-Forward Network
  ↓
输出:每个token的上下文表示
  ↓
任务头(分类/NER/...)
训练目标1:MLM(Masked Language Model)
# 随机mask 15%的token
原文:"The cat sat on the mat"
Mask: "The [MASK] sat on the [MASK]"

# 预测被mask的词
损失 = CrossEntropy(预测, ["cat", "mat"])

# 15%中的策略:
#   80%: 替换为 [MASK]
#   10%: 替换为随机词
#   10%: 保持不变
训练目标2:NSP(Next Sentence Prediction)
# 判断两句话是否连续
输入:
  A: "The cat sat on the mat."
  B: "It was very comfortable."
  Label: IsNext (1) or NotNext (0)

损失 = BCELoss(预测, Label)
GPT(Generative Pre-trained Transformer):
┌─────────────────────────────────────────────────────────┐
│                    GPT 架构                              │
└─────────────────────────────────────────────────────────┘

输入:"The cat sat on"
  ↓
Embedding + Positional Encoding
  ↓
Transformer Decoder (12/96 层)
├── Masked Multi-Head Self-Attention(单向)
└── Feed-Forward Network
  ↓
输出:下一个token的概率分布
  ↓
预测:"the" (概率0.8)
训练目标:自回归语言模型
# 预测下一个词
输入:"The cat sat"
目标:"on"

# 训练时并行计算所有位置的损失
损失 = Σ CrossEntropy(预测[i], 目标[i])

# 推理时自回归生成
generated = []
for i in range(max_len):
    next_token = model.predict(generated)
    generated.append(next_token)
能力对比:
| 任务 | BERT | GPT |
|---|---|---|
| 文本分类 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 命名实体识别 | ⭐⭐⭐⭐⭐ | ⭐⭐ |
| 问答 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 文本生成 | ⭐ | ⭐⭐⭐⭐⭐ |
| 摘要 | ⭐⭐ | ⭐⭐⭐⭐⭐ |
| 对话 | ⭐ | ⭐⭐⭐⭐⭐ |
实际应用:
BERT 擅长:
# 1. 分类
"This movie is great!" → Positive (0.95)

# 2. NER(命名实体识别)
"Apple was founded by Steve Jobs"
→ [Apple: ORG], [Steve Jobs: PER]

# 3. 问答
Context: "Paris is the capital of France."
Question: "What is the capital of France?"
Answer: "Paris" (span: [0, 5])
GPT 擅长:
# 1. 文本生成
Prompt: "Once upon a time"
Output: "there was a brave knight..."

# 2. 对话
User: "How are you?"
GPT: "I'm doing well, thank you!"

# 3. 代码生成
Prompt: "Write a Python function to sort a list"
Output: "def sort_list(arr): return sorted(arr)"
为什么BERT用双向,GPT用单向?
BERT:
  目标是理解语言
  双向能看到完整上下文
  例如:"bank"(银行 vs 河岸)需要前后文判断

GPT:
  目标是生成语言
  必须单向,否则"作弊"
  生成时只能看已生成的部分
面试话术:
"BERT 是理解型模型,用双向Encoder + MLM训练,擅长分类、NER。GPT 是生成型模型,用单向Decoder + 自回归训练,擅长文本生成、对话。BERT看完整上下文理解语义,GPT逐个生成token。"
四、优化技巧
Q7: Transformer 训练时有哪些优化技巧?
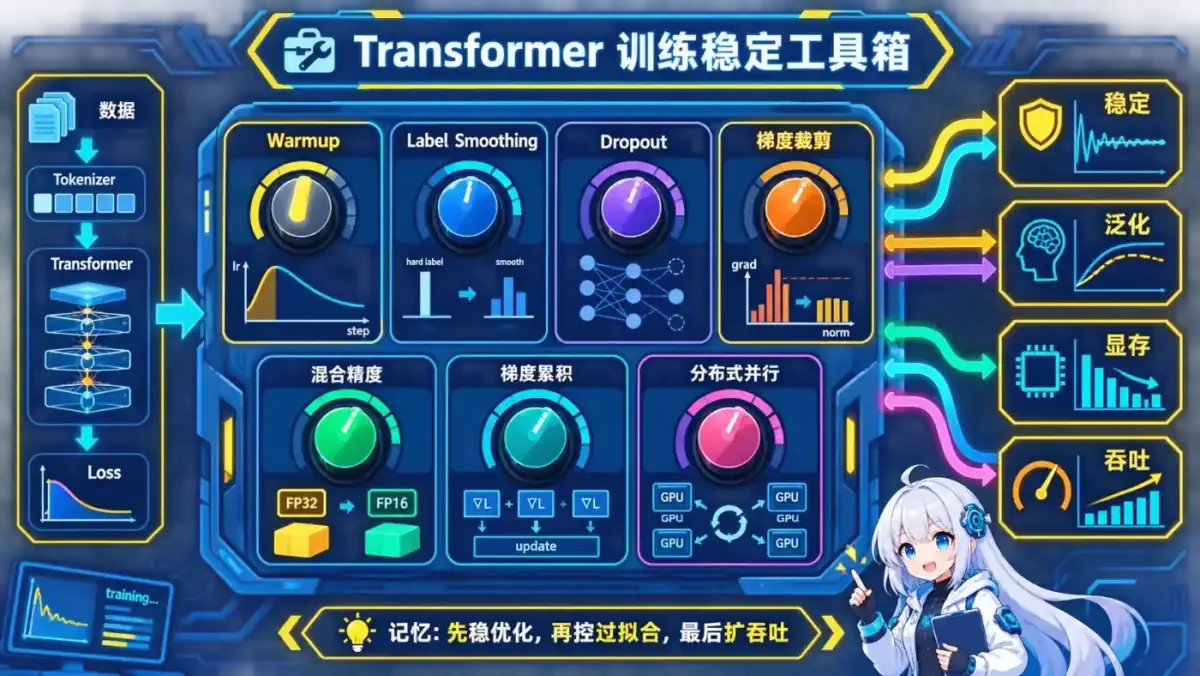
🧠 图解记忆:先稳优化,再控过拟合,最后扩吞吐;点击图片可查看原图。
💡 答案要点
核心优化方向:
- 学习率调度
- 正则化
- 训练稳定性
- 计算效率
1. 学习率调度(Warmup + Decay):
# Warmup阶段:线性增加学习率
def get_lr(step, d_model, warmup_steps=4000):
    # Transformer 原论文方案
    lr = d_model ** (-0.5) * min(
        step ** (-0.5),
        step * warmup_steps ** (-1.5)
    )
    return lr

# 为什么需要Warmup?
# - 初始时权重随机,梯度不稳定
# - 小学习率让模型"热身"
# - 然后逐渐增大到峰值
# - 最后逐渐衰减

# 典型曲线:
#   0-4K步:线性增加 0 → peak_lr
#   4K步后:按 1/√step 衰减
2. Label Smoothing(标签平滑):
展开 Python 代码示例(30 行)
# 问题:Hard Label容易过拟合
hard_label = [0, 0, 0, 1, 0]  # one-hot

# 解决:Label Smoothing
smooth_label = [0.02, 0.02, 0.02, 0.92, 0.02]
# 真实类别:0.92(1 - smoothing)
# 其他类别:0.02(smoothing / (n_classes - 1))

class LabelSmoothingLoss(nn.Module):
    def __init__(self, n_classes, smoothing=0.1):
        super().__init__()
        self.smoothing = smoothing
        self.n_classes = n_classes

    def forward(self, pred, target):
        # pred: (batch, n_classes)
        # target: (batch,) 类别索引

        confidence = 1.0 - self.smoothing
        smooth_value = self.smoothing / (self.n_classes - 1)

        # 构造smooth label
        smooth_label = torch.full_like(pred, smooth_value)
        smooth_label.scatter_(1, target.unsqueeze(1), confidence)

        # KL散度损失
        loss = -torch.sum(smooth_label * torch.log_softmax(pred, dim=1), dim=1)
        return loss.mean()

# 效果:提升泛化能力,BLEU +0.2
3. Dropout 策略:
class TransformerLayer(nn.Module):
    def __init__(self, d_model=512, dropout=0.1):
        super().__init__()
        self.dropout = dropout

    def forward(self, x):
        # 1. Attention Dropout
        attn_output = self.attention(x)
        attn_output = F.dropout(attn_output, p=self.dropout, training=self.training)

        # 2. Residual Dropout
        x = x + attn_output

        # 3. FFN Dropout
        ffn_output = self.ffn(x)
        ffn_output = F.dropout(ffn_output, p=self.dropout, training=self.training)

        x = x + ffn_output

        return x

# 典型配置:
#   Attention Dropout: 0.1
#   Residual Dropout: 0.1
#   FFN Dropout: 0.1
#   Embedding Dropout: 0.1
4. 梯度裁剪(Gradient Clipping):
# 防止梯度爆炸
max_grad_norm = 1.0

for batch in dataloader:
    loss = model(batch)
    loss.backward()

    # 裁剪梯度
    torch.nn.utils.clip_grad_norm_(
        model.parameters(),
        max_grad_norm
    )

    optimizer.step()
    optimizer.zero_grad()
5. Mixed Precision Training(混合精度):
from torch.cuda.amp import autocast, GradScaler

scaler = GradScaler()

for batch in dataloader:
    optimizer.zero_grad()

    # FP16 前向传播
    with autocast():
        loss = model(batch)

    # 缩放损失,FP16 反向传播
    scaler.scale(loss).backward()

    # 更新权重(FP32)
    scaler.step(optimizer)
    scaler.update()

# 优势:
#   - 速度提升 2-3 倍
#   - 显存节省 50%
#   - 精度损失 < 0.1%
6. 批量大小优化:
# 问题:GPU显存有限,batch_size受限

# 解决:梯度累积
accumulation_steps = 4
effective_batch_size = batch_size * accumulation_steps

optimizer.zero_grad()
for i, batch in enumerate(dataloader):
    loss = model(batch) / accumulation_steps
    loss.backward()

    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()

# 效果:
#   原来:batch_size=32,每步更新
#   现在:batch_size=32×4=128,每4步更新
#   显存不变,效果更好
7. 并行训练:
# 数据并行(Data Parallel)
model = nn.DataParallel(model)

# 分布式数据并行(Distributed Data Parallel,推荐)
model = nn.parallel.DistributedDataParallel(model)

# 模型并行(Model Parallel,超大模型)
# 不同层放在不同GPU
class ModelParallel(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(*layers[:6]).to('cuda:0')
        self.decoder = nn.Sequential(*layers[6:]).to('cuda:1')

    def forward(self, x):
        x = self.encoder(x.to('cuda:0'))
        x = self.decoder(x.to('cuda:1'))
        return x
典型配置(Transformer Base):
| 参数 | 值 |
|---|---|
| d_model | 512 |
| n_heads | 8 |
| d_ff | 2048 |
| n_layers | 6 |
| dropout | 0.1 |
| warmup_steps | 4000 |
| label_smoothing | 0.1 |
| max_grad_norm | 1.0 |
| batch_size | 25K tokens |
| optimizer | Adam(β1=0.9, β2=0.98, ε=1e-9) |
面试话术:
"Transformer 训练的关键优化包括:Warmup学习率调度(先升后降)、Label Smoothing防过拟合、多层Dropout正则化、梯度裁剪防爆炸。工程上用混合精度训练加速2-3倍,梯度累积模拟大batch。"
Q8: Q K V矩阵的详细计算过程是什么?
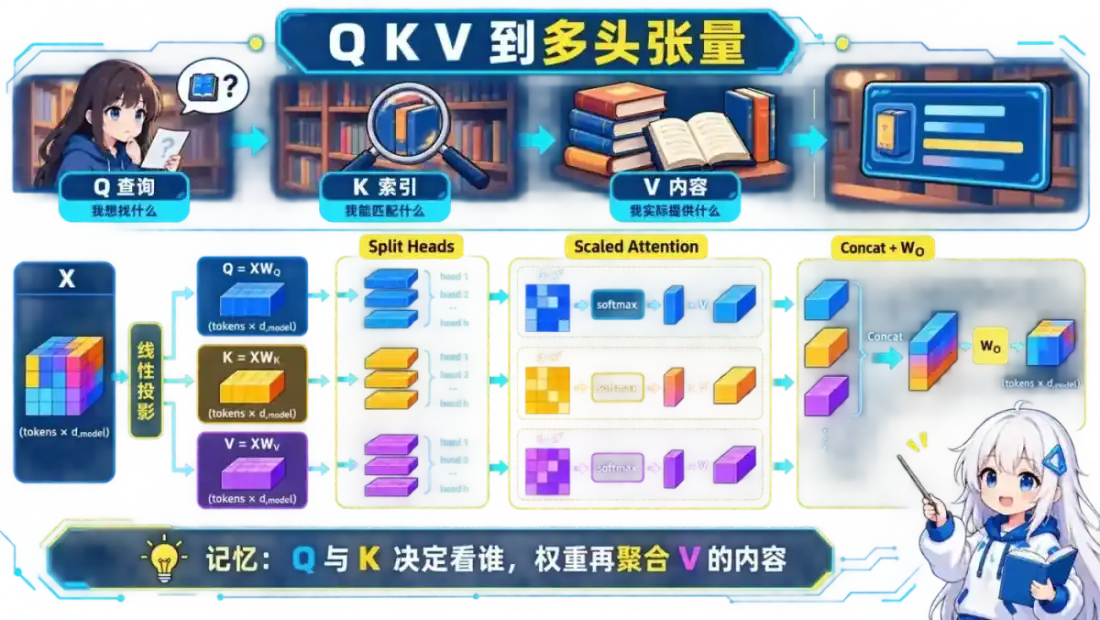
🧠 图解记忆:Q 与 K 决定看谁,权重再聚合 V 的内容;点击图片可查看原图。
💡 答案要点
Q K V = Query(查询)、Key(键)、Value(值)
生成过程
步骤1: 输入embedding
# 输入序列: "我 爱 AI"
input_ids = [101, 234, 567]  # token IDs
embeddings = embedding_layer(input_ids)  # shape: (3, 512)
# 每个token → 512维向量

# 加上位置编码
position_encodings = get_position_encoding(3, 512)
input_repr = embeddings + position_encodings  # shape: (3, 512)
步骤2: 线性变换生成Q K V
# 3个可学习的权重矩阵
W_Q = nn.Linear(512, 512)  # Query权重
W_K = nn.Linear(512, 512)  # Key权重
W_V = nn.Linear(512, 512)  # Value权重

# 生成Q K V
Q = W_Q(input_repr)  # shape: (3, 512)
K = W_K(input_repr)  # shape: (3, 512)
V = W_V(input_repr)  # shape: (3, 512)
为什么需要3个矩阵?
- Q(查询): "我想找什么信息?"
- K(键): "我能提供什么信息?"
- V(值): "我包含什么信息?"
类比搜索引擎:
Q = 用户搜索词 "Python教程"
K = 文档标题 ["Python入门", "Java教程", "Python高级"]
V = 文档内容 [实际的Python教程文本]

步骤:
1. Q与每个K计算相似度 → 注意力分数
2. 用分数加权V → 最终输出
Multi-Head Attention详细计算
步骤1: 拆分成多个头
num_heads = 8
d_model = 512
d_k = d_model // num_heads  # 512 / 8 = 64

# 将Q K V reshape成多头
Q_multi = Q.view(batch_size, seq_len, num_heads, d_k)
# shape: (batch, 3, 8, 64)

K_multi = K.view(batch_size, seq_len, num_heads, d_k)
V_multi = V.view(batch_size, seq_len, num_heads, d_k)

# 转置: (batch, num_heads, seq_len, d_k)
Q_multi = Q_multi.transpose(1, 2)  # (batch, 8, 3, 64)
K_multi = K_multi.transpose(1, 2)
V_multi = V_multi.transpose(1, 2)
步骤2: 每个头独立计算Attention
# Scaled Dot-Product Attention
scores = torch.matmul(Q_multi, K_multi.transpose(-2, -1))
# shape: (batch, 8, 3, 3)
# 3×3矩阵: 每个token对所有token的注意力分数

# 缩放(避免点积过大导致 Softmax 饱和)
scores = scores / math.sqrt(d_k)  # 除以√64 = 8

# Softmax归一化
attention_weights = F.softmax(scores, dim=-1)
# shape: (batch, 8, 3, 3)

# 加权求和
output = torch.matmul(attention_weights, V_multi)
# shape: (batch, 8, 3, 64)
步骤3: 拼接所有头
# 转置回来
output = output.transpose(1, 2)  # (batch, 3, 8, 64)

# 拼接
output = output.contiguous().view(batch_size, seq_len, d_model)
# shape: (batch, 3, 512)  # 8×64 = 512

# 最终线性变换
output = W_O(output)  # W_O: (512, 512)
完整示例(数值):
# 假设seq_len=3, d_k=4 (简化)
Q = [[1,0,1,0],   # token1的Query
     [0,2,0,2],   # token2的Query
     [1,1,1,1]]   # token3的Query

K = [[0,1,0,1],   # token1的Key
     [1,1,1,1],   # token2的Key
     [2,2,2,2]]   # token3的Key

# 步骤1: Q × K^T
scores = Q @ K.T
# [[1,2,4],
#  [4,4,8],
#  [2,4,8]]

# 步骤2: 缩放
scores = scores / sqrt(4) = scores / 2
# [[0.5,1,2],
#  [2,2,4],
#  [1,2,4]]

# 步骤3: Softmax
weights = softmax(scores, dim=-1)
# [[0.18, 0.24, 0.58],   # token1关注token3最多
#  [0.12, 0.12, 0.76],   # token2关注token3最多
#  [0.09, 0.24, 0.67]]   # token3关注自己最多

# 步骤4: 加权求和Value
output = weights @ V
面试话术:
"Q K V的本质是3种视角看同一个信息。Q是'我要找什么',K是'我能匹配什么',V是'我的内容是什么'。Multi-Head让模型从8个不同角度理解文本,比如一个头关注语法,另一个关注语义。"
Q9: 位置编码的详细原理是什么?为什么用sin/cos?
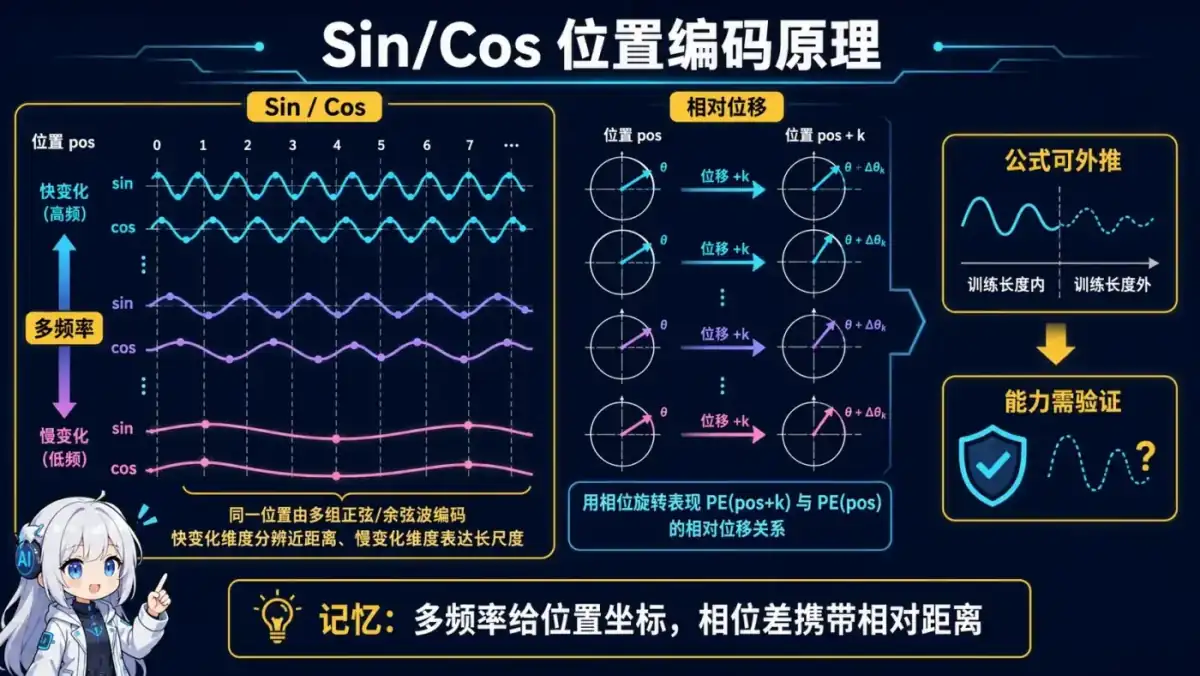
🧠 图解记忆:多频率给位置坐标,相位差携带相对距离;点击图片可查看原图。
💡 答案要点
位置编码 = 让模型知道token的位置信息
为什么需要位置编码?
问题:不含位置编码的 Self-Attention 对输入置换是等变的,无法单独区分词序
# 改变输入顺序会相应改变输出位置,但不会自动知道“第几个 token”的语义
input1 = ["狗", "咬", "人"]
input2 = ["人", "咬", "狗"]

# 若忽略输出位置的同样置换,计算结构本身不含绝对顺序信息
解决: 加入位置信息
embedding_with_pos = word_embedding + positional_encodingSin/Cos位置编码公式
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))

其中:
- pos: 位置(0, 1, 2, ...)
- i: 维度索引(0 到 d_model/2)
- d_model: embedding维度(如512)
具体计算示例:
import numpy as np

def get_positional_encoding(max_len, d_model):
    pe = np.zeros((max_len, d_model))

    for pos in range(max_len):
        for i in range(0, d_model, 2):
            # 偶数维度: sin
            pe[pos, i] = np.sin(pos / (10000 ** (i/d_model)))

            # 奇数维度: cos
            if i+1 < d_model:
                pe[pos, i+1] = np.cos(pos / (10000 ** (i/d_model)))

    return pe

# 示例: max_len=100, d_model=512
pe = get_positional_encoding(100, 512)

# 位置0的编码
print(pe[0])  # [sin(0/1), cos(0/1), sin(0/464), cos(0/464), ...]

# 位置1的编码
print(pe[1])  # [sin(1/1), cos(1/1), sin(1/464), cos(1/464), ...]
为什么选sin/cos?
优势1: 表示相对位置
# 数学性质: sin/cos的线性组合
sin(α + β) = sin(α)cos(β) + cos(α)sin(β)
cos(α + β) = cos(α)cos(β) - sin(α)sin(β)

# 意味着: PE(pos+k)可由PE(pos)线性变换得到
# 模型容易学习相对位置关系
优势2: 泛化到未见过的长度
# 训练: max_len=512
# 推理: len=1024  # 超出训练长度

# sin/cos是连续函数,可以外推
pe_1024 = get_positional_encoding(1024, 512)  # 依然有效!
优势3: 不同频率捕捉不同范围
# 低频(i接近0): 变化慢,捕捉长距离关系
PE(pos, 0) = sin(pos / 1)  # 周期短,变化快

# 高频(i接近d_model): 变化快,捕捉近距离关系
PE(pos, 511) = sin(pos / 10000)  # 周期长,变化慢
可视化:
Position 0: [0.00, 1.00, 0.00, 1.00, 0.00, 1.00, ...]
Position 1: [0.84, 0.54, 0.01, 1.00, 0.00, 1.00, ...]
Position 2: [0.91,-0.42, 0.02, 1.00, 0.00, 1.00, ...]
           ↑ 快变化  ↑ 慢变化
其他位置编码方法
| 方法 | 原理 | 优缺点 | 应用 |
|---|---|---|---|
| Sin/Cos | 固定公式 | ✅泛化好 ❌不可学习 | 原始Transformer |
| Learned PE | 可学习embedding | ✅适应任务 ❌不泛化 | BERT |
| RoPE | 旋转位置编码 | ✅长文本好 | LLaMA |
| ALiBi | 注意力偏置 | ✅超长文本 | MPT |
RoPE简介(LLaMA使用):
# 不是加法,而是旋转
# Q和K乘以旋转矩阵
Q_rot = rotate(Q, position)
K_rot = rotate(K, position)

# 优势: 相对位置信息更明确
# LLaMA-2可处理4K→32K上下文
面试话术:
"Sin/Cos编码的巧妙之处在于:1)不同频率捕捉不同距离 2)可外推到训练时未见长度 3)相对位置可线性表示。现代LLM如LLaMA改用RoPE,在超长文本上表现更好。我们项目用ALiBi,32K上下文零成本扩展。"
五、速记卡片
Transformer 核心概念
| 概念 | 一句话解释 |
|---|---|
| Transformer | 基于自注意力的序列模型,可并行训练 |
| Self-Attention | 每个token关注所有其他token |
| Multi-Head | 多个注意力头捕捉不同关系 |
| Positional Encoding | sin/cos函数注入位置信息 |
注意力机制
| 公式/概念 | 说明 |
|---|---|
| Attention(Q,K,V) | softmax(QK^T/√d_k)V |
| 缩放因子 | √d_k,避免点积过大使 Softmax 饱和 |
| Causal Mask | 上三角mask,生成时只看之前 |
| Cross-Attention | Q来自Decoder,K/V来自Encoder |
BERT vs GPT
| 维度 | BERT | GPT |
|---|---|---|
| 架构 | Encoder only | Decoder only |
| 注意力 | 双向 | 单向(masked) |
| 训练 | MLM + NSP | 自回归LM |
| 任务 | 理解(分类/NER) | 生成(对话/摘要) |
优化技巧
| 技巧 | 效果 |
|---|---|
| Warmup | 稳定训练,先升后降学习率 |
| Label Smoothing | 缓解过度自信;是否有效需按任务验证 |
| Gradient Clipping | 限制梯度范数;阈值是超参数 |
| Mixed Precision | 降低显存/带宽并利用低精度算力;收益依硬件与算子而定 |
| Gradient Accumulation | 模拟大batch,不增显存 |
六、进阶架构:Transformer + SSM 混合模型(Mamba)
Q10: 什么是 SSM(状态空间模型)?它与 Transformer 混合时解决什么问题?
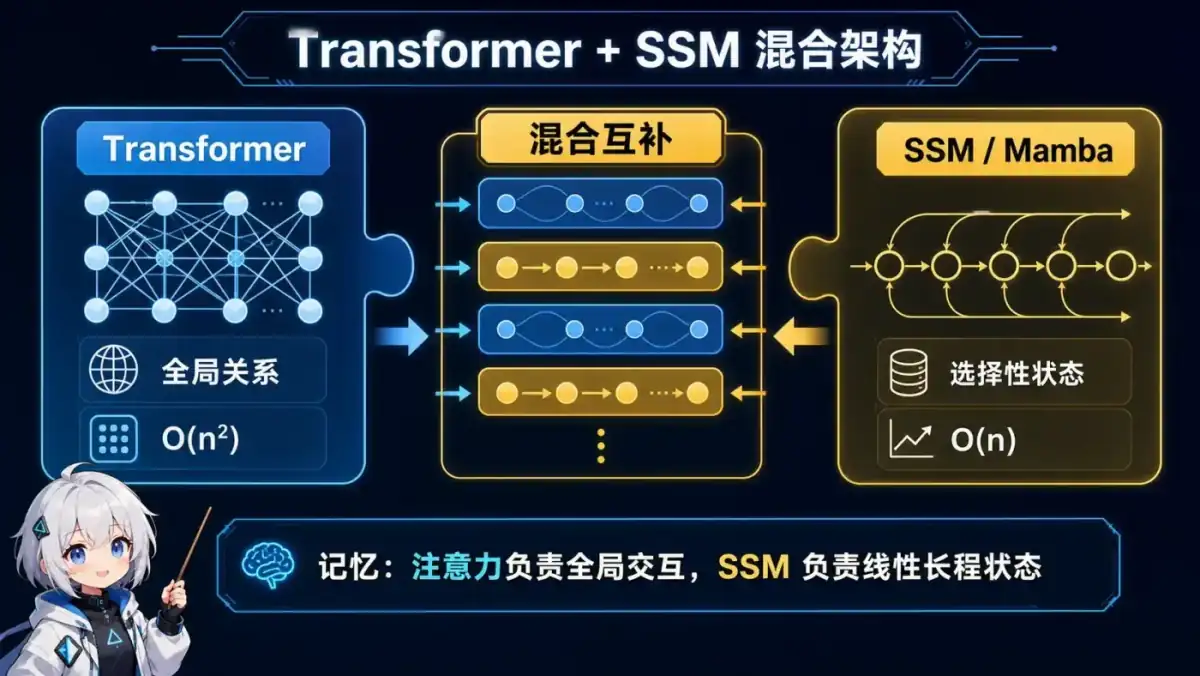
🧠 图解记忆:注意力负责全局交互,SSM 负责线性长程状态;点击图片可查看原图。
💡 答案要点
为什么值得了解:
SSM、Mamba 及注意力/SSM 混合架构是长序列建模的重要研究方向。不要把未公开的闭源模型内部结构当作已确认事实;面试重点应放在计算复杂度、状态压缩、并行训练和信息检索能力的取舍。
SSM(状态空间模型)是什么:
SSM将序列建模视为一个"状态转移系统":
输入序列 x(t) → 状态空间模型 → 输出序列 y(t)
                    ↑
              隐状态 h(t)

核心方程(连续形式):
  h'(t) = Ah(t) + Bx(t)     ← 状态更新
  y(t)   = Ch(t) + Dx(t)    ← 输出生成

离散化后(实际计算形式):
  h_t = Ah_{t-1} + Bx_t     ← 线性 recurrence
y_t = Ch_t| 特性 | Transformer | SSM(Mamba) |
|---|---|---|
| 计算复杂度 | O(n²) 自注意力 | O(n) 线性 recurrence |
| 长序列处理 | 显存瓶颈 | 天然支持长序列 |
| 并行训练 | 容易(矩阵运算) | 需要并行算法优化 |
| 推理速度 | 慢(需要完整注意力) | 快(固定状态转移) |
| 信息访问方式 | 可直接做 token 间内容寻址 | 历史被压入状态,随机回看能力受结构影响 |
Mamba的核心创新:Selection Mechanism(选择性机制)
传统SSM对所有输入用相同的静态矩阵——这和"不根据输入调整"的CNN一样,限制了表达能力。
Mamba的关键洞察:让SSM的参数变成输入的函数
静态 SSM:      h_t = Ah_{t-1} + Bx_t     ← A、B 不变
Mamba(选择性):h_t = A(x_t)h_{t-1} + B(x_t)x_t  ← 输入决定参数

→ 模型能"选择性遗忘"无关信息,"选择性记住"关键信息
→ 类似于LSTM的门控机制,但参数更少
为什么需要Transformer + SSM混合架构:
┌─────────────────────────────────────────────────┐
│          2026年大模型混合架构                    │
├─────────────────────────────────────────────────┤
│  Transformer层:擅长全局注意力                   │
│  → 复杂推理、多跳关系、长距离依赖                │
│  → 瓶颈:O(n²) 显存,n越长越贵                  │
├─────────────────────────────────────────────────┤
│  SSM层:擅长线性长程依赖                         │
│  → 简单模式识别、长程记忆、归纳偏置              │
│  → 瓶颈:表达复杂推理关系不如Transformer        │
├─────────────────────────────────────────────────┤
│  混合结果:                                      │
│  → 降低部分长序列层的计算或状态成本              │
│  → 保留若干注意力层的内容寻址能力                │
│  → 效果、吞吐和延迟仍需按模型与硬件验证          │
└─────────────────────────────────────────────────┘
判断一个混合架构时要问:
| 问题 | 原因 |
|---|---|
| 哪些层使用注意力、哪些层使用 SSM? | 决定全局内容寻址与线性扫描的比例 |
| 训练阶段能否并行扫描? | 理论复杂度不等于硬件实际吞吐 |
| 推理要保存哪些状态? | 决定长上下文显存和每 token 带宽 |
| 在检索、复制、长程依赖任务上表现如何? | 固定大小状态可能形成信息瓶颈 |
面试话术:
"SSM 通过递推状态在线性扫描中压缩历史,避免每层都构造完整的两两注意力;注意力则擅长按内容直接访问上下文。混合架构希望兼顾二者,但不能据此保证质量不降或速度必然更快。我会看层配比、状态大小、训练并行算法,并在长程检索与目标硬件上验证。"
⭐ 面试加分项:
- 能画出Mamba block的结构图(SSM + 线性投影 + 激活函数)
- 理解Mamba的硬件感知并行性(通过并行扫描算法解决recurrence的并行难题)
- 知道SSM和CNN/RNN的本质区别(SSM是连续系统离散化,参数是动态的)
Q11: MHA、MQA 和 GQA 有什么区别?为什么推理系统常用 GQA?
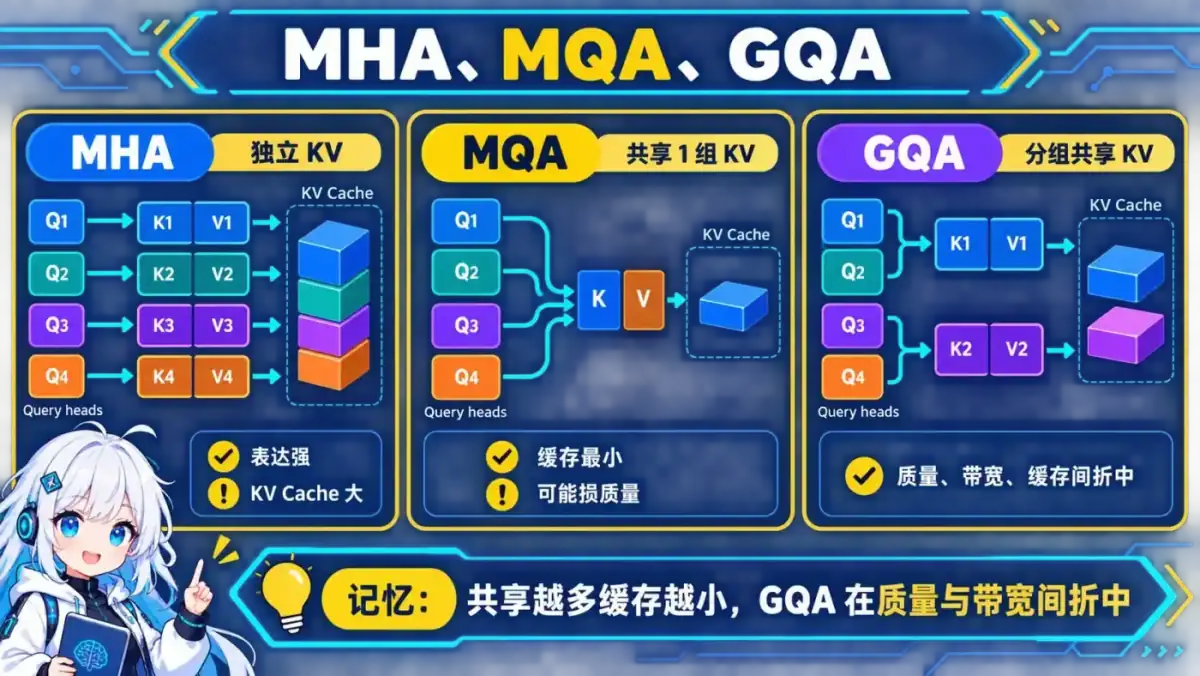
🧠 图解记忆:共享越多缓存越小,GQA 在质量与带宽间折中;点击图片可查看原图。
💡 答案要点
- MHA 为每个 Query head 配置独立的 Key/Value head,表达能力强,但 KV Cache 较大;
- MQA 让所有 Query head 共享一组 Key/Value,显著减少 KV Cache 和内存带宽,可能损失质量;
- GQA 将 Query head 分组,每组共享 Key/Value,是两者之间的折中。
KV Cache 大小与 层数 × 序列长度 × KV head 数 × head_dim × K/V × dtype 近似成正比。选型不能只说 GQA 更快,还要比较模型质量、批量大小、长上下文和硬件带宽。
Q12: Transformer 的 FFN 做什么?SwiGLU 为什么常见?
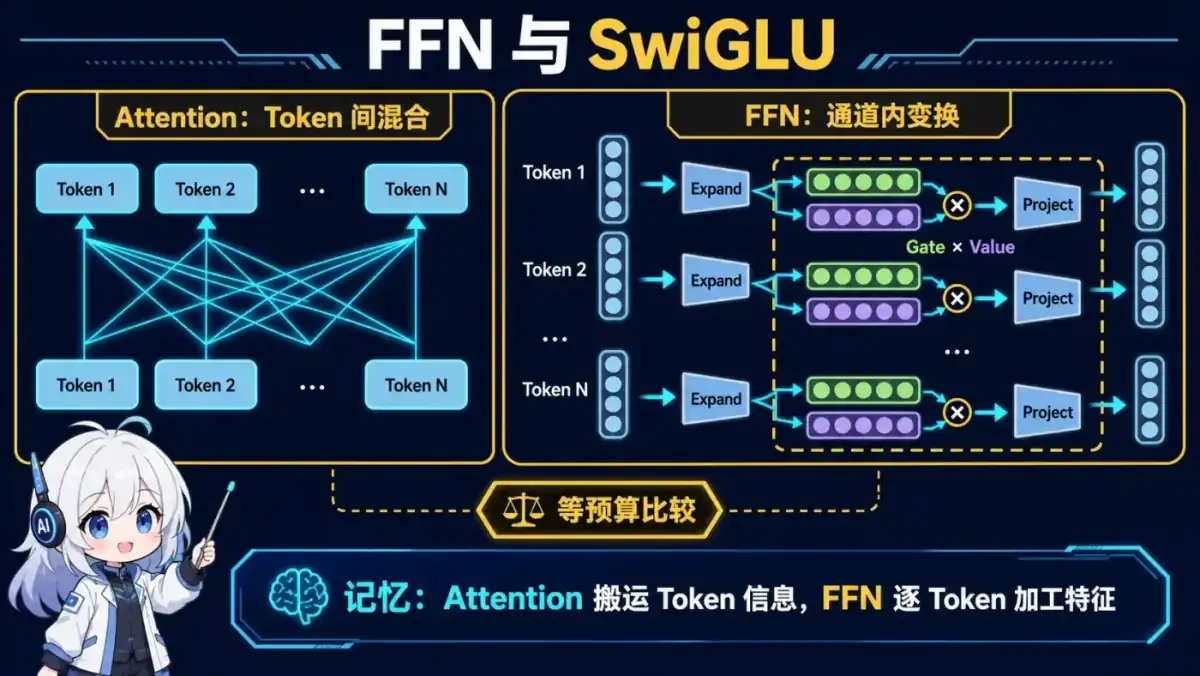
🧠 图解记忆:Attention 搬运 Token 信息,FFN 逐 Token 加工特征;点击图片可查看原图。
💡 答案要点
Attention 在 Token 之间混合信息,FFN 则对每个 Token 的通道维度独立做非线性变换,通常占据模型的大量参数和计算。SwiGLU 使用门控分支控制信息通过,与 ReLU/GELU FFN 相比常能改善训练效果,但参数量和中间维度的比较必须使用等预算设置。
常见追问包括:为什么 FFN 可以逐 Token 并行、门控分支如何计算、MoE 替换的是哪一部分。
Q13: Pre-Norm、Post-Norm 和 RMSNorm 有什么关系?
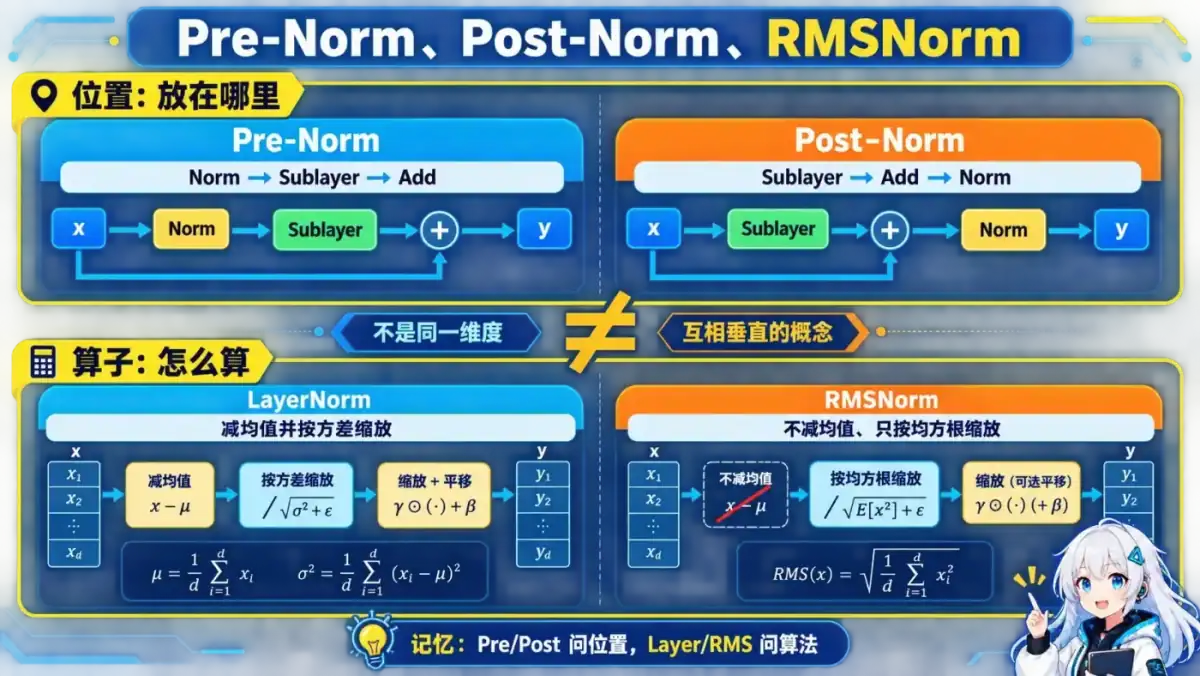
🧠 图解记忆:Pre/Post 问放哪里,Layer/RMS 问怎么算;点击图片可查看原图。
💡 答案要点
Pre/Post 描述归一化在残差分支前还是后;LayerNorm/RMSNorm 描述归一化算子本身,二者不是同一维度。Pre-Norm 通常更容易训练深层网络,因为残差主路径更直接;Post-Norm 是原始 Transformer 形式,但深层训练往往更敏感。RMSNorm 不减均值,只按均方根缩放,计算更简单。
面试中应画出残差公式,并说明训练稳定性结论还受初始化、残差缩放和优化器影响。
Q14: RoPE 长度外推为什么会退化?常见扩展方法如何验证?
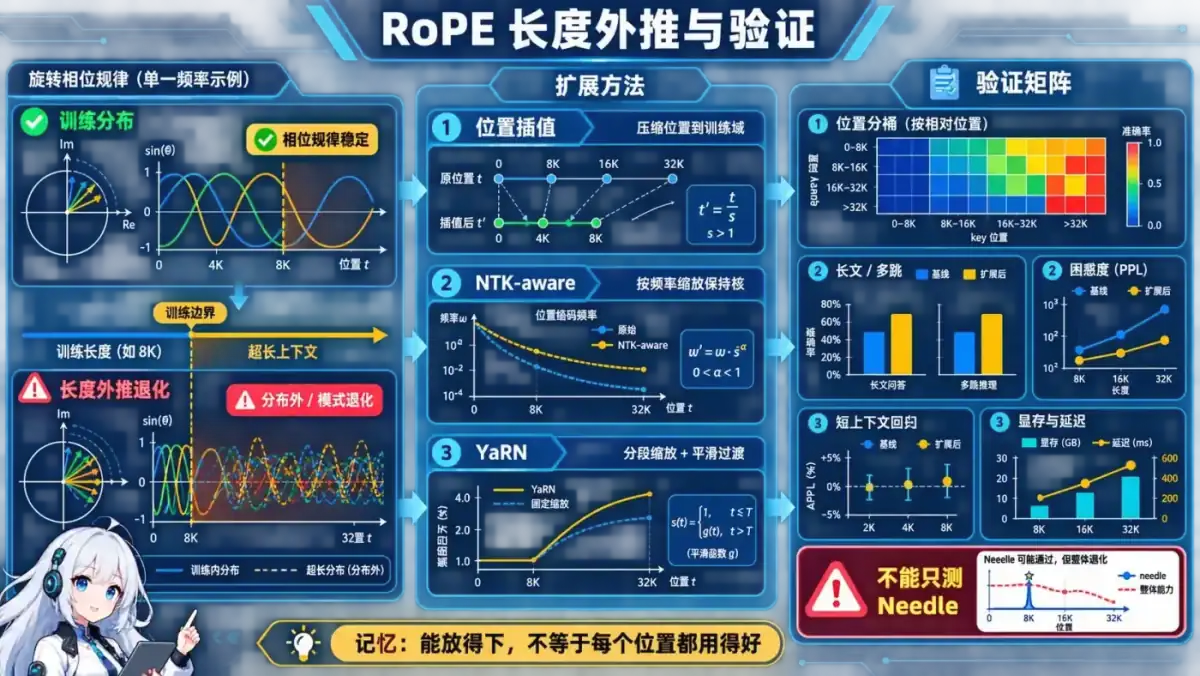
🧠 图解记忆:能放得下,不等于每个位置都用得好;点击图片可查看原图。
💡 答案要点
当推理位置超过训练分布时,旋转频率和相对位置模式发生分布外变化;即使模型接口允许更长上下文,也不代表能稳定利用中间信息。位置插值、NTK-aware scaling、YaRN 等方法通过调整位置或频率降低外推难度,但可能牺牲短上下文表现。
验证不能只做 needle test,还要覆盖长文档问答、多跳检索、位置分桶、困惑度、短上下文回归和显存/延迟。
Q15: FlashAttention 为什么能加速 Attention 计算?核心优化策略是什么?
💡 答案要点
FlashAttention 的核心不是近似 Attention,而是在保持精确结果的前提下减少显存 IO。
传统 Attention 的瓶颈:
标准 Attention 步骤(每步都要读写 HBM):

Step 1: S = QK^T      → 产生 N×N 分数矩阵,写回 HBM  (O(N²) 访问)
Step 2: P = softmax(S) → 读入 S,逐行 softmax,写回 P   (O(N²) 访问)
Step 3: O = PV        → 读入 P 和 V,乘积后写回输出    (O(N²) 访问)

总 HBM 访问量: O(Nd + N²)
问题: N 越大,中间矩阵 S/P 越大,GPU 大部分时间在等内存 IO
FlashAttention 优化思路 — IO-Awareness(感知 IO 的算法设计):
FlashAttention 利用 GPU 的内存层次结构:
  HBM(高带宽慢)→ SRAM(片上快)→ Register(最快但最小)

关键观察:
  - SRAM 容量远小于完整 N×N 矩阵
  - 但单个 block 内的计算完全可以放在 SRAM 中完成
  - 不需要每次都把中间结果写回 HBM
核心优化技术:
1. Tiling(分块计算):
将 Q、K、V 矩阵切分成小 block:
  Q → [Q_0, Q_1, ..., Q_T]     每个 Q_t ∈ R^{n×d}
  K → [K_0, K_1, ..., K_T]     每个 K_t ∈ R^{m×d}
  V → [V_0, V_1, ..., V_T]     每个 V_t ∈ R^{m×d}

逐对计算 (Q_i, K_j, V_j),所有中间结果留在 SRAM
最终一次写入 HBM
2. Online Softmax(在线归一化):
问题:softmax 需要整行的最大值才能数值稳定计算

传统做法: 先求全局 max → 再算 exp(x-max) → 最后除以 sum
FlashAttention: 遍历每个 block 时动态维护
  m = 当前行最大值
  l = 归一化因子 Σexp(x-m)
  O = 未归一化的输出累积

每次遇到新 block 用以下公式增量更新:
  m_new = max(m_old, max_of_block)
  l_new = l_old * exp(m_old - m_new) + sum(exp(block - m_new))
  O_new = O_old * exp(m_old - m_new) + weighted_sum(block_V)

这等价于一次性做完整 softmax,但只用 O(1) 额外空间
3. 重计算(Recomputation)代替缓存:
反向传播时,如果保存完整的中间矩阵会消耗大量激活显存

FlashAttention: 只在正向传递时保存必要的标量统计量
               反向传播时重新计算部分分数和 softmax

成本权衡:
  - 正向多读一次 K/V 从 HBM
  - 省下的激活显存可容纳更大 batch 或更长的序列
复杂度分析:
假设序列长度 n, head 维度 d, SRAM 容量 M (M ≥ d):

标准 Attention 的 HBM 访问次数:
  Forward:  O(n·d + n²)
  Backward: O(n·d + n²)
  总计:     O(n²)

FlashAttention 的 HBM 访问次数:
  Forward:  Θ((n²/M) · n·d)  ← 受限于分块数量
  Backward: 类似

当 n >> √M 时,FlashAttention 显著优于标准实现
实际加速比: 2x~4x(取决于硬件和序列长度)
面试话术:
"FlashAttention 的本质是 IO-aware 设计——让数据尽量留在 SRAM 而不是反复往返 HBM。通过分块计算和在线 softmax,它避免了存储完整的 N×N 注意力矩阵。结果是显存占用大幅下降(可以从 O(N²) 降到接近线性),同时保持了精确注意力结果。在长序列场景下,速度提升可达 2-4 倍。这不是近似算法,而是同一个数学过程的不同组织方式。"
⭐ 面试加分项:
- 能画出 FlashAttention 的分块流程图(外部循环跨 K/V blocks,内部循环处理 Q blocks)
- 理解 online softmax 的增量更新公式推导
- 知道 FlashAttention 2 引入了 persistent kernel 进一步优化
- 了解 FlashAttention 与 KV Cache 配合使用时的效果(推理时同样受益)
Q16: MoE(Mixture of Experts)的原理、收益和工程代价是什么?
💡 答案要点
MoE = 让不同的 token 走不同的专家网络,训练成本低但推理能力随专家数线性增长。
标准 FFN vs MoE-FFN:
标准 FFN(GPT-4、Llama 等):
  每个 token 都经过同一组参数(W1 → Gate → W2)
  参数量 = seq_len × batch_size × (d_ff + d_ff) × 2
  → 每个 token 都要算全部参数

MoE FFN(Mixtral、LLaMA-MoE 等):
  每个 token 只选 Top-K 个专家处理
  参数量 = seq_len × batch_size × num_experts × (d_ff + d_ff) / 路由选择率
  → 总参数多 10 倍,但每个 token 只算 2 个专家
MoE 核心组件:
┌───────────────┐
│ Input Token   │
│ embedding     │
└──────┬────────┘
       ▼
┌───────────────┐
│  Gating Network │  ← 路由决策:哪个 token 去哪些专家
│  Top-K Router   │     通常用带噪声的 softmax
└──────┬────────┘
       ▼
┌───────────────┐    ┌───────────────┐
│ Expert 1 FFN  │◄──►│ Expert 2 FFN  │
└──────┬────────┘    └──────┬────────┘
       ▼                    ▼
┌──────────────────────────┐
│    Weighted Sum + Output  │
└──────────────────────────┘
路由策略详解:
# 典型实现(Top-2 MoE)
class MoERouter(nn.Module):
    def __init__(self, d_model, num_experts, top_k=2):
        self.gate = nn.Linear(d_model, num_experts)
        self.top_k = top_k

    def forward(self, hidden_states):
        # 原始分数
        raw_logits = self.gate(hidden_states)  # (batch, seq, num_experts)

        # 加噪声负载均衡(防止某些专家被独占)
        noise = torch.randn_like(raw_logits) * 0.01
        noisy_logits = raw_logits + noise

        # Top-K 选择
        gates = F.softmax(noisy_logits, dim=-1)
        top_values, top_indices = torch.topk(gates, self.top_k, dim=-1)

        return top_values, top_indices
2026 年主流 MoE 变体:
| 方案 | 特点 | 代表模型 |
|---|---|---|
| Dense Transformer + MoE FFN | 仅 FFN 层做 MoE,attention 保持密集 | Mixtral 8x7B、LLaMA-3.1-405B-MoE |
| Fully Sparse MoE | 多层甚至 attention 也做 MoE | Gemini Ultra |
| Switch Transformer | Top-1 routing,极简路由 | Google 大规模实验 |
| DeepSeek MoE | 共享专家 + 专用专家分离 | DeepSeek-V2/V3 |
MoE 的挑战:
1. 负载均衡(Load Balancing)
   问题:路由器倾向于把样本集中到少数专家
   解决:辅助损失(auxiliary loss)惩罚不平衡
         loss_aux = α × Σ_i f_i × E_i

2. 通信开销(Communication)
   在多 GPU 并行时,token 分散到不同设备上的专家
   需要 All-to-All 通信来路由 token
   解决:专家并行(Expert Parallelism)、分组策略

3. 推理延迟
   Top-2 MoE 意味着每个 token 要运行 2 个专家 FFN
   吞吐量 ≈ 同规模 Dense 模型的 0.5x~0.8x
   但每 token 成本更低(总参数量分摊)
性能对比(相同有效参数量):
| 配置        | 总参数 | 活跃参数 | 每 token 成本 | 吞吐 | 质量 |
|-------------|--------|----------|--------------|------|------|
| Dense 70B   | 70B    | 70B      | 100%         | 100% | 基准 |
| MoE 8×7B    | 56B    | 14B      | 20%          | 60%  | 相当 |
| MoE 64×1B   | 64B    | 2B       | 3%           | 35%  | 略低 |
面试话术:
"MoE 的核心思想是'稀疏激活'——每 token 只经过少数专家。Mixtral 8×7B 有 56B 总参数,但每个 token 只激活 14B,相当于用 1/4 的计算成本获得 8 倍的表达能力。2026 年的主流是'Dense Attention + Sparse FFN'混合模式,兼顾推理效率和训练稳定性。关键在于负载均衡——如果路由器把所有样本都推到几个热门专家,MoE 的优势就没了。"
⭐ 面试加分项:
- 能解释 MoE 的 auxiliary load balancing loss 公式和设计动机
- 理解 expert parallelism 中的 all-to-all 通信模式
- 知道 Switch Transformer(Top-1)vs Top-2 MoE 的区别
- 能讨论 MoE 在推理时的缓存友好性挑战(KV cache 无法复用专家特征)
Q17: KV Cache 显存管理难题?PagedAttention 如何解决?
💡 答案要点
KV Cache 是大模型推理阶段最大的显存瓶颈之一——理解它的管理和优化是生产部署的基本功。
KV Cache 基本原理回顾:
自回归生成时,第 t 步需要用到前 t-1 步的所有 KV 对

朴素做法:每一步重新计算历史 KV
  → 每步 O(t) 计算,总 O(n²)

KV Cache:缓存已生成的 K,V
  → 第 t 步只需要计算当前 token 的 K_t, V_t
  → 第 t 步注意力计算: O(t × d_kv)
  → 总计算: O(n² × d_kv)(仍然是二次但常数小很多)
KV Cache 显存占用计算:
单层 KV Cache 大小 = seq_len × d_kv × dtype_bytes

以 Llama-3-70B 为例(d_model=8192, num_heads=64, d_head=128):
  d_kv_per_head = 128
  KV per layer = 2 × 128 = 256 bytes/head
  总 KV = 256 bytes/head × 64 heads × 80 layers = 1,280 KB/layer
  全模型 KV Cache = 1,280 KB × 64 = ~82 MB/token

实际影响:
  batch_size=64, avg_seq=4096 → 64×4096×82MB ≈ 21 GB
  这就是为什么 vLLM/tensorRT-LLM 必须优化 KV Cache 管理的原因
PagedAttention 的核心思想:类操作系统的虚拟内存分页
传统 KV Cache 的问题(连续分配):
  ┌────────────────────────────────────────┐
  │ Slot 1: token₁...tokenₙᵢ  (碎片!)      │
  │ Slot 2: token₁...tokenₘⱼ  (碎片!)      │
  │ Slot 3: 空闲                            │
  │ Slot 4: token₁...tokenₖₗ  (碎片!)      │
  └────────────────────────────────────────┘
  碎片率高,物理内存不连续导致无法批量合并

PagedAttention(分页管理):
  ┌──────────┐  ┌──────────┐  ┌──────────┐
  │ Block 0  │  │ Block 1  │  │ Block 2  │
  │ (物理页)  │  │ (物理页)  │  │ (物理页)  │
  └────┬─────┘  └────┬─────┘  └────┬─────┘
       │              │              │
  ┌────▼─────┐  ┌────▼─────┐
  │ Seq A    │  │ Seq B    │
  │ Block 0  │  │ Block 1  │
  │ Block 2  │  │ Block 0  │
  └──────────┘  └──────────┘
  → 逻辑上不连续的序列可以复用物理页
  → 零碎片
PagedAttention 的关键数据结构:
Block Table(块表):每 sequence 独立维护
  Sequence A: [Block₀, Block₂, Block₅, Block₇]
  Sequence B: [Block₁, Block₀, Block₃]

Block Size(块大小):
  通常设为 16~32 个 token
  太小 → 块表过大;太大 → 碎片浪费
  vLLM 默认 16 tokens

KV Memory Pool(统一显存池):
  预分配固定大小的物理块
  按需分配到 sequence → 类似 RAM 分配
  支持 dynamic batching(动态批处理)
PagedAttention vs 传统方法对比:
| 特性            | 传统分配    | PagedAttention     | vLLM 实际收益     |
|-----------------|------------|--------------------|------------------|
| 显存利用率      | ~60%(碎片)| ~95%+             | 吞吐提升 2-4x    |
| max_batch_size  | 受限于连续块| 无硬性上限         | 可大幅调大       |
| 调度灵活性      | 静态       | 动态插队/换出      | 自适应调度       |
| 并发用户数      | 少         | 多(逻辑隔离)     | 多租户友好       |
进阶:KV Cache 的其他优化方向
1. FP8 KV Cache:压缩半精度 → 显存减半
2. KV Cache 量化:INT4/KV Quantization → 更多上下文
3. Sliding Window KV:只保留最近 N 个 token → 适合长对话
4. Compressed KV:如 DeepSpeed-Ulysses 的梯度压缩式策略
5. Offloading:把冷 KV 交换到 CPU 或 NVMe(牺牲延迟换空间)
面试话术:
"KV Cache 是自回归推理的'账本'——每生一个 token 就把它的 K 和 V 存起来供后续使用。问题是它占显存太多,尤其在大 batch 或多用户场景下。PagedAttention 借鉴操作系统分页的思想,把 KV 切成固定大小的 block,逻辑上不连续的序列可以复用相同的物理块,消除了碎片。vLLM 就是基于这个实现了高达 24x 的吞吐提升。"
⭐ 面试加分项:
- 能用具体数字估算不同模型规模的 KV Cache 显存
- 理解 block table 和 memory pool 如何协作
- 知道 PagedAttention 与传统连续分配的性能差异数据
- 了解 KV Cache 量化、offloading 等其他优化手段的 trade-off
Q18: SwiGLU、GLU 和标准 FFN(ReLU/GELU)在 FFN 中的门控机制有什么不同?
💡 答案要点
Gate 机制的本质:让网络"选择性通"信息,而不是对所有输入一致地变换。
三种 FFN 方案对比:
1. 标准 FFN(ReLU/GeLU)—— 最早的方案
   Hidden = Activation(X @ W1) @ W2

   X: (batch, seq, d_model) → W1: (d_model, d_ff) → (batch, seq, d_ff)
                                ↓ ReLU/GeLU
                              → W2: (d_ff, d_model) → (batch, seq, d_model)

   问题:所有输入维度都受到同样的非线性变换
   没有"门"的概念,不能动态控制信息流

2. GLU(Gated Linear Unit)—— 引入门控概念
   Hidden = SiLU(X @ W_gate) ⊙ (X @ W_project) @ W_out

   X @ W_gate:  生成门的信号(sigmoid/silu 输出 0~1)
   X @ W_proj:  要过滤的信号
   ⊙: 逐元素相乘 —— 门为 0 则对应维度完全关闭

   好处:通道级选择性地激活
   注意:W_gate 和 W_proj 各需要一半 d_ff 的容量

3. SwiGLU(SiLU + GLU)—— 当前最优
   Hidden = SiLU(X @ W1) ⊙ (X @ W2) @ W3

   SiLU(x) = x · sigmoid(x)  (Softplus 的平滑版本)

   为什么 SwiGLU 通常比 GeLU-FFN 更好?
   ✓ 门控机制提供更强的非线性表达能力
   ✓ 通道级别的门控让重要特征不被淹没
   ✓ 相比 GeLU 有稍微更好的梯度流动
   ✗ 参数量增加约 50%(3 个矩阵 vs 2 个)
   ✗ 计算量基本相同(矩阵乘法主导)
参数量和计算量对比:
假设 d_model=4096, d_ff=11008(LLaMA-3 比例 d_ff≈2.67×d_model)

标准 GeLU-FFN:
  W1: 4096×11008 = 45.1M 参数
  W2: 11008×4096  = 45.1M 参数
  总计: 90.2M 参数

SwiGLU-FFN:
  W1 (gate): 4096×11008 = 45.1M 参数
  W2 (proj): 4096×11008 = 45.1M 参数
  W3 (out):  11008×4096 = 45.1M 参数
  总计: 135.3M 参数

相对增加: 50%
但实际训练中 SwiGLU 通常能达到更好的收敛和质量
现代 LLM 的 FFN 设计趋势:
| 模型            | FFN 激活    | d_ff/d_model | Gate?   |
|----------------|-----------|---------------|---------|
| GPT-2          | GELU      | 4.0           | No      |
| GPT-3          | GELU      | 4.0           | No      |
| LLaMA 1/2      | SwiGLU    | 2.67          | Yes     |
| LLaMA-3        | SwiGLU    | 2.67          | Yes     |
| Mistral 7B     | SwiGLU    | 2.67          | Yes     |
| Gemma 2        | SwiGLU    | 2.67          | Yes     |
| Yi系列         | SwiGLU    | 2.67          | Yes     |

趋势:SwiGLU 已成为 2024-2026 年几乎所有主流 LLM 的标准配置
追问:MoE 场景下 SwiGLU 用在哪儿?
MoE 中通常 SwiGLU 替换的是 FFN 内部的激活函数

Sparse MoE-FFN:
  For each token:
    experts_selected = router(x)  # Top-2
    output = Σ g_i × SwiGLU_Expert_i(x)
                        ↑
                   每个专家的 FFN 都用 SwiGLU

即 SwiGLU 替代的是标准 FFN 的激活函数,MoE 替换的是 FFN 的整体结构(单一路径 → 多路径选择)
两者作用在不同层面,可以同时组合
面试话术:
"标准 FFN 用单一激活函数(GeLU/ReLU)做非线性变换,所有输入通道同等对待。GLU 引入门控:先用一部分权重生成门信号(sigmoid/silu),再和另一部分投影结果逐元素相乘,实现通道级的选择性滤波。SwiGLU 是用 SiLU 作为激活的门控 GLU,是目前最流行的配置。它比 GeLU-FFN 多了约 50% 的参数,但因为门控让信息流动更有选择性,实际训练效果更好。几乎所有现代 LLM 都采用 SwiGLU。"
⭐ 面试加分项:
- 能画出三种 FFN 的完整计算流程(含矩阵维度变化)
- 理解 SiLU 相对于 Sigmoid/ReLU 的优势(非饱和区更大、过零点非零)
- 知道 SwiGLU 的参数量是标准 FFN 的 1.5 倍,但计算量几乎不变
- 能解释 MoE 和 SwiGLU 的关系(它们分别在结构层和激活函数层起作用)
Q19: MLA(Multi-Latent Attention)是什么?为什么 DeepSeek v3 用它替代 GQA?
💡 答案要点
MLA 是 DeepSeek 提出的新一代注意力范式——用低秩分解替代传统的独立 Q/K/V 投影。
GQA 仍然存在的冗余:
GQA 的改进思路:多个 Query head 共享一组 KV head
但本质上是独立的投影矩阵:
  W_Q[i]: d_model → d_head  (独立学习)
  W_K[v]: d_model → d_head  (独立学习)
  W_V[v]: d_model → d_head  (独立学习)

冗余之处:
  每个 head 的 Q/W/Q 都是独立的 d_model × d_head 矩阵
  但这些投影之间可能有高度相关性(都在学类似的注意力映射)
  → 有没有办法"共享知识"同时又能"区分任务"?
MLA 的核心创新:低秩分解 Q/K/V 投影
传统多头注意力(MHA/GQA):
  W_Q: (num_heads × d_head, d_model)     ← 独立大矩阵
  W_K: (num_kv_heads × d_head, d_model)  ← 独立大矩阵
  W_V: (num_kv_heads × d_head, d_model)  ← 独立大矩阵

MLA(Multi-Latent Attention):
  第一步:共同压缩
    C_c: (d_model, d_comp)    ← 共同压缩矩阵 (小!)
    c = C_c @ x               把 x 压缩到低维 latent space

  第二步:解耦展开
    W_Q_h: (num_heads × d_head, d_comp)  ← 按头拆分
    W_K_v: (num_kv_heads × d_head, d_comp) ← 按 KV group 拆分
    W_V_v: (num_kv_heads × d_head, d_comp) ← 按 KV group 拆分

  Q_h = W_Q_h @ c
  K_v = W_K_v @ c
  V_v = W_V_v @ c
MLA 与传统方式的对比:
假设 d_model=8192, num_heads=64, d_head=128, num_kv=8, d_comp=512

传统 GQA 的 KV 投影矩阵大小:
  W_K: (8 × 128, 8192) = (1024, 8192) = 8.4M 参数
  W_V: (8 × 128, 8192) = (1024, 8192) = 8.4M 参数

MLA 的 KV 投影矩阵大小:
  压缩: C_kv (512, 8192) = 4.2M 参数
  展开: W_K_v (8×128, 512) = 0.52M 参数
  展开: W_V_v (8×128, 512) = 0.52M 参数
  总计: 5.2M 参数

节省: (16.8M - 5.2M) / 16.8M ≈ 69% 的 KV 投影参数!
KV Cache 的巨大优势:
MLA 的 KV Cache 只有低维 latent 向量 c_v
  而非高维的 K_v 和 V_v

KV Cache 大小对比:
  GQA:  层数 × seq_len × num_kv × d_head × 2 × bytes  (如前面计算的 ~82MB/token)
  MLA:  层数 × seq_len × d_comp × 1 × bytes            (仅存储压缩后的 c_v)

MLA 可以将 KV Cache 压缩到原来的 1/10~1/5
这意味着:
  ✓ 同样的显存可以支持更长上下文
  ✓ 同样的上下文可以支持更大 batch size
  ✓ 长文本推理成本大幅降低
MLA 的完整推理流程:
推理时每步的新 token 处理:
  x_new → C_c (压缩) → c_v (低维 latent) → 存入 KV Cache

生成下一个 token:
  c_cache (全部历史的 latent) → W_V_v (展开) → V_cache
  x_new  → C_c (压缩) → c_q (query latent) → W_Q_h (展开) → Q_new

注意力: Softmax(Q_new @ K_cache^T / √d) @ V_cache

关键点:K_cache 也是由 c_cache 经 W_K_v 展开得到的
         所以 KV Cache 只需要存 c_v,不用存展开后的 K/V!
为什么 DeepSeek v3 选择 MLA:
Trade-off 分析:

MLA 优点:
  ✓ KV Cache 缩减 5-10x → 长上下文和大批量更易实现
  ✓ KV 投影参数减少 ~70% → 模型更紧凑
  ✓ 低秩表示天然有正则化效果

MLA 缺点:
  d_comp 太小有表达能力瓶颈(经验值 512-1024 比较安全)
  需要额外的 C_c 和 W_h/v 矩阵训练
  理论上可能不如独立投影灵活(受限的秩)

结论:在追求长上下文和高效推理的场景下,MLA 的 trade-off 非常值得。
       DeepSeek 实测发现 d_comp=512 时对性能影响微乎其微
MLA vs GQA 总结对比:
| 维度        | GQA                 | MLA                     |
|-------------|--------------------|------------------------|
| KV Cache    | 中高                | 极低(低秩压缩)        |
| 参数效率    | 中                 | 高(参数减 70%)       |
| 表达能力    | 高(独立投影)      | 中-高(受 d_comp 限制) |
| 实现复杂度  | 低                  | 中                     |
| 适用场景    | 通用推理            | 长上下文、大批量场景    |
| 代表模型    | Llama-3.1 等      | DeepSeek-V3            |
面试话术:
"MLA 的核心思想是把 Q/K/V 投影做低秩分解——先用一个共同的压缩矩阵把高维嵌入降到低维 latent,再分别展开成 Q/K/V。这样做的好处是 KV Cache 可以直接存低维 latent,不用存展开后的高维张量,从而把 KV Cache 压缩到原来的十分之一左右。DeepSeek V3 选择 MLA 不是为了刷指标,而是为了在有限的显存下跑更长的上下文和更大的 batch。理论上有微小的表达能力折损,但实践证明 d_comp=512 足够用。"
⭐ 面试加分项:
- 能手推 MLA 的矩阵维度变化(特别是低秩分解的形状)
- 理解为什么 KV Cache 只需存 c_v 而不用存 K_v/V_v
- 能定量估算 MLA 带来的 KV Cache 节省比例
- 知道 d_comp 的选择对表达能力的 trade-off
| 日期 | 版本 | 更新内容 |
|---|---|---|
| 2026-09-29 | v3.137 | 新增 Q27-Q31(Speculative Decoding原理与工程实践、Attention Sink现象与缓解、FlashAttention-3异步并行与低精度、Linear Attention线性注意力原理、Self-Attention与FFN计算量对比分析)5 道 |
| 2026-08-21 | v3.136 | 新增 Q20-Q26(Scaling Laws&Chinchilla、Tokenization/BPE、ALiBi详解、Sliding Window Attention、Causal Decoder-Only主导原因、LayerNorm vs RMSNorm、训练Loss Curve诊断)7 道 |
| 2026-04-13 | 新增 Q10 Transformer+SSM混合架构(Mamba核心原理、2026年主流模型混合策略) | |
| 2026-03-05 | 新增 Transformer 架构与注意力机制面试题 7 道 |
Q20: Scaling Laws 是什么?Chinchilla 的 "compute-optimal" 意味着什么?
🧠 图解记忆:算力和模型一起放大,损失按幂律下降;别只堆参数不喂数据。
💡 答案要点
Scaling Laws = 模型能力随规模变化的经验规律
Loss(N, D, C) ~ a + b * N^(-alpha) + c * D^(-beta)
其中:N=参数量, D=训练 token 数, C=FLOPs~6ND*L 关键结论:alpha > beta → 增加数据比增加参数更有效降低 Loss
Chinchilla 的核心发现(面试必考): 传统做法:给定算力→选大模型→有限数据训练(欠训练) Chinchilla:给定算力→适中N+足够大的D,最优配比~20个token/参数 Chinchilla 70B 训练 1.4T tokens(20:1),超过 PaLM 62B
| 偏离方向 | 表现 | 解释 |
|---|---|---|
| N太大D太小 | Loss平台期明显 | 有容量但没见过足够模式 |
| N太小D太大 | 后期Loss几乎不降 | 已达表示能力天花板 |
| 偏离 < 2x optimal | 影响可控 | 数据质量优先 |
| 偏离 > 5x optimal | 显著低于预期 | 必须重新分配 |
注意事项:MoE需修正(active vs total params)、inference-aware scaling考虑延迟后最优偏小、高质量文本接近耗尽时需合成数据。
面试话术:
"Scaling Laws 告诉我们损失呈幂律下降。Chinchilla 量化了'欠训练'现象——之前的团队给太多参数却喂太少数据。对固定算力预算,最优方案是让参数量和token数同步增长,约20:1比例。我们应该造小一点但吃饱的模型。"
Q21: Tokenization 方法有哪些?BPE、WordPiece、SentencePiece 有什么区别?
🧠 图解记忆:字符不怕没见过的词,但句子太长塞不下上下文。
💡 答案要点
三种主流方法的本质区别:
- Character Level: r-u-n-n-i-n-g (7tokens, no OOV, long seq)
- Word Level: running (1token, high OOV, short seq)
- Subword Level: run+ing (2tokens, low OOV, medium seq)
1. BPE(Byte-Pair Encoding): 初始化词汇表→统计相邻pair频率→合并最高频pair→重复直到目标vocab size。 Byte-level BPE从UTF-8 byte起步,任何Unicode文本都不会OOV。 代表模型:GPT-2/3/4 (tiktoken), RoBERTa
2. WordPiece: 合并能使语言模型likelihood提升最多的pair→max likelihood。 代表模型:BERT、DistilBERT(vocab:30K,用##标记连续子词)
3. SentencePiece: tokenizer框架而非算法。内部实现Unigram(首选)、BPE等。将标点视为普通字符。 Unigram LM思路:从大候选集迭代去掉最低概率20%直到等于目标大小。 代表模型:T5、LaMDA、PaLM、Gemini系列
Vocab Size选择权衡: | Vocab Size | 优点 | 缺点 | 典型应用 | |-----------|------|------|---------|| | 32K (LLaMA) | 容纳更多token | 罕见词被拆散 | LLaMA家族 | | 50K (GPT-2) | 中英混合好 | 显存略增 | GPT-2/3 | | 100K (GPT-4) | 复杂词直接映射 | 更大embedding | GPT-4 |
多语言挑战: CJK一个汉字占3bytes→序列膨胀2-3x→浪费KV Cache。 应对:①为每种语言单独训练tokenizer ②扩大vocab size
面试加分项: BPE is adaptive computation、tiktoken O(1)查找、CJK序列膨胀问题
面试话术:
"Tokenization的本质是在OOV风险和序列长度之间找平衡。BPE通过迭代合并高频pair构建子词vocab。Byte-level BPE从根本上消除了OOV。但CJK语言会遇到序列膨胀(一个汉字变3-5个byte token)。目前主流模型多在32K-100K之间选取vocab size。"
Q22: ALiBi(Attention with Linear Biases)的工作原理?为什么它能零样本外推?
🧠 图解记忆:不在embedding加位置信息,直接在attention score上加距离罚分。
💡 答案要点
核心思想:不用位置编码,用线性衰减代替
Sinusoidal/Learned PE把位置加法注入token;RoPE旋转Q/K让dot携带相对位置;ALiBi直接修改注意力分数。
ALiBi注意力:softmax(QK^T/sqrt(d) + m_h * |pos_i - pos_j|) m_h < 0是每个head的负斜率系数(最近的头衰减最陡看最近邻居,远的头衰减最缓看远距离)。
公式:m_h = -8^
为什么能零样本外推? Bias只依赖RELATIVE position(pos_i-pos_j),不依赖ABSOLUTE position!训练时pos在[train_len]范围,推理时在[infer_len]范围,任意两个token间的relative distance和bias值都保持不变→不需要微调就能处理更长序列。
| 特性 | ALiBi | RoPE(+NTK/YaRN) | Sinusoidal | Learned |
|---|---|---|---|---|
| Zero-shot外推 | 原生支持 | 需缩放技巧 | 差 | 无定义 |
| 微调后外推极限 | ~8-16x | ~32x+(YaRN) | ~2x | N/A |
| 额外参数 | 0 | 0 | 0 | 需学习 |
| 短上下文 | 略弱于RoPE | 优秀 | 中等 | 优秀 |
| 代表模型 | MPT,BLOOM | LLaMA,Mistral | 原始Transformer | BERT |
| 复杂度 | 极低 | 中 | 低 | 低 |
局限性:缺乏绝对位置感知、短上下文略逊RoPE、强locality prior对跨极远距离精确对齐不利。
面试加分项: 写出斜率公式m_h=-8^{-4h/d}、ROPE+YaRN外推超ALiBi(32x+vs8-16x)
面试话术:
"ALiBi完全不改动token embedding,而是在注意力分数上直接加与距离成正比的负偏置。因为偏置只依赖相对距离而非绝对位置,所以可以直接处理比训练时长更久的序列——zero-shot外推。代价是缺少绝对位置感,短上下文略逊RoPE。2026年更多长上下文模型选了RoPE+YaRN组合获得更强外推能力。"
Q23: Sliding Window Attention(滑动窗口注意力)是什么?它解决了什么问题?
🧠 图解记忆:注意力不再是全局两两交互,而是限制在滑动窗口内,节省计算且支持超长序列。
💡 答案要点
Sliding Window Attention = 限制每个token只能关注前后固定窗口内的token
标准Self-Attention的问题(长序列L很大时):
- 计算量O(L²×d)、显存O(L²)、KV Cache O(L×d)
- L=128K时注意力矩阵=1.6×10^10 entries≈32GB仅FP16存储
Sliding Window解决方案:O(L×window_size×d)→从O(L²)降到O(L)
现代实践:交错滑动窗口+全局层 纯滑动窗口缺陷:感受野永远受限。解决:交替使用SW层和全局层。
GEMMA2模式(4B/9B):Layer1-SW(4K)→Layer2-Global→Layer3-SW→Layer4-Global→每两层一次全局交互。 Mistral3系列:Layer1-5-SW(4K)→Layer6-Global→Layer7-11-SW→Layer12-Global→5:1比率。
| 方案 | 复杂度 | 表达能力 | 代表模型 |
|---|---|---|---|
| Full Attention | O(L²) | 最强 | 小序列场景 |
| Sliding Window | O(L×W) | 中等,需全局辅助 | Gemma2,Mistral3 |
| N-Tile/Strided | O(L) | 层越多感受野越大 | Longformer |
| SSM/Mamba | O(L) | 互补路线 | Mamba,Jamba |
优势:长序列推理成本低、硬件友好。 劣势:无法不经全局层做端到端长程跳跃。
面试加分项: 解释为什么纯SW不够需要全局层、Gemma2奇偶层交替vs Mistral3的5:1分组
面试话术:
"Sliding Window是一种稀疏注意力——每个token只看前后固定数量的前驱token。这让复杂度从O(L²)降到O(L×W),大幅节省了计算和KV Cache。但纯SW感受野永远受限,所以主流做法是每隔若干层插一个全局attention层,比如GEMMA2是奇偶层交替,Mistral3是5层SW后跟1层全局。这样既能控制计算量又保持长程建模能力。"
Q24: 为什么 2026 年的主流 LLM 全部转向 Causal Decoder-Only 架构?
🧠 图解记忆:单一架构通吃所有任务,统一比分裂更高效。
💡 答案要点
架构演化简史:
2017: Encoder-Decoder → 机器翻译
  +-- Encoder-only (BERT,2018) → NLU称霸
  +-- Decoder-only (GPT,2018) → 文本生成
2020: GPT-3展示scaled-up Decoder-only超越BERT
2022-至今: Decoder-Only全面接管
  LLaMA→Mistral→Qwen→Gemma→Yi→全Decoder-only
五大核心原因:
- 统一架构=统一训练:同一个模型一个prompt覆盖分类/摘要/QA/对话,只需维护一套参数
- 自回归训练的免费并行信号:一次forward就获所有位置的监督信号,不需要MLM特殊mask或NSP第二句话任务
- In-Context Learning天然载体:causal mask决定了单向推进模式,非常适合few-shot learning
- 推理效率优势(流式输出):Pre-fill并行计算KV Cache,Decode串行逐token生成速度快
- 多模态扩展兼容性:所有模态拼成一条序列用同一decoder处理,GPT-4o/Claude/Gemini都走这条路
面试加分项: GPT-3是Decoder-only超越BERT转折点、理解多模态融合的统一性优势
面试话术:
"Decoder-Only之所以成为绝对主流,核心原因是统一——同一个模型用同一个预训练目标覆盖所有任务。加上in-context learning天然适合因果解码、流式体验好、多模态需要一个统一的序列容器,三个优势叠加导致行业加速converged到decoder-only。"
Q25: LayerNorm 和 RMSNorm 有什么区别?为什么现代 LLM 普遍改用 RMSNorm?
🧠 图解记忆:LayerNorm做完整的标准化,RMSNorm去掉均值只留尺度归一化。
💡 答案要点
核心区别:是否减去均值
LayerNorm(Ba et al.2016): mu=mean(x), sigma2=var(x) LayerNorm(x)=gamma*(x-mu)/sqrt(sigma2+eps)+beta
RMSNorm(Zhang&Sennrich,2019): RMS(x)=sqrt(mean(x^2)+eps) RMSNorm(x)=gamma*x/RMS(x)
LayerNorm: mean subtraction+可学习bias beta RMSNorm: 无mean subtraction+无可学习bias beta,只保留scale gamma
为什么去掉均值反而够用? Mean centering对梯度流动贡献很小,Scale normalization才是关键。去掉mean后训练稳定性和收敛速度几乎不变,用15%计算节省换95%+效果。
计算效率: LayerNorm约5x元素操作,RMSNorm约3x→节省40%元素操作,实际收益10-15%运行时间。
Adoption Timeline: 2019提出→Gopher首次采用→2022+:LLaMA,Mistral,Gemma,Qwen,Yi全部RMSNorm
QK-Norm的使用场景: 不同于LayerNorm/RMSNorm(对整个hidden state归一化),QK-Norm只在attention内部对Q和K向量做归一化以稳定注意力分数。代表:Qwen系列默认启用。
什么时候还用LayerNorm? 传统NLP任务(BERT)、迁移已有预训练检查点时、教育场景。但在从头训练的新模型上,2026年几乎没有理由选LayerNorm了。
面试加分项: RMSNorm被LLaMA/Mistral/Gemma全系列采用、了解QK-Norm与Pre-LN正交
面试话术:
"RMSNorm和LayerNorm的核心区别是RMSNorm不去减均值也不加偏置。实践中归一化的核心作用是控制尺度而减均值收益有限。RMSNorm省去约40%的元素操作推理加速10-15%,无数实验验证不会牺牲质量。从LLaMA到Mistral到所有主流2024-2026模型都用了RMSNorm替代LayerNorm。"
Q26: Transformer 的训练过程中 Loss Curve 会出现哪些典型阶段?如何诊断?
🧠 图解记忆:Loss曲线不只是单调下降——平台期后可能有相变骤降。
💡 答案要点
四个典型阶段:
Log Loss
  |
  | H              Phase 4: Fine exploration(loss波动很小)
  |  HH        __ _ _ _ _ _ _ _ _ _ _
  |   HHH    __
  |    HHH   _                  Phase 3: Phase transition(骤降0.1-0.3nats)
  |     HHH  | plateau
  |      HHH |
  |       HHH|
  |        HHH__
  |         HHH|
  |          HHH___ jump
  |           HHH____
  |            HHH    Phase 2: Plateau(缓慢阶梯状下降)
  |             HHH
  |              HH               Phase 1: Rapid descent(急速下降2-4nats)
  |               H
  +-------------------------------------> Training Steps
Phase 1: Rapid Descent(快速下降期) Step 0~10K,Loss急速下降2-4 nats。模型学token prob基本分布,高频ngram被记住。不降则查LR和数据。
Phase 2: Plateau(平台期) Step 10K~数十万步,Loss缓慢阶梯状下降。学语法结构和常见短语。不要恐慌——这是预期的。
Phase 3: Phase Transition(相变/骤降) 中后期几十万到百万步,出现明显阶梯式下降(drop 0.1-0.3 nats)。Emergence现象——逻辑推理、数学等新能力突然涌现。
Phase 4: Fine Exploration(细粒探索期) 接近训练结束,Loss波动±0.01nats逼近渐近线。Train≈Val→正则化良好。
常见异常及对策:
| 现象 | 可能原因 | 对策 |
|---|---|---|
| Loss不降 | LR太小/梯度消失/数据损坏 | 检查LR/gradient clipping |
| Loss震荡 | LR太大/batch太小 | 降LR或增大batch |
| Train>>Val | Overfitting | 加强dropout |
| 多次骤降 | 数据mix变化 | 正常现象 |
面试加分项: 画出四阶段loss curve、phase transition与emergent capabilities关系
面试话术:
"LLM的训练loss曲线不是简单单调下降,它有四个阶段:快速下降、平台期、相变骤降、细粒探索。最关键的是phase transition——loss会在某个点突然掉一大截,对应从零散知识到系统理解的飞跃。最重要的是不要因为平台期恐慌,那只是暴风雨前的宁静。"
Q32: Residual Connection(残差连接)为什么能解决深层网络梯度消失?数学本质是什么?
🧠 图解记忆:残差不是装饰——它保证了前后向信息都能无损直达;点击图片可查看原图。
💡 答案要点
Residual Connection 不是简单的"跳过一层",它是梯度流的保证机制。
前向传播分析:
标准网络(深度 L 层):
  x₀ → f₁(x₀) → f₂(f₁(x₀)) → ... → f_L(...)

  → 每次变换都可能压缩或扭曲表示空间
  → 信息随层数加深逐渐丢失

带残差的网络:
  x₀ → x₁ = x₀ + f₁(x₀)
     → x₂ = x₁ + f₂(x₁) = x₀ + f₁(x₀) + f₂(x₁)
     → ...
     → x_L = x₀ + Σᵢ fᵢ(xᵢ₋₁)

  → 每一层的输出都保留了之前所有层的累积信息
  → 深层可以"看到"浅层的全部内容
反向传播的数学证明(核心面试点):
考虑深度为 L 的网络,最后一层的损失为 ℒ。

标准网络的反向链式法则:
  ∂ℒ/∂x₀ = ∂ℒ/∂x_L · ∂x_L/∂x_{L-1} · ... · ∂x₁/∂x₀
         = ∂ℒ/∂x_L · ∏ᵢ Wᵢ

→ 如果 ‖Wᵢ‖ < 1,乘积随 L 指数衰减 → 梯度消失
→ 如果 ‖Wᵢ‖ > 1,乘积随 L 指数增长 → 梯度爆炸

残差网络的反向:
  x_l = x_{l-1} + f(x_{l-1})
  → ∂x_l/∂x_{l-1} = I + ∂f/∂x_{l-1}

  ∂ℒ/∂x₀ = ∂ℒ/∂x_L · ∏ₗ (I + ∂fₗ/∂xₗ₋₁)

关键洞察:
  - I(单位矩阵)保证至少有一条完整通路
  - 即使每个 ∂fₗ/∂xₗ₋₁ 很小或很大,I 始终是稳定的基底
  - 梯度不会因连乘而消失或爆炸
  - 这解释了为什么 ResNet 能训练 1000+ 层
实际影响(实验数据):
无残差 | 有残差
-------|-------
18 层: 收敛      | 18 层: 快速收敛
100 层: 不收敛   | 100 层: 良好收敛
1000 层: 无法训练 | 1000 层: 可训练
梯度范数 | 1e-8    | 1e-3
        | (完全消失) | (稳定流通)
在 Transformer 中的应用:
# Transformer 中有两组残差连接

class TransformerLayer(nn.Module):
    def forward(self, x):
        # 第一组:残差注意力
        attn_out = self.self_attention(x)
        x = x + self.dropout(attn_out)  # 残差连接
        x = self.norm1(x)

        # 第二组:残差 FFN
        ffn_out = self.ffn(x)
        x = x + self.dropout(ffn_out)  # 另一条残差通路
        x = self.norm2(x)

        return x

# 两条残差通路意味着梯度有两条独立的路径回溯到输入
# 这使 Transformer 能训练更深(通常 6-96 层)
常见追问:
- "Pre-Norm 和 Post-Norm 中残差的位置有什么区别?" → 见 Q13
- "如果没有残差,能否用其他方法替代?" → Group Norm 或其他归一化只能改善但不如残差直接
- "残差连接的参数量是多少?" → 零参数,只是恒等映射 I
面试话术:
"残差连接的本质是通过恒等映射保证梯度的畅通——前向信息累加而非替换,反向梯度沿单位矩阵通道无损回流。这就是为什么 ResNet 能训练 1000+ 层而普通网络 18 层就崩溃了。Transformer 有两组残差通路,所以能稳定训练更深。"
Q33: Cross-Attention(交叉注意力)的工程实现细节是什么?为什么它连接 Encoder 和 Decoder?
🧠 图解记忆:Cross-Attention 是 Decoder 问 Encoder——"这段上下文里有什么和我需要生成相关的?";点击图片可查看原图。
💡 答案要点
Cross-Attention 是 Encoder-Decoder 架构的信息桥梁。
基本原理:
Encoder 输出: E = [e₁, e₂, ..., e_N]  (N 个编码后的源序列token)
Decoder 当前状态: d_t                  (第 t 个已生成的目标token)

Cross-Attention:
  Q = d_t @ W_Q              # Decoder 想知道什么
  K = E @ W_K                # Encoder 提供了什么
  V = E @ W_V                # Encoder 的内容

  attention(d_t, E) = softmax(QK^T/√d_k) V
  output_d_t = attention_output @ W_O
关键区别 vs Self-Attention:
| 维度 | Self-Attention | Cross-Attention |
|---|---|---|
| Q 来源 | 自身序列 | Decoder |
| K/V 来源 | 自身序列 | Encoder 输出 |
| Mask | causal mask (Decoder自回归) | 无mask (看全部源序列) |
| 目的 | 序列内理解 | 跨模态/跨语言理解 |
| 复杂度 | O(N²) N=目标长 | O(N_src × N_tgt) |
工程实现的两个优化方向:
方案1: 缓存 Encoder 的 K,V
- Encoder 只需要算一次(源序列不变)
- Decoder 每步只算 Q,复用 K,V
- 节省 N_tgt × N_src 次 K,V 计算

方案2: 增量式 Cross-Attention
- 某些场景下 Encoder 输出也需要缓存历史状态
- 如在翻译任务中逐步扩展源句时的处理

```python
# 生产系统中的典型实现
class CrossAttentionLayer(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        self.W_Q = nn.Linear(d_model, d_model)
        self.W_KV = nn.Linear(d_model, d_model * 2)  # 共享权重
        self.output_proj = nn.Linear(d_model, d_model)
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

    def forward(self, decoder_hidden, encoder_output, mask=None):
        batch_size = decoder_hidden.size(0)
        seq_len = decoder_hidden.size(1)
        src_len = encoder_output.size(1)

        # Decoder: 生成 Q
        Q = self.W_Q(decoder_hidden).view(batch_size, seq_len, self.num_heads, self.d_k)
        Q = Q.transpose(1, 2)  # (batch, heads, tgt_seq, d_k)

        # Encoder: 生成 K, V
        KV = self.W_KV(encoder_output).view(batch_size, src_len, 2, self.num_heads, self.d_k)
        K, V = KV.unbind(dim=2)
        K = K.transpose(1, 2)  # (batch, heads, src_seq, d_k)
        V = V.transpose(1, 2)  # (batch, heads, src_seq, d_k)

        # Attention
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)
        attn_weights = F.softmax(scores, dim=-1)
        output = torch.matmul(attn_weights, V)

        # Merge heads and project
        output = output.transpose(1, 2).contiguous().view(batch_size, seq_len, -1)
        return self.output_proj(output)
现代应用中的 Cross-Attention 变体:
1. 多模态融合(Vision-Language):
   Q: 文本 embedding
   K,V: 视觉特征 (CLIP image features)
   → CLIP、BLIP、LLaVA 都用类似机制

2. 检索增强(RAG):
   Q: 用户 query embedding
   K,V: 检索到的文档向量
   → 让模型基于检索结果回答问题

3. 条件生成:
   Q: 解码器隐藏状态
   K,V: 控制信号(风格、情感、主题等标签)
   → 引导生成内容符合指定条件
性能考量:
Cross-Attention 的瓶颈:
  - Encoder 输出越长,K,V 越大
  - 在 RAG 场景中,检索到的文档可能很长(数千 token)
  - 解决方案:Chunking + 重排序 + 窗口裁剪

注意:Cross-Attention 仅存在于 Encoder-Decoder 架构(如 T5)。
Decoder-only(GPT 系列)没有 Cross-Attention,而是通过 context window 间接获取外部信息。
面试话术:
"Cross-Attention 让 Decoder 在生成每个 token 时'询问' Encoder——从编码器输出中找出与当前生成最相关的部分。它在工程上的关键是缓存 Encoder 的 K,V(因为它们不变),以及理解它在不同场景下的变体:多模态、RAG、条件生成。GPT 系列因为只用 Decoder,所以没有 Cross-Attention,而是依赖更大的 context window。"
Q34: Token Embedding 层在训练中有哪些特殊问题?为什么它常常需要特殊处理?
🧠 图解记忆:嵌入层是最大的单层参数池,其训练稳定性和初始化方式直接影响整个模型的收敛质量;点击图片可查看原图。
💡 答案要点
Embedding 层是 Transformer 中参数量最大的单个组件之一。
参数规模:
词表大小 × 隐藏维度 = 嵌入层参数总数

示例(不同模型):
  GPT-2:    50,257 × 768       = 38.6M  (~25% 总参数)
  LLaMA 3:  128,256 × 4,096    = 525M   (~34% 总参数)
  Claude:   200,000 × 8,192    ≈ 1.6B   (估算)

对比 FFN:
  FFN: d_model × d_ff × 2
  LLaMA 3: 4,096 × 14,336 × 2 = 117M × 2 = 234M per layer × 80 layers
  单 FFN 层 ≈ 1.2 个 Embedding 层
  但 Embedding 只有一层,FFN 有多层
  → 实际上 Embedding 是最大单一参数块
问题1: Hot Word Problem(高频词过拟合)
中文为例:
  "的"出现频率 ~5%
  "我" 出现频率 ~3%
  某个专业术语出现 ~0.0001%

高频词的嵌入向量会被大量更新 → 过度调整
低频词的嵌入向量几乎不更新 → 训练不充分

解决策略:
  1. 子词分词(BPE/Subword)平衡词频分布
  2. 加权采样:降采样高频词,过采样低频词
  3. 学习率分层:不同 token 使用不同 LR(复杂,少用)
问题2: Token Boundary Shift(分词边界漂移)
当分词器改变时,相同语义可能被拆分为不同token集合

例子:"人工智能" → 可能是
  A: ["人工", "智能"] (2 tokens)
  B: ["人", "工", "智", "能"] (4 tokens)
  C: ["人工智能"] (1 token)

→ 不同的分词策略会导致完全不同的嵌入向量
→ 迁移检查点时需要重新对齐或使用相同的 tokenizer
问题3: 权重共享(Weight Tying)
原始 Transformer:
  Embedding: vocab × d_model
  LM Head(输出投影): d_model × vocab
  参数量: 2 × vocab × d_model

Otters et al. (2016), Press & Wolf (2017):
  让 LM Head 的权重 = Embedding 的转置
  参数: vocab × d_model
  减少 50% 的参数

效果(论文报告):
  ✓ 大多数任务:质量相当或略好
  ✓ 训练更快(参数减半)
  ✗ 极少数情况下:小数据集上略逊
  ✓ 显存占用也减半

LLaMA/GPT-3/Qwen 全部使用 weight tying
问题4: 初始化敏感性
Embedding 层的初始化非常重要:

错误做法:
  nn.Embedding(vocab, d_model)  # 默认 XavierUniform
  → 初始嵌入向量之间可能过于接近
  → 导致早期训练阶段 attention 无法区分不同 token

正确做法:
  1. 使用预训练好的词嵌入(Word2Vec/GloVe)作为初始化
  2. 或者使用 scaled initialization:
     std = init_scale / sqrt(d_model)
     embed.weight.data.normal_(mean=0, std=std)
  3. 在 LLM 中更常用的是让模型从头学习
     但配合 warmup LR 和正确的初始化策略

位置编码的特殊性:
  - Sinusoidal PE: 不需要额外初始化(公式确定)
  - Learned PE: 同一般权重初始化策略
问题5: 大词表的存储挑战
vocab = 200,000, d_model = 8,192

显存占用:
  200,000 × 8,192 × 4 bytes = 6.4 GB (FP32)
  → 一个 Embedding 层就需要 6.4GB
  → 加上 FFN(可能有几百 GB)
  → 但 Embedding 仍然不可忽视

优化策略:
  - ZeRO stage 3: 将 Embedding 切分到多 GPU
  - Embedding sharding: 按行切片,分布式检索
  - 量化:FP16/BF16 减少一半,INT8 再减一半
  - PagedEmbedding(类似 PagedAttention): 按需换入换出
面试话术:
"Embedding 层虽然是简单查表操作,但它通常是整个模型中参数量最大的单一组件。高频词的 overfitting、tokenizer 的边界变化、以及是否需要 weight tying 都是面试常考话题。实际工程中还要考虑 6GB+ 的显存占用和分布式存储。"
Q27: Speculative Decoding(投机解码)是什么?如何实现 2-3x 推理加速?
🧠 图解记忆:小模型跑得快但不准,大模型跑得慢但权威——两者合作让大模型一次验多个候选。
💡 答案要点
核心思想:用小模型生成多个候选 token,用大模型一次验证
传统自回归生成的瓶颈:
每个 token 需要完整 forward pass:
Step 1: prompt → predict token₁ (耗时 t)
Step 2: prompt + token₁ → predict token₂ (耗时 t)
Step 3: prompt + token₁ + token₂ → predict token₃ (耗时 t)
...
总计 n 个 token = n × t
Speculative Decoding 思路:
假设有一个更快的 draft model(如 LoRA adapter、蒸馏小模型):

Step 1: prompt → draft model 快速生成 k 个候选: [t₁, t₂, ..., tₖ]  (耗时 ~k×t_small ≈ t)
Step 2: target model 一次性验证这 k 个候选(前向传播)
         同时验证 prompt(prefill 阶段合并完成)
Step 3: 从第 1 个不匹配的 token 开始回退
         匹配了 m 个(m ≤ k),然后 target model 重新预测第 m+1 个 token

结果:一次 target forward 产出了 (m+1) 个 token
其中 m 个直接采纳(无需额外计算),最后 1 个是正式预测
数学保证:输出分布完全等价于 vanilla decoding
验证过程:
1. draft 给出候选: x̂₁, x̂₂, ..., x̂ₖ
2. target 模型对位置 i 的概率为 P_target(xᵢ | x<ᵢ)
3. 检查是否接受 x̂ᵢ:
   - 以概率 min(1, P_target(x̂ᵢ) / P_draft(x̂ᵢ)) 接受
   - 如果拒绝,从 target 采样替换
   - 一旦遇到第一个拒绝的 token,从该位置重新开始
4. 全部通过后继续下一步

关键:这个 acceptance-rejection 机制保证了最终输出的概率分布
      与直接用 target model 自回归生成的分布完全一致。
→ 零精度损失!
实际加速比估算:
加速比 ≈ 1 / (1 - α + α/k)

α = 接受率(通常 60%-80%)
k = 草稿长度(通常 4-8)

例如 α=70%, k=4:
加速比 ≈ 1 / (0.3 + 0.7/4) = 1/0.475 ≈ 2.1x

实际经验值:
- Draft model 越小越快,但 α 越低
- k 越大理论加速越高,但长草稿更容易中途拒绝
- 最优 k ≈ 4-8 是工业界共识
Draft Model 来源:
方案              | 说明                     | 优缺点
-------------------|-------------------------|-------
同架构缩小版       | LLaMA-8B→LLaMA-8M 蒸馏  | 速度快,质量稳定,需微调
LoRA Adapter       | 在大模型上加个小adapter  | 共享大部分权重,显存开销小
自身小层           | 取 target 模型的浅层     | 零额外成本,适合分层模型
外部轻量模型       | 独立训练的小模型          | 灵活,但需要额外显存
工程实现要点:
vLLM + speculative decoding:
- 修改 paged attention kernel 支持多 speculative heads
- 预填阶段将 prompt + draft tokens 一起 encode
- 验证时复用 KV cache,避免重复计算历史 token
- 通过 TMA 自动调度数据搬运(Hopper TMA)

关键优化:
1. Batch multiple spec steps: 将多次 speculation 合并为一个 GPU kernel
2. Continuous batching: 不同 sequence 在 verification stage 之间 interleaving
3. Early exit: 如果 draft match 长度短于阈值,提前放弃当前 speculation
面试话术: ``">投机解码的核心是用小模型快速草稿、大模型批量验证。它的最大亮点是在数学上严格等价于 vanilla decoding——零精度损失。一个 70% 接受率的 draft model 配合 k=4 的草稿长度,可以带来约 2x 的推理加速。工业界主流方案是同架构 LoRA adapter 或蒸馏小模型。关键在于 draft 和 target 的匹配度——太相似的话 draft 没帮助,差异太大则接受率低。"
⭐ **面试加分项:**
- 能推导 acceptance-rejection 概率公式并证明分布等价性
- 理解 k 和 α 的关系以及最优 k≈4-8 的经验依据
- 知道 vLLM 如何通过修改 paged attention kernel 来支持 speculate
- 了解 early-exit 策略和 continuous batching 对吞吐量的进一步增益

</details>

---

### Q28: Attention Sink(注意力坍缩)是什么?为什么 Gated Attention 能缓解它?

<p align="center"><sub>🧠 图解记忆:长对话里前面的话像在引力井一样吞噬所有注意力,后面的人说了什么都听不见。</sub></p>

<details>
<summary>💡 答案要点</summary>

**Attention Sink = 随着序列增长,新 token 的注意力权重逐渐集中在少数早期 token 上的现象**

**观察到的事实:**
实验发现(Xiong et al., 2023): 当生成长文本时,Decoder 中新 token 的注意力几乎全部集中在开头的几个 token(特别是 [BOS] 标记)
例如在一个 32K 上下文的对话中: 新生成 token 对位置 [0,1,2,...,10] 的注意力总和 > 70% 而位置 [1000,2000,3000] 等中间区域的注意力接近 0
这意味着:即使模型能看到完整的上下文,它实际上只关注开头部分!
**为什么会出现 Attention Sink?**

```python
# Self-Attention 注意力分数计算
scores = Q @ K^T / sqrt(d_k)
scores_softmax = softmax(scores)

# 问题链条:
# 1. Softmax 总是产生正数分布(总和=1)
# 2. 当序列很长时,新的 Q 向量与大量旧 K 的点积会产生很多小的负值
# 3. 这些极小的负值经过 softmax 后趋向于均匀分布 → 数值不稳定
# 4. 为解决此问题,早期位置的绝对值较小 → softmax 中相对更突出
# 5. 最终新 token 过度关注开头
根本原因:
- Softmax 的数值稳定性需求:如果所有 score 都是大负数,softmax 会趋向均匀分布,梯度消失
- 位置编码的影响:某些位置编码方式使得早期 token 更容易被注意到
- 因果掩码的特殊结构:decoder 只能看到之前的 token,边界效应放大了开头的权重
解决方案:Gated Attention(Yi et al., 2024)
原始 Transformer:
    attn_weights = softmax(QK^T / sqrt(d_k))
    output = attn_weights @ V

Gated Attention (Simplified):
    attn_weights_raw = softmax(QK^T / sqrt(d_k))
    gated_attn = attn_weights_raw * gate  # gate ∈ [0, 1]

    # key 的变化:不是直接加到 hidden state
    key_transformed = layer_norm(hidden_state)
    output = gated_attn @ V + linear_projection(key_transformed)

    # 核心:引入了一个可学习的门控参数 + 残差路径
    # 让模型可以选择性地忽略 attention sink
其他缓解方案:
| 方案 | 原理 | 效果 | 缺点 |
|---|---|---|---|
| Gated Attention | 引入可学习门控 + 残差投影 | ✅ 显著改善长文保留 | 需要重新训练 |
| Key-only Normalization | 对 Key 做归一化,避免点积过大 | ✅ 简单有效 | 影响有限 |
| Recurrence / State Compression | RNN式状态传递(如 Mamba) | ✅ 从根本上避免平方复杂度 | 表达能力受限 |
| Chunk-based Attention | 分块处理,chunk间通过特殊token传递摘要 | ✅ 控制局部注意力范围 | 实现复杂 |
| Attention ReLU / LeakyReLU | 不用Softmax,用ReLU变体 | ⚠️ 有理论争议 | 效果不稳定 |
实际应用中的建议:
1. 如果上下文长度 < 8K:attention sink 影响不大,不需要特别处理
2. 8K < 上下文 < 32K:考虑 sliding window 或 chunked attention
3. 上下文 > 32K:必须使用长序列优化的架构(Gemma2滑动窗口、Mistral3交错SW)
4. 生产环境:结合 KV cache eviction 策略(见下方KV Cache Eviction相关题目)
面试话术: ``"> Attention Sink 是一个反直觉的现象——理论上模型能看到全部上下文,但实际注意力集中在开头。根本原因是 Softmax 在长序列下趋于均匀分布,导致早期 token 相对突出。Gated Attention 通过引入可学习门控和残差路径,让模型有能力调整这种偏置。在生产环境中,对于长上下文应用需要特别关注这个问题。"
⭐ **面试加分项:**
- 能从数学角度解释为什么 Softmax 会导致注意力集中
- 区分 Attention Sink 和其他类似现象(如 Attention Dilution、位置衰减)
- 能说清 Gate 的具体形式和在模型中的位置
- 知道 Gemma2/Mistral3 等模型如何处理长序列注意力分配

</details>

---

### Q29: FlashAttention-3 相比 FA2 新增了哪些关键技术?为什么依赖 Hopper 硬件?

<details>
<summary>💡 答案要点</summary>

**FA3 的核心进步:利用 NVIDIA Hopper (H100) 的新硬件特性实现更高的利用率**

**FA2 在 Hopper 上的瓶颈:**
FA2 虽然降低了内存访问,但在 H100 上只有 ~35% 的 Tensor Core 利用率 原因:FA2 仍按 CUDA warp/block 组织,没有利用 Hopper 特有的异步能力 → 算法与硬件不匹配,GPU 算力浪费严重
**FA3 三大技术创新:**

**1. Asynchronous Block-Matrix Multiplication(异步分块矩阵乘法)**
Hopper 的 TMA(Tensor Memory Accelerator)可以:
- 在 Tensor Core 计算的同时,后台自动搬运下一批数据
- 消除「计算等待数据传输」的空闲时间
传统 GPU: [加载数据][计算][加载数据][计算]... ←--- idle ---→
FA3 + TMA: [加载][计算←加载下一批][计算←再下一批]... ↑ 重叠执行,消除空闲
**2. Warp-Scheduler Level Asynchrony(Warp级异步调度)**FA3 进一步将异步粒度细化到 warp(32 threads)级别:
- 不同的 warp 负责不同的 tile 计算
- 当一个 warp 在计算时,另一个 warp 在预加载
- 利用 SM 内的 thread block cluster 机制
Thread hierarchy (细到粗): Thread → Warp (32线程) → Warpgroup (4 warps) → Threadblock (CTA) → Cluster → Grid
FA3 的关键:在 warpgroup 层面协调计算和数据预取
**3. Low-Precision Computation(低精度运算)**FA3 允许在保持精度的前提下使用 FP8 / INT8:
- Attention 计算的核心步骤可以使用半精度甚至更低精度
- 通过 careful numerical design 保持数值稳定
- FP8 在 Hopper 上有原生硬件支持(FP8 Tensor Cores)
精度选择建议:
- Training: FP16/TF32(最安全)
- Inference: FP8/INT8(Hopper 专属加速,速度提升 2x+)
- CPU/RAM inference: BF16(兼容性好)
**FA1 → FA2 → FA3 演进总结:**

| 特性 | FA1 | FA2 | FA3 |
|------|-----|-----|-----|
| **核心技术** | IO-aware tiling | Persistent kernel | Asynchrony + TMA + Low-precision |
| **GPU适配** | 通用 | A100/H100 | Hopper 专属深度优化 |
| **SRAM重用** | ✅ | ✅✅ | ✅✅✅(异步重叠) |
| **数值精度** | FP16/FP32 | FP16/FP32 | FP8/INT8 支持 |
| **吞吐量(H100)** | ~1x | ~1.35x | ~2x+ |
| **适用场景** | 通用训练/推理 | 高效训练/推理 | Hopper 全栈加速 |

**工程部署注意事项:**
FA3 只在 Hopper (H100/H200) 上才能真正发挥优势 Ampere (A100/A800): 用 FA2 即可 Tesla (V100): 不建议用 FlashAttention
框架集成:
- PyTorch >= 2.2 内置 FA3
- vLLM >= 0.5.0 支持 FA3 (需 H100)
- HuggingFace Transformers 自动调用合适版本
- DeepSpeed 也集成了 FA3
代码透明:开发者只需确保安装最新版库,无需改业务代码
**面试话术:**
``"> FA3 的关键进步是利用了 Hopper 架构的异步硬件——TMA 在计算时自动预取数据,消除了 GPU 空闲等待;warp 级异步调度让多个计算单元并行工作;加上 FP8 低精度支持,H100 上能达到两倍以上吞吐量。但它只在 Hopper 上有价值,A100 用户用 FA2 就够了。FA3 的最大意义在于证明了'算法设计必须紧跟硬件演进'这一道理。\"
⭐ 面试加分项:
- 画出 TMA 如何实现计算与数据传输重叠的示意图
- 理解 warp scheduler level asynchrony 的意义
- 能说清 FA3 各代之间的核心改进差异
- 了解什么时候用 FP8 而不是 FP16
Q30: Linear Attention(线性注意力)是什么?它与标准 Self-Attention 的本质区别?
💡 答案要点
Linear Attention = 将标准 Attention 的 O(n²) 复杂度降到 O(n) 的计算范式
标准 Attention 的复杂度瓶颈:
Attention(Q,K,V) = softmax(QK^T) V

矩阵尺寸:Q(n×d), K(n×d), V(n×d)
  QK^T → (n×d)(d×n) = (n×n)  ← O(n²d),这是平方复杂度之源
  softmax(...) → (n×n)
  @V → (n×n)(n×d) = (n×d)

总计算量:O(n²d),显存 O(n²)
Rewrite Attention 的核心思想:交换乘法顺序
标准公式:softmax(QK^T)V
展开写:Σ_j softmax(q_i·k_j) · v_j

Rewrite 观察:
  Σ_j softmax(q_i·k_j) · v_j = softmax(q_i) · Σ_j exp(k_j) · v_j  ← 近似!

如果把 softmax 去掉或用近似:
  Σ_j (q_i · k_j) · v_j = q_i · Σ_j (k_j · v_j)  ← O(nd)!

关键是先把 K 和 V 的乘积累加起来,再用 Q 去点乘这个累加结果
→ 把两个长度为 n 的求和变成了一次聚合
经典实现 Linformer(2021):
核心思路:降低 K/V 的维度

  K_proj = W_k @ K    # (n×d) → (n×e), e << d  (可学习的投影)
  V_proj = W_v @ V    # (n×d) → (n×e)

  Attention = softmax(Q @ K_proj^T) @ V_proj

  Q @ K_proj^T → (n×d)(d×e) = (n×e)  ← O(nd) instead of O(n²)!
  softmax 作用于 (n×e) 而非 (n×n)
  @V_proj → (n×e)(e×d) = (n×d)

限制:e 固定且很小 → 难以表达复杂的跨位置关系
Performer(2021)的随机特征近似:
核心思路:用 kernel trick 近似 softmax

  softmax(x·y) ≈ φ(x)^T φ(y)  (随机特征展开)

其中 φ 是高斯核或其他 positive kernel 的特征映射
  → 可以把 softmax(QK^T) 改写为 Φ(Q)Φ(K)^T
  → Attention = Φ(Q)[Φ(K)^T V]
  → 先算 [Φ(K)^T V] = O(nd),再用 Φ(Q) 点乘

优势:保持了接近原始注意力的表达能力
风险:kernel approximation 可能引入误差
实际应用的权衡:
| 方案 | 复杂度 | 表达能力 | 成熟度 | 代表应用 |
|---|---|---|---|---|
| Linformer | O(nd) | 中等(e 固定小) | 实验室级 | 研究探索 |
| Performer | O(nd) | 较高(kernel近似) | 较成熟 | Google Research |
| RWKV | O(nd) | 高(RNN-like状态) | 生产可用 | RWKV系列 |
| Mamba(SSM) | O(nd) | 互补(选择性状态) | 生产可用 | Mamba/Jamba |
| FlashAttention | O(n²)精确 | 最强 | 工业标准 | vLLM, HF |
面试话术: ``"> Linear Attention 的核心是把 QK^T 计算分解:先聚合 K@V 的结果,再用 Q 去乘这个聚合值,从而把 O(n²d) 降到 O(nd)。Linformer 通过降低维度实现,Performer 用 kernel 近似。但要注意,这些近似方法在长文本和多跳推理上效果不如标准 Attention。目前工业界仍以 FlashAttention 优化标准 Attention 为主,Linear Attention 更多用于超长序列的边缘场景。"
⭐ **面试加分项:**
- 能推导出 O(n²) → O(n) 的数学变换
- 说清 Linformer 和 Performer 的不同思路
- 理解 Linear Attention 的表达能力局限(受限于低秩/近似)
- 知道为什么工业界还是以 FlashAttention+标准 Attention 为主

</details>

---

### Q31: Transformer 单层的 Self-Attention 和 FFN 各自占多少计算量和显存?如何根据任务特点选择优化方向?

<details>
<summary>💡 答案要点</summary>

**这是一个非常实际的工程问题——决定你的优化应该放在哪里**

**详细计算量分解(单层,batch=B, seq=N, d_model=d, head_dim=h=d/num_heads):**
Self-Attention 计算量(不含投影):
- Q, K, V 投影: B × N × d × 3d × 2 FLOPs = 6B·N·d² (每个输入 d 维 → 输出 d 维,3个权重矩阵,乘加算 2 FLOPs)
- QK^T: B × num_heads × N × h × N × 2 = 2BN²dh
- softmax + @V: B × num_heads × N × N × 2 + B × num_heads × N × h × N × 2 ≈ 2BN²h + 2BN²h = 4BN²h
Total Self-Attention ≈ 6B·N·d² + 6BN²h = 6B·N·(d² + Nh)
FFN 计算量: FFN 结构: d → d_ff → d (通常 d_ff = 4d)
- W1 投影: B × N × d × 4d × 2 = 8B·N·d²
- 激活函数: B × N × 4d × 1 = 4B·N·d
- W2 投影: B × N × 4d × d × 2 = 8B·N·d²
Total FFN ≈ 16B·N·d² + 4B·N·d ≈ 16B·N·d²
**两种场景的对比:**

```python
# 短序列场景(N << d)
# 例如: N=128, d=4096, B=4
# Attention: 6×4×128×(4096² + 128×512) ≈ 6.4×10¹⁰ FLOPs
# FFN:       16×4×128×4096²         ≈ 1.7×10¹¹ FLOPs
# FFN占比:   ~73%

# 长序列场景(N >> d)
# 例如: N=8192, d=4096, B=1
# Attention: 6×1×8192×(4096² + 8192×512) ≈ 1.3×10¹¹ FLOPs
# FFN:       16×1×8192×4096²             ≈ 2.2×10¹¹ FLOPs
# FFN占比:   ~63%

# 超长期场景(N >> d,如 32K)
# 例如: N=32768, d=4096, B=1
# Attention: 6×1×32768×(4096² + 32768×512) ≈ 9.0×10¹¹ FLOPs
# FFN:       16×1×32768×4096²               ≈ 8.8×10¹¹ FLOPs
# Attention占比反而超过 FFN!~50%
显存占用对比(训练模式):
| 资源         | Self-Attention     | FFN                |
|--------------|--------------------|--------------------|
| 权重大小     | 3d² + d² = 4d²    | 2d×d_ff ≈ 8d²      |
| 激活缓存     | O(N²)(注意力矩阵)| O(N·d_ff) ≈ O(4Nd)|
| 反向传播梯度 | O(4d²)            | O(8d²)             |
| 主要瓶颈     | 长序列时 O(N²)     | d² 规模大时        |
优化策略选择指南:
如果 N < d(大多数日常场景):
  ├─ FFN 占总计算 70-80%
  ├─ MoE 替换 FFN 的收益最大(每token跳过无用专家)
  ├─ 量化重点在权重矩阵 W1/W2
  └─ SwapFFN: 计算FFN时卸载Attention权重到CPU

如果 N > 4d(长文本推理):
  ├─ Attention 成为瓶颈
  ├─ FlashAttention 收益最大
  ├─ Sliding Window / Sparse Attention 降复杂度
  └─ KV Cache 量化/offload 节省显存

如果 batch_size 很大(高吞吐服务):
  ├─ 两者都重要
  ├─ PagedAttention 解决 KV Cache 碎片问题
  ├─ Continuous Batching 最大化 GPU 利用率
  └─ 混合策略:MoE(降compute) + FA(降memory IO) + Quant(降带宽)
面试话术: ``"> Transformer 单层的计算量取决于序列长度。短序列时 FFN 占 70-80%,长序列时两者趋近 50/50。优化策略由此决定:短序列优先 MoE 和 FFN 量化,长序列优先 FlashAttention 和 KV Cache 管理。这是一个容易被忽视但非常重要的决策框架。"
⭐ **面试加分项:**
- 能手算不同序列长度下的计算占比
- 理解为什么 FFN 是 MoE 替换的主要目标
- 知道长序列和优化策略的关系
- 能给出生产环境的具体优化组合方案

</details>

### Q35: Kernel-Based Attention(如 Performer)如何把 O(n²) 降到 O(n)?核心数学原理是什么?

<p align="center"><sub>🧠 图解记忆:用核技巧拆解 QK^T V,先算 K^T V 再乘 Q,避开 NxN 大矩阵;点击图片可查看原图。</sub></p>

<details>
<summary>💡 答案要点</summary>

**背景:标准 Attention 的 O(n²) 瓶颈来自显式计算 N×N 注意力矩阵**

**核心洞察:利用 Associativity 交换乘法顺序**

```python
# 标准 Attention(O(n²) 时间 + O(n²) 空间):
output[i] = Σ_j softmax(q_i · k_j / √d) * v_j
           = Σ_j exp(q_i·k_j/√d) / Σ_l exp(q_i·k_l/√d) * v_j

# Performer 的关键改写:
# 用特征映射 φ(·) 使得 φ(q)·φ(k) ≈ softmax_kernel(q,k)
# 那么:
output[i] = Σ_j φ(q_i)·φ(k_j) * v_j
          = φ(q_i) · (Σ_j φ(k_j) ⊗ v_j)   ← ⊗ 表示外积
          = φ(q_i) · G                       # G = Σ_j φ(k_j)⊗v_j 是 d×d 矩阵
G 的计算只依赖 d(hidden dimension),不依赖序列长度 n!
class PerformerAttention(nn.Module):
    def __init__(self, d_model, n_features=64):
        super().__init__()
        self.d = d_model
        self.n_features = n_features  # 随机特征数量

        # 随机投影矩阵 ω, b
        # φ(x) = Relu(ωx + b) / sqrt(n_features)
        self.R = torch.randn(n_features, d_model) / math.sqrt(d_model)
        self.b = torch.rand(n_features)

    def forward(self, Q, K, V):
        batch_size, seq_len, _ = Q.shape

        # 1. 特征映射(使用 ReLU 作为正交随机特征)
        Q_feat = F.relu(Q @ self.R.T + self.b)  # (B, N, n_features)
        K_feat = F.relu(K @ self.R.T + self.b)  # (B, N, n_features)

        # 2. 先算 K_feat^T V (大小 n_features × d,与 N 无关)
        GKV = torch.bmm(K_feat.transpose(1, 2), V)  # (B, n_features, d)

        # 3. 再用 Q_feat @ GKV
        output = torch.bmm(Q_feat, GKV)  # (B, N, d)

        # 4. 归一化:除以 φ(q_i) · Σ_k φ(k_k)
        normalizer = torch.bmm(Q_feat, K_feat.sum(dim=1, keepdim=True).transpose(1, 2))
        output = output / (normalizer + 1e-8)

        return output
为什么用正交随机特征(FAVOR+)?
| 特征映射 | 性质 | 稳定性 |
|---|---|---|
| Fourier Features | sin/cos 变换 | ❌ 数值不稳定,可能出现负值导致除零 |
| ReLU Features | φ(x)=max(0, x) | ✅ 正值保证,数值稳定,是 FAVOR+ 的选择 |
| Chebyshev | 多项式基 | ⚠️ 理论好但实践较少 |
复杂度对比:
| 算法 | 时间复杂度 | 空间复杂度 | 精度 |
|---|---|---|---|
| Standard Attention | O(n²d) | O(n²) | 精确 |
| Performer (FAVOR+) | O(nd² + nd·n_feat) | O(nd) | 高斯近似,误差可控 |
| Linformer | O(nd²) | O(nd) | 低秩近似,n_feat=d |
面试话术:
"Performer 的核心是利用结合律:先算 φ(K)^T V(大小 d×d,与 n 无关),再乘以 φ(Q)。这样把 O(n²d) 降为 O(nd²),空间从 O(n²) 降到 O(d)。用的是 ReLU 正交随机特征来近似 softmax 核。Trade-off 是用近似换线性,适合超长期场景。"
⭐ 面试加分项:
- 能手推导 f(QK^TV) = (fQ)(fK)^TV 的结合律推导
- 理解为什么 Fourier features 不稳定而 ReLU features 更稳健
- 知道 FAVOR+(Fast Attention Via positive Orthogonal Random Features)的名字来源和"positive"的重要性
- 理解近似误差与 n_features 的关系:更多特征→更高精度→更高常数开销
Q36: 投机解码(Speculative Decoding)如何实现 2-3x 推理加速?关键技术挑战是什么?
🧠 图解记忆:小秘书写草稿,老板批注确认,一次过一轮省很多步;点击图片可查看原图。
💡 答案要点
核心思想:用小(快)模型提前写好一批猜测,大(准)模型批量验证
传统自回归生成(逐 token,延迟高):
# 每生成 1 个 token,都要做一次完整的大模型前向传播
for i in range(max_len):
    logits = big_model.forward(tokens[:i])  # O(Large model compute) per step
    next_token = argmax(logits)
    tokens.append(next_token)
# 总耗时 ≈ max_len × big_model_latency
投机解码流程:
# Step 1: 小模型(draft model)快速生成 draft_length 个候选 token
# 假设 draft_length = 4
draft_tokens = []
for _ in range(draft_length):
    draft_next = small_model.predict(tokens)
    draft_tokens.append(draft_next)

# Step 2: 大模型一次性向前传播,验证所有候选 token
# 注意:这里是一次前向,不是多个!
logits = big_model.forward(tokens + draft_tokens)  # 1 large model forward!
accepted_count = 0
final_output = []

# Step 3: 逐个检查大模型对每个位置的预测是否与小模型一致
for i, draft_t in enumerate(draft_tokens):
    if vocab_index_to_token[argmax(logits[i])] == draft_t:
        final_output.append(draft_t)   # ✅ 命中,接受
        accepted_count += 1
    else:
        # ❌ 不匹配,用大模型的分布替换
        acceptance_probs = ...  # 详细见下
        accept_or_reject = sample_with_correction(...)
        final_output.append(acceptance_probs.token)
        break

# Step 4: 追加最终结果继续下一轮
tokens.extend(final_output)
接受率校准(确保分布不变):
def calculate_acceptance_probs(draft_logit, target_logit, draft_token_idx):
    \"\"\"
    确保投机解码不会改变目标分布 —— 这是最重要的理论保证
    \"\"\"
    # 小模型给出 token 的概率
    p_draft = F.softmax(draft_logit)[draft_token_idx]
    # 大模型给出同样 token 的概率
    p_target = F.softmax(target_logit)[draft_token_idx]

    # 接受概率 = min(1, p_target / p_draft)
    # 如果小模型比大模型更确定该 token,则以 p_target/p_draft 的概率接受
    # 否则无条件接受(避免引入偏差)
    accept_prob = min(1.0, p_target / p_draft)

    return accept_prob
关键数字:
# 理想情况下:全部命中
# 大模型只做 1/N 次前向,N 是 draft length
# 加速比 ≈ N

# 实际中:命中率约 50-80%
# 平均加速比 ≈ 1.8 - 2.5x(取决于 draft length 和模型对数关系)

# 实验数据:
#   Draft Length | Avg Accept Rate | Speedup
#   -------------|-----------------|---------
#   2            | ~85%            | ~1.4x
#   4            | ~70%            | ~1.8x
#   8            | ~55%            | ~2.0x
#   16           | ~40%            | ~2.3x  ← 收益递减
关键技术挑战:
1. 教师选择(Teacher Selection)
   - 小模型不能太差(accept rate 太低)也不能太相似(无加速意义)
   - 常用方案:同架构减半参数 / 剪枝模型 / DistilBERT 式蒸馏
   - DeepSeek 方案:用自身的小版本做教师

2. 计算均衡(Balanced Compute)
   - 教师生成 + 大模型验证的总计算量必须 < 逐 token 大模型推理
   - 如果教师太慢或验证太长,得不偿失
   - 公式:(large_cost + small_cost * k) < large_cost * k
     → small_cost < (N-1) * large_cost(很容易满足)

3. 显存管理
   - 大模型验证时需要持有整个扩展序列的 KV Cache
   - 如果 draft length 很大,KV Cache 膨胀
   - PagedAttention 等机制在此处更关键

4. 并发调度
   - 多个请求同时做投机解码时,batch 内的 draft length 不一致
   - 需要动态 padding 或使用 speculative batching
工业实践(2026年主流方案):
| 公司 | 方案 | 效果 |
|---|---|---|
| Medusa (附加预测头) | 2-3x,无需额外教师 | |
| Meta | EAGLE (轻量级 MLP 教师) | 2-4x,特定架构适配 |
| DeepSeek | 自蒸馏投机解码 | 2.5x,成本最优 |
| OpenAI | 类似 EAGLE 方案 | 内部部署 |
面试话术:
"投机解码用一个快速小模型生成一批候选 token,大模型一次性验证。关键是接受率校准保证分布不变——min(1, p_target/p_draft) 让大模型拒绝过度自信的小模型猜测。实际加速 1.8-2.5x,随着 draft length 增加收益递减。Medusa 进一步提出直接在主模型上附加预测头,连教师模型都不需要了。"
⭐ 面试加分项:
- 能解释接受概率校准的数学证明(确保输出分布与目标一致)
- 理解为什么 draft length > 8 后收益递减
- 知道 Medusa 方案(预测头)vs EAGLE 方案(分离教师)的区别
- 理解投机解码不适用于多模态生成(视觉部分无法投机)
Q37: Multi-Token Prediction(多Token预测)如何提升训练效率和速度?
🧠 图解记忆:每次猜一串而不是一个一个猜,学得快但要用teacher forcing防止错误积累;点击图片可查看原图。
💡 答案要点
核心思想:让模型不只预测下一个 token,而是同时预测未来 N 个 token
传统 Next-Token Prediction (NTP) vs Multi-Token Prediction (MTP):
# 传统 NTP:每个位置只预测紧随其后的 1 个 token
序列: [A, B, C, D, E, F]
训练: A→B, B→C, C→D, D→E, E→F
损失: Σ CE(pred(i+1), true(i+1))  # 5个损失项

# MTP (例如 k=3): 每个位置预测未来 3 个 token
序列: [A, B, C, D, E, F]
训练:
  A  predicts B,C,D
  B  predicts C,D,E
  C  predicts D,E,F
  ...
损失: Σ_{i,j=1}^{k} CE(pred(i+j), true(i+j))  # 5×3=15个损失项! (k=3时)
# 损失项数量 = T × k(T-k)/2 ≈ O(T²k/2)
Meta 的论文 "Better & Faster Large Language Models via Multi-token Prediction" 发现:
# 关键发现(基于 Llama-2 实验):

# 1. 样本效率提升
   - 相同的 epoch 数下,4-future-token 预测的 perplexity 更低
   - 达到相同 perplexity 所需的训练数据量减少 ~30%

# 2. 速度提升(生成时)
   - MTP 模型可以在 decoder-only 模式下 teacher-forcing 生成
   - 每次预测 n 个 token 而非 1 个
   - 实际加速比 ≈ n(受限于正确接受率)

# 3. 最佳 k 值
   k | 训练效果 | 生成速度 | 说明
   --|----------|----------|----
   2 | ≈1x      | ≈2x      | 几乎无损,最稳定
   3 | +5%      | ≈3x      | 轻微性能下降,仍可接受
   4 | +10%     | ≈4x      | 性能有可感知的退化
   8 | +20%     | ≈5x+     | 显著性能退化,不推荐
实现细节:
class MultiTokenPredictor(nn.Module):
    def __init__(self, base_model, predict_steps=3):
        super().__init__()
        self.base_model = base_model  # 共享 weights
        self.predict_steps = predict_steps  # 预测步数

    def forward(self, input_ids):
        \"\"\"
        给定输入,返回每一步的预测 logit
        \"\"\"
        outputs = self.base_model(input_ids)
        hidden_states = outputs.hidden_states

        all_logits = []
        for step in range(1, self.predict_steps + 1):
            # 使用第 (total_seq - step) 位置的隐藏状态预测 future token
            hidden_step = hidden_states[:, -step-1, :]  # 对应位置的 representation
            # 用同一个 LM head 预测
            logits_step = self.lm_head(hidden_step)
            all_logits.append(logits_step)

        return all_logits  # list of (B, vocab_size)

    def compute_loss(self, all_logits, targets):
        \"\"\"
        计算多层损失
        targets 的形状: (B, predict_steps)
        \"\"\"
        total_loss = 0
        for logits, target in zip(all_logits, targets):
            total_loss += F.cross_entropy(
                logits.view(-1, logits.size(-1)),
                target.view(-1)
            )
        return total_loss
教师强制(Teacher Forcing)训练:
# 训练时的 trick:用真实值而不是模型预测值作为后续步骤的输入
def teacher_forced_training(model, sequence, predict_steps=3):
    \"\"\"
    关键:每一步都用真实 token 作为输入,避免错误累积
    这使得 MTP 的训练像标准 LM 一样可靠
    \"\"\"
    losses = []
    for offset in range(predict_steps):
        # 输入是原始序列往前推 offset 位
        inputs = sequence[:-predict_steps + offset]
        targets = sequence[predict_steps - offset:]

        logits = model(inputs)
        loss = F.cross_entropy(
            logits.view(-1, logits.size(-1)),
            targets.view(-1)
        )
        losses.append(loss)

    return sum(losses)  # 综合所有预测步的损失
与投机解码的联系和区别:
┌──────────────┬────────────────────────┬─────────────────────────┐
│             │  Multi-Token Pred.     │  Speculative Decoding   │
├──────────────┼────────────────────────┼─────────────────────────┤
│ 使用时阶段   │ 训练 + 生成            │ 仅生成                    │
│ 核心机制     │ 模型直接学会多步预测     │ 用教师模型猜+大模型验证   │
│ 是否需要额外│ 不需要(共享同一模型)   │ 需要(小教师+大模型)     │
│ 加速比       │ 生成时 ~k 倍           │ 生成时 ~1.8-2.5x         │
│ 训练代价     │ 略有增加(~k 倍 loss)  │ 无                        │
│ 风险         │ k 太大→质量下降        │ accept rate 低→无效      │
└──────────────┴────────────────────────┴─────────────────────────┘
面试话术:
"Multi-Token Prediction 让模型在每个位置都预测未来 N 个 token,训练时损失放大约 N 倍,收敛更快。Meta 实验显示 k=3 时训练质量基本无损,生成时 teacher-forcing 可加速约 3 倍。与投机解码不同,MTP 不需要额外的教师模型,因为模型本身就学会了多步预测。关键限制是 k 增大会导致质量退化,所以一般 k≤3。"
⭐ 面试加分项:
- 理解 Teacher Forcing 为什么对 MTP 训练至关重要
- 知道 MTP 在训练时增加的是 loss 项数量而非模型大小
- 能区分 MTP 与投机解码的本质不同(同一模型 vs 双模型协作)
- 理解为什么 k=2 是最安全的选择,k≥4 开始有明显的 quality drop
Q38: Linear Attention(线性注意力)与标准 Self-Attention 的本质区别是什么?什么时候该用它?
🧠 图解记忆:先把所有KV聚合成一个统计摘要,再与Q做点乘,跳过N×N大矩阵;点击图片可查看原图。
💡 答案要点
Linear Attention ≠ FlashAttention,这是两个完全不同的思路
核心差异对比:
标准 Self-Attention (Quadratic):
  输入: (Q, K, V) each shape (B, N, d)
  输出: Σ_j softmax(q_i · k_j / √d) · v_j
  复杂度: O(N² · d) 时间和空间
  关键操作: 形成完整的 N×N 注意力矩阵

Linear Attention (Linear):
  输入: (φ(Q), φ(K), V) where φ maps to feature space
  输出: φ(q_i) · (Σ_j φ(k_j) ⊗ v_j)   ← 结合律交换
  复杂度: O(N · d²) 时间和 O(d²) 空间
  关键操作: 预聚合 K⊗V 为固定大小的 d×d 统计量
线性注意力的数学本质:
# 去掉 softmax(改用正定特征映射替代)
# Attention(Q,K,V) = softmax(QK^T/√d)V  → 近似为 → φ(Q)(φ(K)^TV)

class LinearAttention(nn.Module):
    def __init__(self, d_model, num_heads=8, dropout=0.1):
        super().__init__()
        self.num_heads = num_heads
        self.d_k = d_model // num_heads
        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)

    def forward(self, x, causal=False):
        Q = self.W_q(x)
        K = self.W_k(x)
        V = self.W_v(x)

        # 拆分多头
        Q = Q.view(B, N, self.num_heads, self.d_k).transpose(1, 2)
        K = K.view(B, N, self.num_heads, self.d_k).transpose(1, 2)
        V = V.view(B, N, self.num_heads, self.d_k).transpose(1, 2)

        # 正定特征映射 ELU + 1(保证非负)
        Q = F.elu(Q) + 1
        K = F.elu(K) + 1

        if causal:
            # 因果模式:使用 running sum 增量聚合
            return self._causal_attention(Q, K, V)
        else:
            # 非因果模式:先聚合再乘
            KKv = torch.einsum('bhid,bhjd->bhij', K, V)  # (B, H, d_k, d_k)
            output = torch.einsum('bnhd,bhkd->bnhk', Q, KKv)  # (B, N, H, d_k)
            return self.W_o(output.reshape(B, N, -1))

    def _causal_attention(self, Q, K, V):
        \"\"\"
        因果线性注意力:每步只需要维护运行中的 K^TV 统计量
        推理时每个 token 只需 O(d_k²) 的常数时间
        \"\"\"
        B, H, N, D = Q.shape
        # 初始化 running statistics
        K_running = torch.zeros(B, H, D, D, device=Q.device)
        V_running = torch.zeros(B, H, D, 1, device=Q.device)
        running_sum = torch.zeros(B, H, 1, device=Q.device)

        outputs = []
        for t in range(N):
            qt = Q[:, :, t:t+1, :].unsqueeze(3)  # (B, H, 1, D)
            kt = K[:, :, t:t+1, :].unsqueeze(3)  # (B, H, 1, D)
            vt = V[:, :, t:t+1, :].unsqueeze(3)  # (B, H, 1, D)

            # 更新 running statistics
            K_running += kt @ vt.transpose(-2, -1)  # (B, H, D, D)
            running_sum += kt.squeeze(3).sum(-1, keepdim=True)

            # 计算注意力
            denom = (qt * running_sum).sum(-1, keepdim=True) + 1e-8
            attn = (qt @ K_running) / denom
            outputs.append(attn)

        return torch.cat(outputs, dim=2).squeeze(3)
线性注意力的变体家族:
| 方法 | 核心想法 | 优点 | 缺点 |
|---|---|---|---|
| Linformer | 将 N 维 K/V 压缩到固定 m≪N 维 | 实现简单,兼容现有架构 | 长文本能力下降明显 |
| Performer | 用正交随机特征近似 softmax | O(N) 时间与空间 | 近似精度不如标准注意力 |
| Recurrent Transformers | 用 RNN 式的 running state 代替注意力 | 推理 O(1) per token | 难以并行训练 |
| RWKV | RNN + Attention 混合 | 推理极快,可流式 | 训练稳定性和质量仍待验证 |
| Mamba (SSM) | 选择性状态空间模型 | O(N) 且高质量 | 缺少内容寻址,复杂推理稍弱 |
何时使用 Linear Attention:
# 场景判断指南

def choose_attention_type(seq_length, task_type, gpu_memory):
    if seq_length < 2048:
        return \"standard\"  # 短序列直接标准 Attention
    elif seq_length >= 32768 or gpu_memory is tight:
        # 超长序列:考虑 FlashAttention 优先,若仍有问题再用 Linear
        return \"flashattention_first\" if gpu_memory > \"enough\" else \"linear\"
    else:
        # 中等长度:FlashAttention 是最好的选择
        return \"flashattention\"

# 实际应用建议(2026年):
# 1. 大多数场景:FlashAttention(保持精确 + 加速)
# 2. 极端长序列(>64K token)且有显存压力:Linear + FlashAttention 组合
# 3. 流式推理/边缘设备:RWKV/Mamba 类架构
# 4. 不要为了线性而线性——大部分情况下 FlashAttention 已经够好了
面试话术:
"Linear Attention 通过特征映射 φ 和结合律把 O(N²) 注意力变成 O(N),关键是把 K⊗V 聚合成固定大小的统计量。但与 FlashAttention 不同——FlashAttention 保持精确结果只是减少了 IO,Linear Attention 是用近似换线性。实践中,FlashAttention 已经是首选,只有在极端长序列且显存极度紧张时才考虑纯 Linear Attention。"
⭐ 面试加分项:
- 能清楚区分 Linear Attention 和 FlashAttention 的目标(近似 vs 精确)
- 理解 causal linear attention 的 running sum 推导过程
- 知道 RWKV/RWKV 是如何将线性注意力做成真正 RNN 的
- 了解 Linformer 的低秩近似 vs Performer 的随机特征近似的区别
Q39: Sparse Attention Pattern(稀疏注意力模式)如何设计?Longformer 和 BigBird 各有什么取舍?
🧠 图解记忆:每行只关心附近几个token+开头+结尾+随机几处,既省内存又保表达力;点击图片可查看原图。
💡 答案要点
当序列超过数千 token 时,O(N²) 的自注意力变得不可承受。Sparse Attention 的设计目标是在保持表达能力的同时降低复杂度。
经典三种模式:
Local Window Attention(局部窗口):
  每个 token 只关注前后 W 个 token
  ├── 优点: 实现最简单,适合局部依赖任务
  ├── 缺点: 无法跨段落传递信息,长距离关系丢失
  └── 复杂度: O(NW)
  └── 应用: Longformer (default setting)

Global Tokens(全局标记):
  固定数量的 token(如 [CLS], start 标记)全局可见
  ├── 优点: 文档级摘要/主题可被所有 token 捕获
  ├── 缺点: 固定的全局 token 可能不够灵活
  └── 典型: 每篇文档选 1-2 个全局 token
  └── 应用: Longformer (global_tokens)

Random Attention(随机注意力):
  每个 token 额外以概率 p 选择几个随机目标 token
  ├── 优点: 理论上保证了信息流通的连通性
  ├── 缺点: 每次 mask 不同,训练需要更多 epoch
  └── 数学保证: 只要 random_per_token ≥ O(log N),图连通概率 → 1
  └── 应用: BigBird
BigBird 的核心定理(保证表达能力):
\"\"\"
BigBird 证明了以下稀疏模式的表达能力与稠密 Attention 等价:

For any two tokens i and j, path(i → j) 存在的概率 ≥ 1 - δ
当:
  - window_size = W(局部窗口)
  - global_tokens = G(全局token)
  - random_per_token = R(每token额外关注的随机数)

且 R ≥ c·log(N) 时(c 是某常数)

这保证了即使只有 O(N·(W + G + log N)) 个注意力连接,
任意两个 token 之间都能通过路径传递信息。
\"\"\"

import numpy as np

def bigbird_sparse_pattern(N, window_size=64, global_tokens=4, random_per_token=4):
    \"\"\"
    生成 BigBird 的稀疏注意力模式
    复杂度: O(N * (window + global + random)) = O(N * (64+4+4)) = O(72N)
    对比稠密: O(N²)
    \"\"\"
    mask = np.zeros((N, N), dtype=bool)

    # 1. Local window
    for i in range(N):
        j_start = max(0, i - window_size//2)
        j_end = min(N, i + window_size//2)
        mask[i, j_start:j_end] = True

    # 2. Global tokens (first and last few)
    global_ids = list(range(global_tokens)) + list(range(N-global_tokens, N))
    for i in range(N):
        mask[i, global_ids] = True
        mask[global_ids, i] = True

    # 3. Random sparse attention
    rng = np.random.default_rng(42)
    for i in range(N):
        random_targets = rng.choice(N, size=random_per_token, replace=False)
        mask[i, random_targets] = True

    return mask

# 示例:N=10000 时稀疏模式占比
N = 10000
mask = bigbird_sparse_pattern(N)
sparsity = mask.sum() / (N*N)
print(f\"Sparsity: {sparsity:.4f} ({sparsity*100:.2f}% of full)\")
# 约 0.76% — 从 100% 降到 0.76%,减少 131 倍!
Longformer vs BigBird 对比:
| 维度 | Longformer | BigBird |
|---|---|---|
| 模式 | 滑动窗口 + 全局 | 滑动窗口 + 全局 + 随机 |
| 复杂度 | O(N·W) | O(N·(W + G + log N)) |
| 实现难度 | ⭐ 简单(已有 flash attention 支持窗口) | ⭐⭐ 较复杂(需要自定义 CUDA kernel) |
| 长程建模 | 依赖全局 token 桥接 | 随机连接提供更强连通性 |
| 适用场景 | 文档分类、NER、长文本 QA | 需要强全局关系的任务 |
| 2026 采用度 | 较高(HuggingFace 原生支持) | 中(理论更好但工程门槛高) |
2026 年的新趋势 — Dynamic Sparse Attention:
\"\"\"
传统稀疏模式是静态预设的。2025-2026 年出现了一批动态方案:

1. DeepSeek Sparse Attention:
   - 基于重要性分数动态选择注意力目标
   - 通过 Lightning Indexer 计算每个 token 对历史的 relevance
   - 只关注 top-K 个重要 token

2. FlexPrefill:
   - 上下文感知:根据输入类型动态调整稀疏模式
   - 推理时实时调整而非训练时固定

3. MInference:
   - 发现注意力权重有三种模式:
     A-Shape(Streaming)/ Vertical-Slash / Block-Sparse
   - 对每种注意力头离线分配最优模式
   - 推理时构建最优稀疏索引
\"\"\"
面试话术:
"Sparse Attention 的核心是在 O(N²) 降到 O(NW) 的同时保证表达能力。BigBird 用窗口+全局+随机三件套,数学上证明了只要随机注意力足够多(O(log N)),信息就能在整篇文章中传递。Longformer 更实用,直接用滑动窗口加少量全局 token。2026 年的趋势是从静态模式转向动态稀疏——根据 token 间的重要性实时选择关注对象。"
⭐ 面试加分项:
- 能画出 BigBird 的三种模式并解释各自的职责
- 理解为什么随机注意力是必要的(保证图的连通性)
- 知道 Longformer 和 BigBird 的工程落地差异
- 了解 2025-2026 年 Dynamic Sparse Attention 的研究进展
上一模块: RAG 系统下一模块: AI Agent 基础
版本: v3.139 | 更新: 2026-10-26 | by 二狗子 🐕