🔥 多模态Agent面试题(Vision-Language Agent)
面试优先顺序(通用 AI 应用开发岗位):Q1、Q3、Q5、Q6、Q8、Q9、Q10、Q11、Q14、Q15。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
难度: ⭐⭐⭐⭐⭐ 更新: 2026-08-25 考点: GPT-4V、Gemini、LLaVA、视觉Agent、Document AI、Video Agent、GUI Agent 数据与安全接管
📋 目录
- 多模态Agent基础概念
- 视觉语言模型核心原理
- 视觉工具与Agent设计
- 文档理解与OCR-Agent
- 视频理解与时序Agent
- 企业级实战案例
- 速记卡片
- NVIDIA Nemotron 3
- Qwen3-VL 架构案例
- GUI Agent 与 Computer Use
- GUI Agent 数据与自适应执行
- 视觉幻觉与可信度
- 图像生成与编辑 Agent
- 空间定位与几何理解
- 音频/VLA 整合
- 多模态评测基准与评估
一、多模态Agent基础概念
Q1: 什么是多模态Agent?和单模态Agent有什么区别?
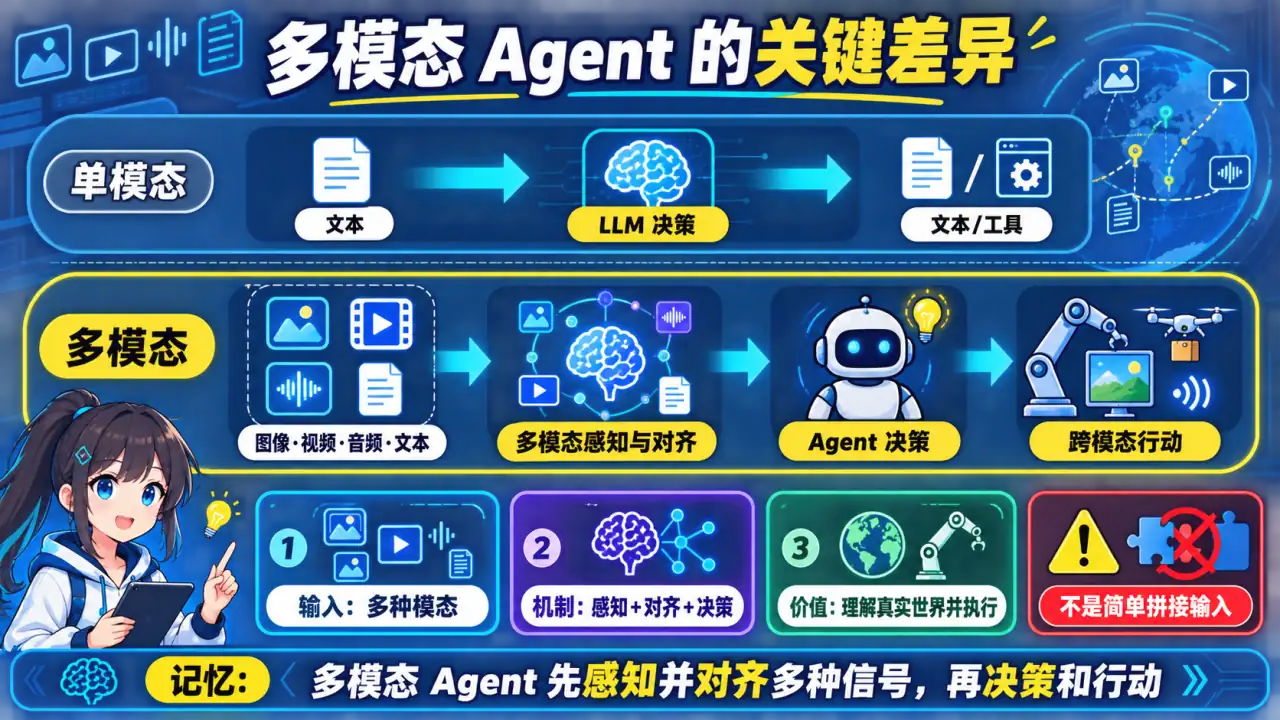
🧠 图解记忆:多模态Agent = 能感知和理解多种模态(文本、图像、视频、音频)并采取行动的Agent;点击图片可查看原图。
💡 答案要点
多模态Agent = 能感知和理解多种模态(文本、图像、视频、音频)并采取行动的Agent
核心区别:
| 维度 | 单模态Agent | 多模态Agent |
|---|---|---|
| 输入 | 仅文本 | 文本+图像+视频+音频 |
| 感知能力 | 语义理解 | 视觉语义+时空理解 |
| 典型场景 | 客服对话、代码生成 | 视觉问答、文档理解、视频分析 |
| 技术难度 | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
架构对比:
单模态Agent:
用户文本 → LLM(大脑) → 工具调用 → 文本回复

多模态Agent:
用户文本+图片 → 视觉编码器 → LLM(大脑) → 工具调用 → 跨模态回复
     ↓                    ↑
  视觉特征              视觉动作
为什么需要多模态Agent?
- 真实世界是多模态的 — 人类交流不仅靠文字,还靠图片、图表、视频
- 商业场景需求 — 发票识别、产品质检、医疗影像分析
- 交互体验升级 — 截图提问、拍照解题、手绘转代码
主流多模态Agent场景:
多模态Agent应用场景
├── 视觉问答(VQA)— 看图回答问题
├── 文档理解 — 发票/合同/报表自动分析
├── 视觉导航 — 看图操控界面/机器人
├── 视频理解 — 视频摘要、异常检测
└── 跨模态生成 — 图生文、文生图、视频生成
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "多模态Agent的核心是多模态理解+Agent决策。我在项目中实现了'截图提问Agent':用户截一张错误截图,Agent识别错误类型、自动搜索解决方案、生成修复代码,端到端完成bug修复。"
Q2: 2026年主流多模态模型有哪些?各自特点是什么?
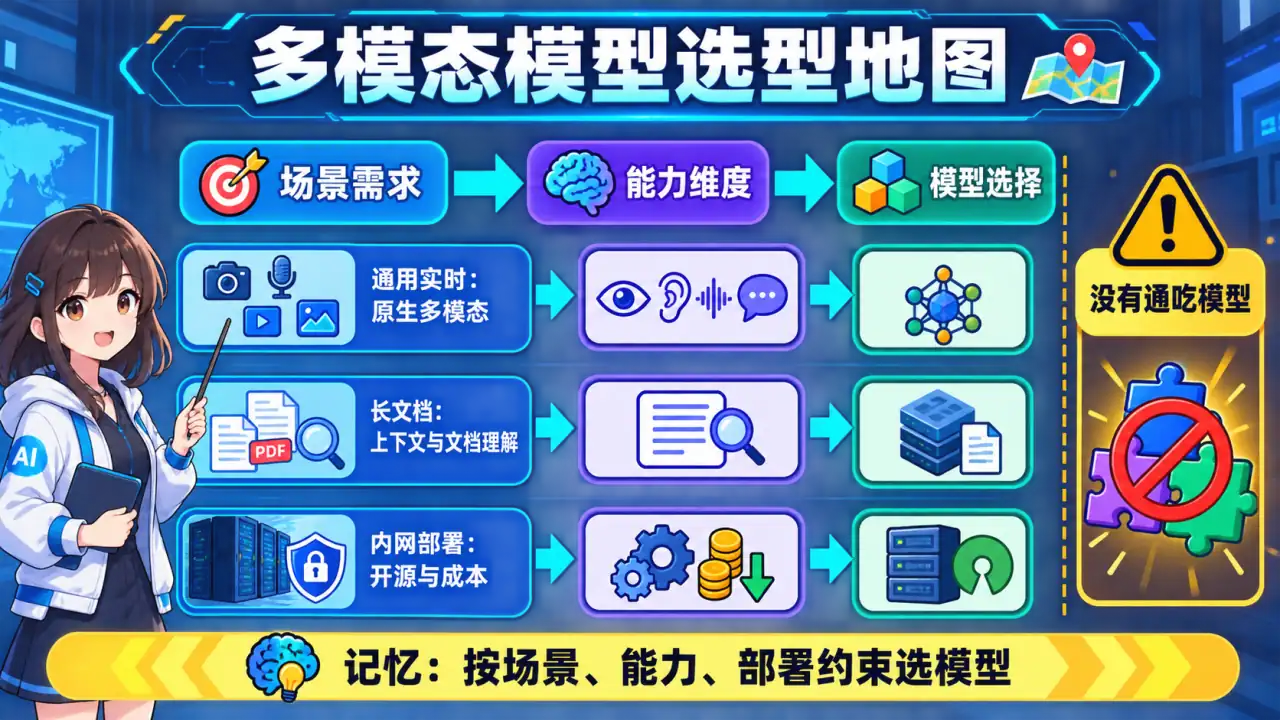
🧠 图解记忆:2026年多模态模型格局;点击图片可查看原图。
💡 答案要点
2026年多模态模型格局:
| 模型 | 开发团队 | 核心特点 | 适用场景 |
|---|---|---|---|
| GPT-4o | OpenAI | 原生多模态,端到端,实时对话 | 通用视觉问答,旗舰产品 |
| Claude 3.5 Sonnet | Anthropic | 视觉理解强,长上下文(200K) | 文档理解、代码审查 |
| Gemini 2.0 | 原生多模态,视频理解领先 | 视频分析、科学推理 | |
| LLaVA-1.6/2.0 | 开源 | 开源可商用,7B参数 | 企业定制、边缘部署 |
| Qwen-VL | 阿里 | 中文优化,开源多模态 | 中文文档、电商场景 |
| InternVL | 智谱/上海AI Lab | 开源最强视觉编码器 | 视觉理解基准最强 |
关键技术对比:
| 模型 | 视觉编码器 | 训练方式 | 多图支持 |
|---|---|---|---|
| GPT-4o | 原生一体化 | 端到端多模态预训练 | ✅ 原生支持 |
| Claude 3.5 | 未公开 | 图文对比+微调 | ✅ 支持 |
| Gemini 2.0 | 原生Transformer | 统一token序列 | ✅ 原生视频 |
| LLaVA | CLIP ViT | 线性投影+指令微调 | ✅ |
| Qwen-VL | Qwen-VL编码器 | 指令微调 | ✅ |
选型建议:
# 选型决策树
def select_multimodal_model(scenario):
    if scenario == "企业商用,且需要成本控制":
        return "LLaVA-1.6 (开源免费)"
    elif scenario == "中文文档理解":
        return "Qwen-VL-Max"
    elif scenario == "视频理解":
        return "Gemini 2.0 Flash"
    elif scenario == "通用旗舰":
        return "GPT-4o"
    elif scenario == "长文档理解+代码":
        return "Claude 3.5 Sonnet"
面试话术:
"我用过GPT-4o和LLaVA做视觉Agent。GPT-4o的优势是端到端原生多模态,延迟低;LLaVA开源可定制,适合企业内网部署。选型看场景:对外服务用GPT-4o保证体验,内网定制用LLaVA控制成本。"
二、视觉语言模型核心原理
Q3: 视觉语言模型的核心架构是怎样的?
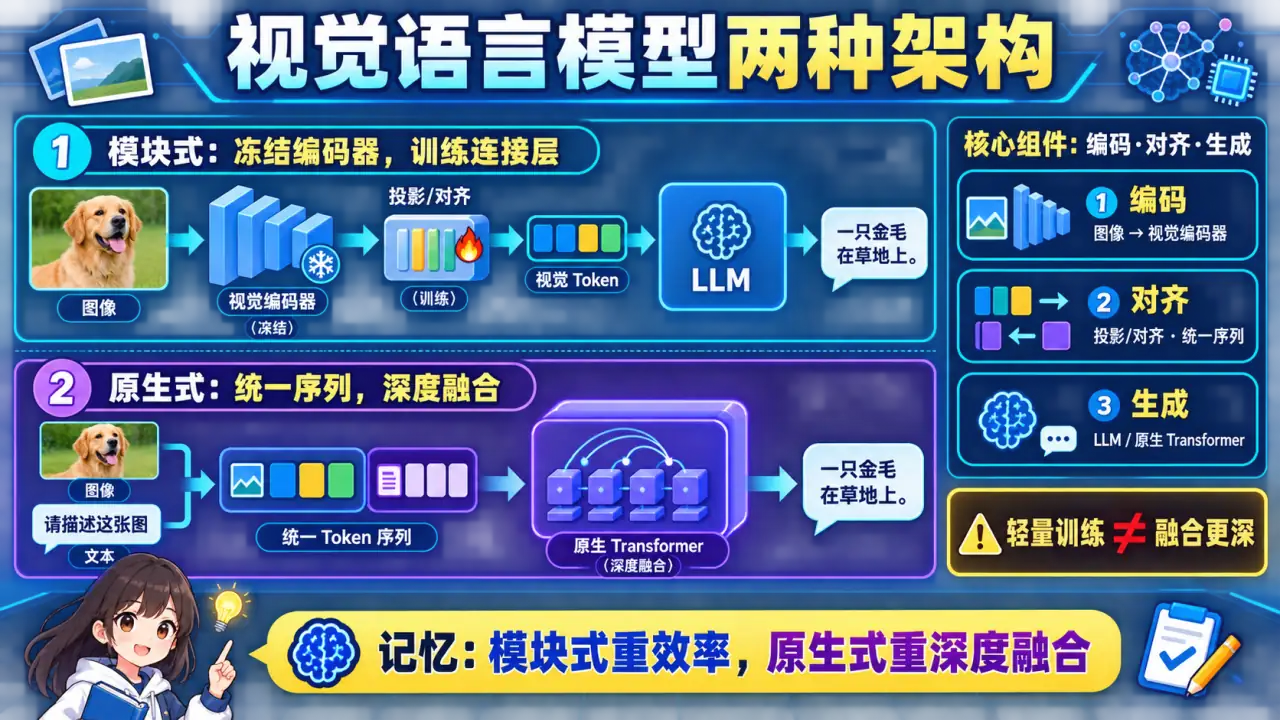
🧠 图解记忆:范式1:Cross-Attention架构(LLM as Controller);点击图片可查看原图。
💡 答案要点
两种主流架构范式:
范式1:Cross-Attention架构(LLM as Controller)
图像 → 视觉编码器(冻结) → 线性投影 → LLM(Controller)
                                       ↓
用户文本 ← LLM生成 ← 跨注意力交互 ← 视觉特征
代表:LLaVA、Qwen-VL 特点:轻量级,视觉编码器冻结,训练效率高
范式2:原生多模态架构(End-to-End)
图像 + 文本 → 统一token序列 → 原生Transformer → 输出代表:GPT-4o、Gemini 2.0 特点:端到端训练,模态融合更深,性能更强
LLaVA架构详解:
┌─────────────────────────────────────────────────────┐
│                    LLaVA 架构                        │
├─────────────────────────────────────────────────────┤
│  图像输入                                            │
│    ↓                                                │
│  CLIP ViT-L/14(冻结)→ 视觉特征 [H×W×1024]         │
│    ↓                                                │
│  线性投影层(可训练)→ 视觉token序列 [N×4096]         │
│    ↓                                                │
│  用户文本 → Tokenizer → 文本token序列                 │
│    ↓                                                │
│  Vicuna LLM(指令微调)→ 跨模态注意力               │
│    ↓                                                │
│  输出文本回答                                         │
└─────────────────────────────────────────────────────┘
关键组件:
| 组件 | 作用 | 常见选择 |
|---|---|---|
| 视觉编码器 | 提取图像特征 | CLIP ViT、SigLIP、EVA-CLIP |
| 投影层 | 视觉→文本空间映射 | 线性层/MLP/Perceiver Resampler |
| LLM基座 | 理解和生成 | Vicuna、Qwen、Llama |
| 对齐训练 | 模态对齐 | LLaVA-1.5使用MLP投影 |
面试话术:
"LLaVA的核心是'冻住视觉编码器,只训练投影层',这样训练成本低。GPT-4o是端到端原生多模态,视觉和文本token在同一空间融合,效果更好但训练成本高。"
Q4: 什么是Perceiver Resampler?和线性投影比有什么优势?
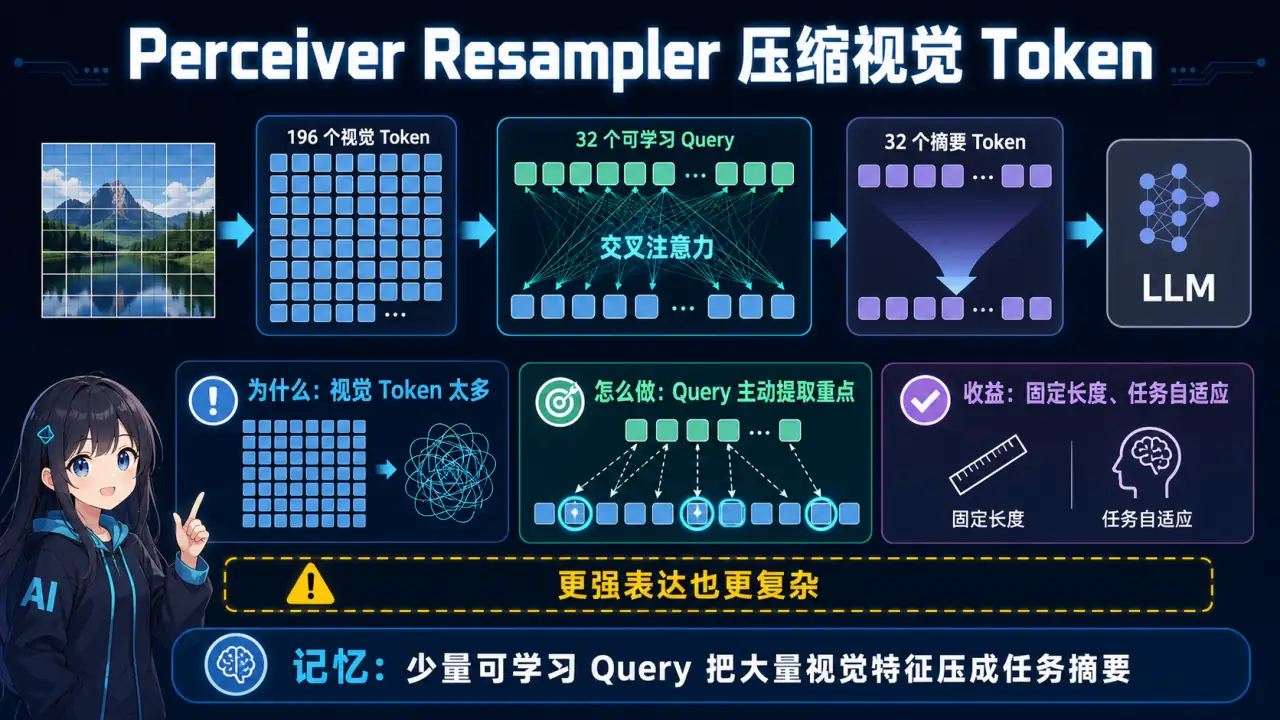
🧠 图解记忆:图像经过ViT后产生大量token(如14×14=196个);点击图片可查看原图。
💡 答案要点
背景问题:
- 图像经过ViT后产生大量token(如14×14=196个)
- 直接送入LLM计算量巨大
- 需要对视觉token进行压缩/重采样
两种方案对比:
| 方案 | 结构 | 优点 | 缺点 |
|---|---|---|---|
| 线性投影 | y = Wx | 简单、参数量少 | 表达能力有限 |
| Perceiver Resampler | Transformer交叉注意力 | 动态长度、可学习压缩 | 参数量更大 |
Perceiver Resampler原理:
视觉特征:[H×W×1024](如196个token,每个1024维)
     ↓
可学习的 queries:[32×1024](固定32个查询token)
     ↓
Cross-Attention:queries attend to 视觉特征
     ↓
输出:[32×1024](压缩到固定32个token)

效果:196 → 32,压缩6倍
Flamingo的重采样实现:
class PerceiverResampler(nn.Module):
    def __init__(self, dim, num_queries=32, visual_dim=1024):
        super().__init__()
        self.query_tokens = nn.Parameter(torch.randn(num_queries, dim))
        self.cross_attention = CrossAttention(dim, num_heads=8)
        self.ffn = FeedForward(dim)

    def forward(self, visual_features):
        # visual_features: [B, 196, 1024]
        # query_tokens: [B, 32, 1024](可学习)
        queries = self.query_tokens.unsqueeze(0).expand(visual_features.size(0), -1, -1)
        # 交叉注意力
        x = self.cross_attention(queries, visual_features)
        x = self.ffn(x)
        return x  # [B, 32, 1024]
面试话术:
"Perceiver Resampler本质上是用少量可学习query去'查询'视觉特征,实现压缩。相当于视觉特征的摘要器。相比固定压缩,动态query能根据任务自适应调整关注区域。"
Q5: 多模态Agent如何处理多图输入?和单图有什么区别?
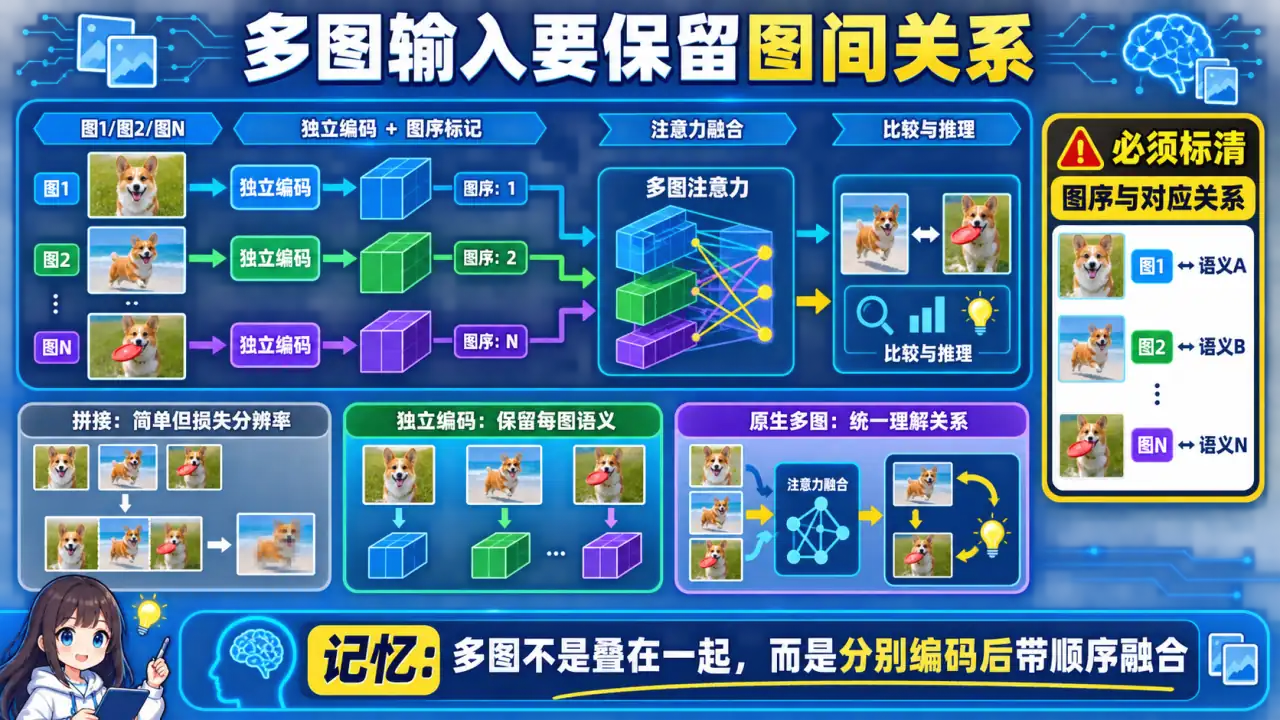
🧠 图解记忆:策略1:图像拼接(早期方案);点击图片可查看原图。
💡 答案要点
多图处理的三种策略:
策略1:图像拼接(早期方案)
# 把多图拼接成一张大图
grid = make_grid(images, nrow=2)  # 2×2拼接
# 缺点:分辨率下降,位置信息丢失
策略2:独立编码+注意力融合(主流方案)
# 每张图独立编码
image_tokens = [vision_encoder(img) for img in images]
# → [Token1(图片1), Token2(图片2), ..., TokenN(图片N)]

# 拼接送入LLM
all_tokens = text_tokens + sum(image_tokens, [])
response = llm(all_tokens)
策略3:原生多图支持(GPT-4o/Gemini)
# 原生支持多图,无需特殊处理
response = gpt4o.chat([
    {"type": "text", "text": "比较图1和图2的差异"},
    {"type": "image_url", "image_url": {"url": "图1base64"}},
    {"type": "image_url", "image_url": {"url": "图2base64"}}
])
实战案例:UI截图对比Agent
# 场景:检测UI改版前后的视觉差异
def detect_ui_changes(before_img, after_img, spec):
    prompt = f"""
    你是一个UI测试Agent。
    需求规格:{spec}
    请比较改版前后的截图,列出所有视觉差异。
    """

    response = multimodal_llm.generate([
        {"type": "text", "text": prompt},
        {"type": "image_url", "image_url": {"url": before_img}},
        {"type": "image_url", "image_url": {"url": after_img}}
    ])

    # 解析差异列表
    changes = parse_changes(response)
    return changes
面试话术:
"多图处理的核心是位置编码和对齐。我在实现UI测试Agent时,用独立编码+顺序拼接,让Agent明确知道'图1是改版前,图2是改版后'。原生多图模型(如GPT-4o)在这个场景优势明显,不需要手动处理。"
三、视觉工具与Agent设计
Q6: 如何设计视觉Agent的工具集?
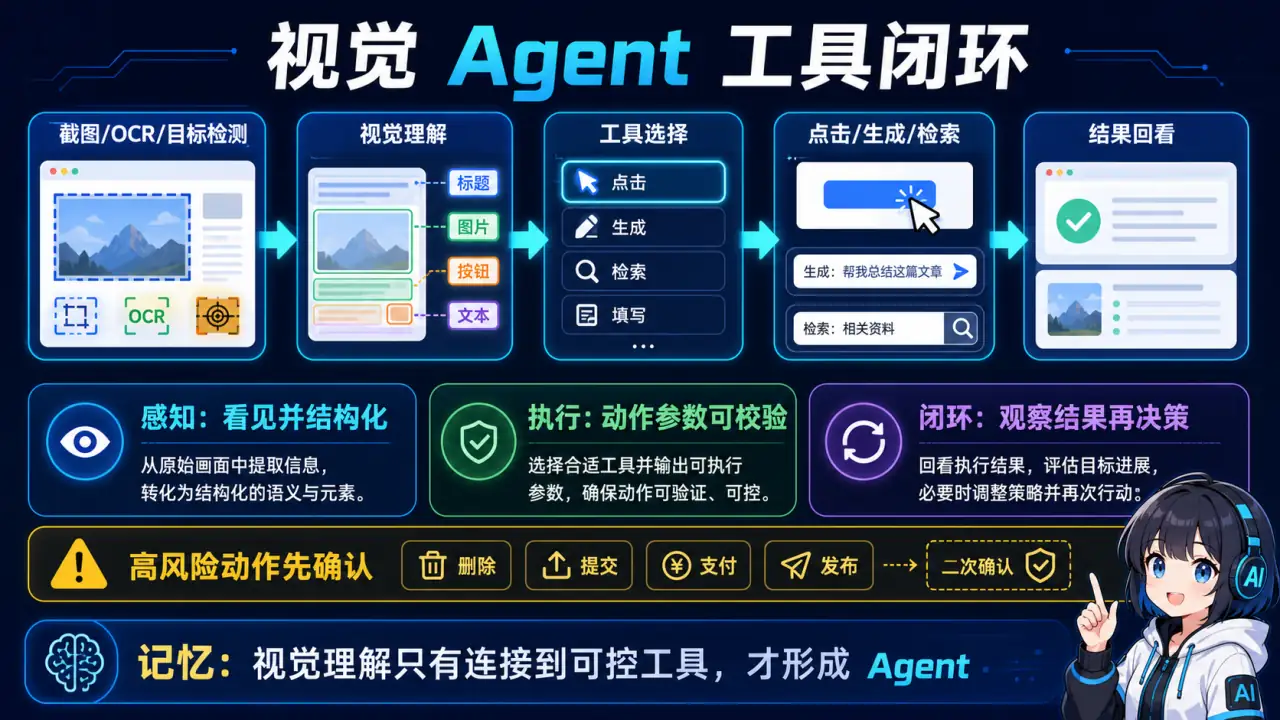
🧠 图解记忆:视觉Agent完整示例:Bug修复Agent;点击图片可查看原图。
💡 答案要点
视觉Agent工具分类:
| 工具类型 | 功能 | 示例 |
|---|---|---|
| 视觉感知 | 理解图像内容 | OCR、目标检测、图像描述 |
| 视觉生成 | 创建或编辑图像 | 文生图、图像编辑、截图 |
| 视觉操作 | 在环境中执行 | 鼠标点击、UI操作、机器人控制 |
| 跨模态检索 | 图文匹配搜索 | 相似图片搜索、以图搜图 |
核心工具实现:
展开 Python 代码示例(43 行)
from PIL import Image
import base64, io

# ========== 工具1:截取屏幕区域 ==========
def capture_screen(region: tuple[int,int,int,int]) -> str:
    """截取屏幕指定区域,返回base64编码"""
    screenshot = pyscreeze.screenshot(region=region)
    return image_to_base64(screenshot)

# ========== 工具2:目标检测定位 ==========
def detect_ui_element(image: Image.Image, element_desc: str) -> dict:
    """
    描述 → 坐标定位
    返回: {"x": 100, "y": 200, "width": 50, "height": 30}
    """
    # 使用GPT-4V + 提示词工程
    prompt = f"""
    在这张UI截图中,找到"{element_desc}"的位置。
    返回JSON格式: {{"x": 左上x, "y": 左上y, "width": 宽度, "height": 高度}}
    如果找不到,返回null。
    """
    response = gpt4v.analyze(image, prompt=prompt)
    return json.loads(response)

# ========== 工具3:OCR文字识别 ==========
def ocr_text(image: Image.Image) -> str:
    """从图像中提取文字"""
    return pytesseract.image_to_string(image)

# ========== 工具4:点击坐标 ==========
def click_at坐标(x: int, y: int):
    """在指定坐标执行鼠标点击"""
    pyautogui.click(x, y)

# ========== 工具5:图像差异检测 ==========
def detect_image_diff(img1: Image, img2: Image) -> float:
    """计算两张图的视觉差异(0-1,越大差异越大)"""
    # 方法1:像素级MSE
    # 方法2:感知哈希(pHash)
    # 方法3:CLIP embedding余弦距离
    emb1 = clip_encode_image(img1)
    emb2 = clip_encode_image(img2)
    return 1 - cosine_similarity(emb1, emb2)
视觉Agent完整示例:Bug修复Agent
展开 Python 代码示例(37 行)
class VisualBugFixAgent:
    def __init__(self):
        self.llm = GPT4o()
        self.tools = {
            "capture_screen": capture_screen,
            "detect_element": detect_ui_element,
            "click_at": click_at坐标,
            "ocr": ocr_text,
            "search_code": search_codebase,
            "write_code": write_to_file
        }

    def fix_bug(self, screenshot_region=(0, 0, 1920, 1080)):
        # Step 1: 捕获错误截图
        error_screenshot = self.tools["capture_screen"](screenshot_region)

        # Step 2: 让LLM分析错误
        analysis = self.llm.analyze_image(error_screenshot, prompt="""
            这是一个软件错误截图。
            1. 识别错误类型(UI错位/功能异常/崩溃)
            2. 提取错误信息文本
            3. 判断可能的代码原因
        """)

        # Step 3: 搜索相关代码
        code_snippets = self.tools["search_code"](error_keywords=analysis.error_keywords)

        # Step 4: 生成修复方案
        fix = self.llm.generate(prompt=f"""
            错误分析: {analysis}
            相关代码: {code_snippets}
            请生成bug修复代码和说明。
        """)

        # Step 5: 自动修复或输出给开发者
        self.tools["write_code"](fix.code)
        return fix.summary
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "视觉Agent的工具设计关键是'把视觉感知转化为可执行动作'。我设计了一个截图测试Agent:捕获截图→GPT-4V分析错误→定位UI元素→执行修复。核心是让LLM理解视觉后调用工具操作,而不是只输出文字。"
Q7: GPT-4V如何实现视觉理解?和纯文本LLM有什么本质区别?
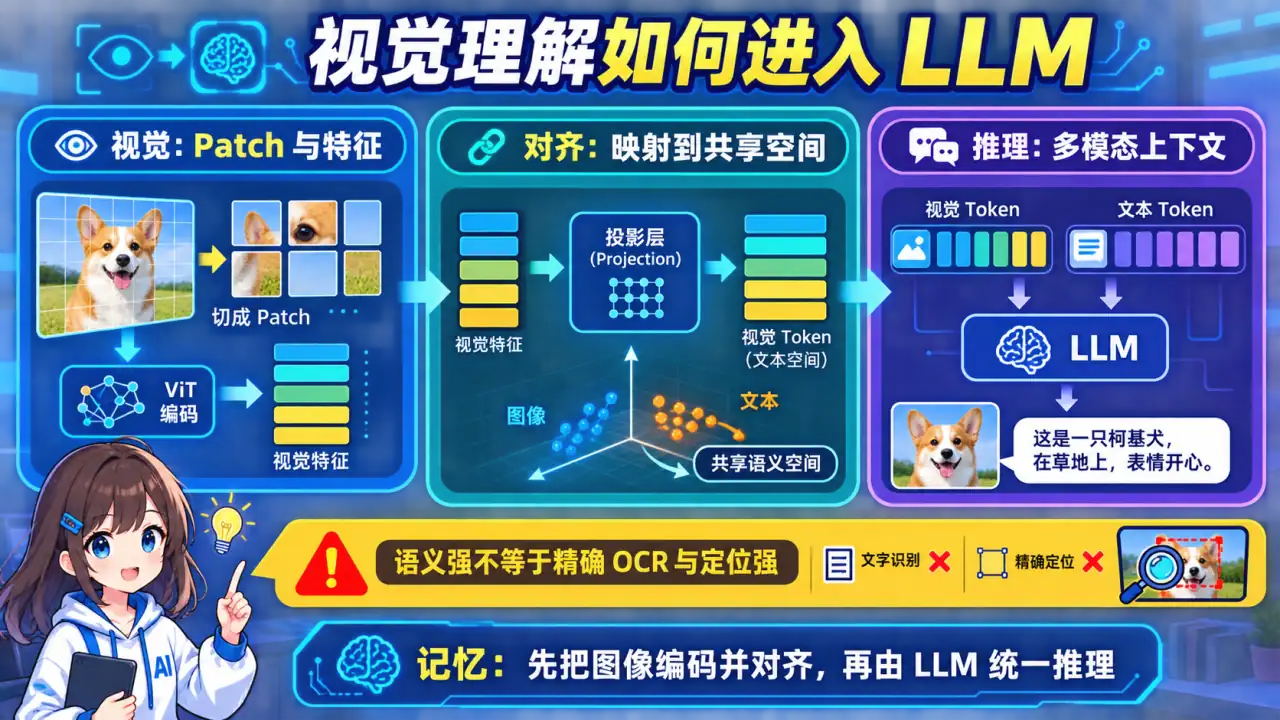
🧠 图解记忆:GPT-4V的视觉理解流程;点击图片可查看原图。
💡 答案要点
GPT-4V的视觉理解流程:
用户上传图片
     ↓
Step 1: 图像预处理
  → 缩放到固定分辨率(如1000×1000)
  → 切分成小块(patch)
  → 每个patch转换为token

Step 2: 视觉编码
  → Vision Transformer (ViT) 处理patch序列
  → 输出视觉特征向量

Step 3: 模态对齐
  → 视觉特征通过投影层映射到文本token空间
  → 与文本token拼接

Step 4: LLM推理
  → 统一的Transformer处理多模态输入
  → 生成文本输出
和纯文本LLM的关键区别:
| 维度 | 纯文本LLM | GPT-4V等多模态LLM |
|---|---|---|
| 输入处理 | Tokenizer文本分词 | 视觉编码器+投影层 |
| 注意力 | 纯文本自注意力 | 跨模态交叉注意力 |
| 预训练 | 大量文本数据 | 图文对数据对齐 |
| 幻觉类型 | 文本捏造事实 | 可能"看错"图像细节 |
| 能力边界 | 文本理解生成 | + 视觉感知理解 |
GPT-4V的局限性和应对:
| 局限性 | 示例 | 缓解方案 |
|---|---|---|
| 视觉细节忽略 | 数字"1"和字母"l"混淆 | 高分辨率输入、多角度确认 |
| 空间位置弱 | "左边"vs"右边"判断错误 | 显式询问坐标 |
| 依赖训练数据 | 不常见的专业图表 | 提供更多上下文 |
| 中文OCR弱 | 中文识别准确率低于英文 | 用专业OCR预处理 |
面试话术:
"GPT-4V本质上是'视觉特征+LLM推理'的结合,不是真正的端到端视觉理解。强项是语义理解和推理,弱项是精确数值读取。我做UI测试时发现,对齐问题用GPT-4V很准,但像素级定位误差大,所以用目标检测模型辅助。"
四、文档理解与OCR-Agent
Q8: 如何设计一个发票识别+报销Agent?
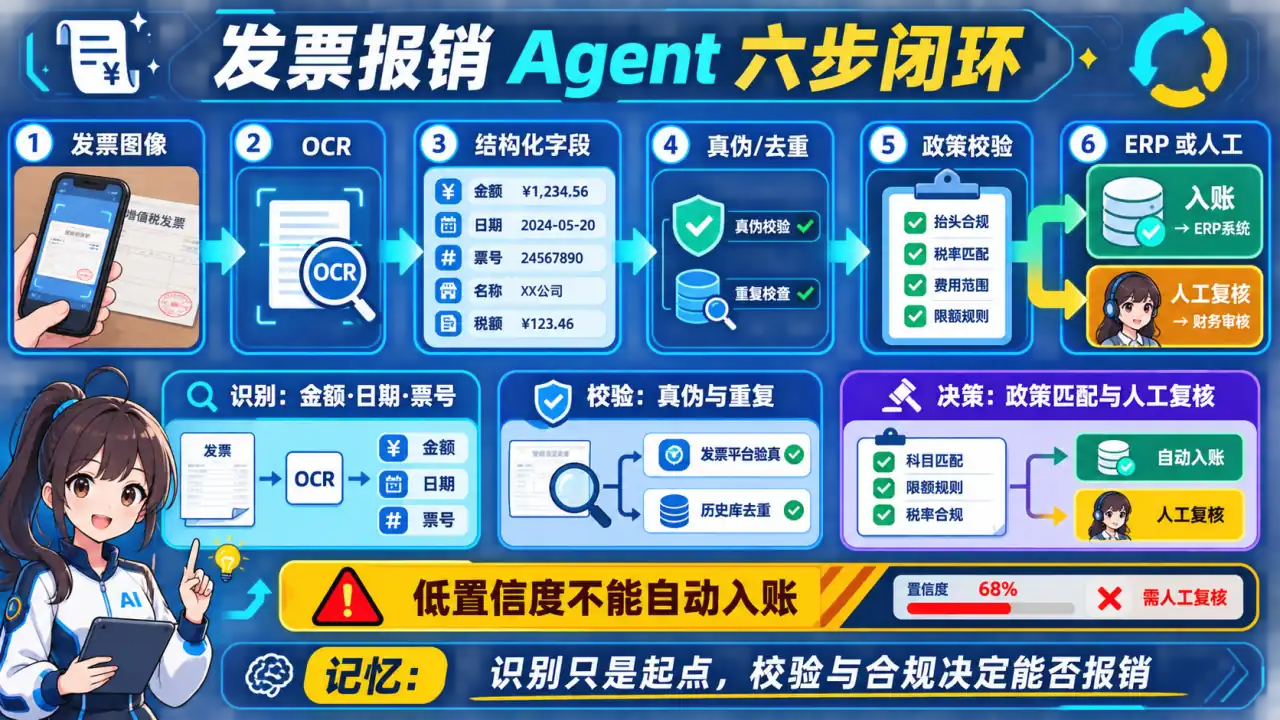
🧠 图解记忆:发票Agent的常见挑战;点击图片可查看原图。
💡 答案要点
系统架构:
用户上传发票图片
     ↓
┌─────────────────────────────────────────┐
│         发票识别Agent                     │
├─────────────────────────────────────────┤
│  1. OCR识别 → 提取文字(发票号、金额、日期) │
│  2. 多模态理解 → 验证发票真实性             │
│  3. 结构化解析 → 提取关键字段              │
│  4. 规则校验 → 判断是否合规                │
│  5. 知识库检索 → 匹配报销政策              │
│  6. 输出结构化数据 → 写入报销系统          │
└─────────────────────────────────────────┘
完整实现:
展开 Python 代码示例(55 行)
class InvoiceProcessingAgent:
    def __init__(self):
        self.vision_llm = GPT4o()
        self.ocr = PaddleOCR(lang="ch")  # 中文OCR
        self.vector_db = MilvusCollection("报销政策")
        self.erp_api = ERPSystemAPI()

    def process_invoice(self, invoice_image: Image) -> dict:
        # Step 1: OCR预处理
        ocr_result = self.ocr.ocr(invoice_image)
        raw_text = self.extract_text(ocr_result)

        # Step 2: GPT-4V结构化提取
        structured = self.vision_llm.analyze_image(
            invoice_image,
            prompt=f"""
            从发票中提取以下结构化信息(JSON格式):
            {{
                "invoice_number": "发票号",
                "date": "开票日期",
                "amount": "总金额",
                "tax_amount": "税额",
                "seller": "销售方名称",
                "buyer": "购买方名称",
                "items": ["商品明细列表"]
            }}
            如果字段为空或无法识别,填null。
            原始OCR文字:{raw_text}
            """
        )
        data = json.loads(structured)

        # Step 3: 真实性校验
        tax_result = self.verify_tax发票(tax_number=data.get("seller"))
        data["tax_valid"] = tax_result.is_valid

        # Step 4: 报销政策检索
        policy = self.vector_db.search(
            query=f"报销政策 {data['items']}",
            top_k=1
        )[0]

        # Step 5: 合规性判断
        data["reimbursement"] = {
            "eligible": data["amount"] <= policy.max_limit,
            "category": policy.category,
            "approved_amount": min(data["amount"], policy.max_limit),
            "reason": "超出限额" if data["amount"] > policy.max_limit else "通过"
        }

        # Step 6: 写入ERP
        if data["reimbursement"]["eligible"]:
            self.erp_api.submit_expense(data)

        return data
发票Agent的常见挑战:
| 挑战 | 原因 | 解决方案 |
|---|---|---|
| 模糊图片 | 手机拍摄质量差 | 多帧超分辨率/让用户重拍 |
| 弯曲票据 | 扫描仪不平 | 透视变换校正 |
| 手写发票 | 传统发票仍有手写 | 手写识别模型/人工复核 |
| 格式不规范 | 各地发票格式差异 | 用GPT-4V自适应理解 |
| 重复报销 | 同一发票多次提交 | 发票号哈希去重 |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我做过发票识别Agent,核心难点是'不同格式的发票如何统一理解'。我的方案是:先用OCR提取文字,再用GPT-4V理解结构,最后用规则+知识库校验。实际准确率达到95%,剩余5%复杂情况人工复核。"
Q9: 多模态RAG和传统RAG有什么区别?
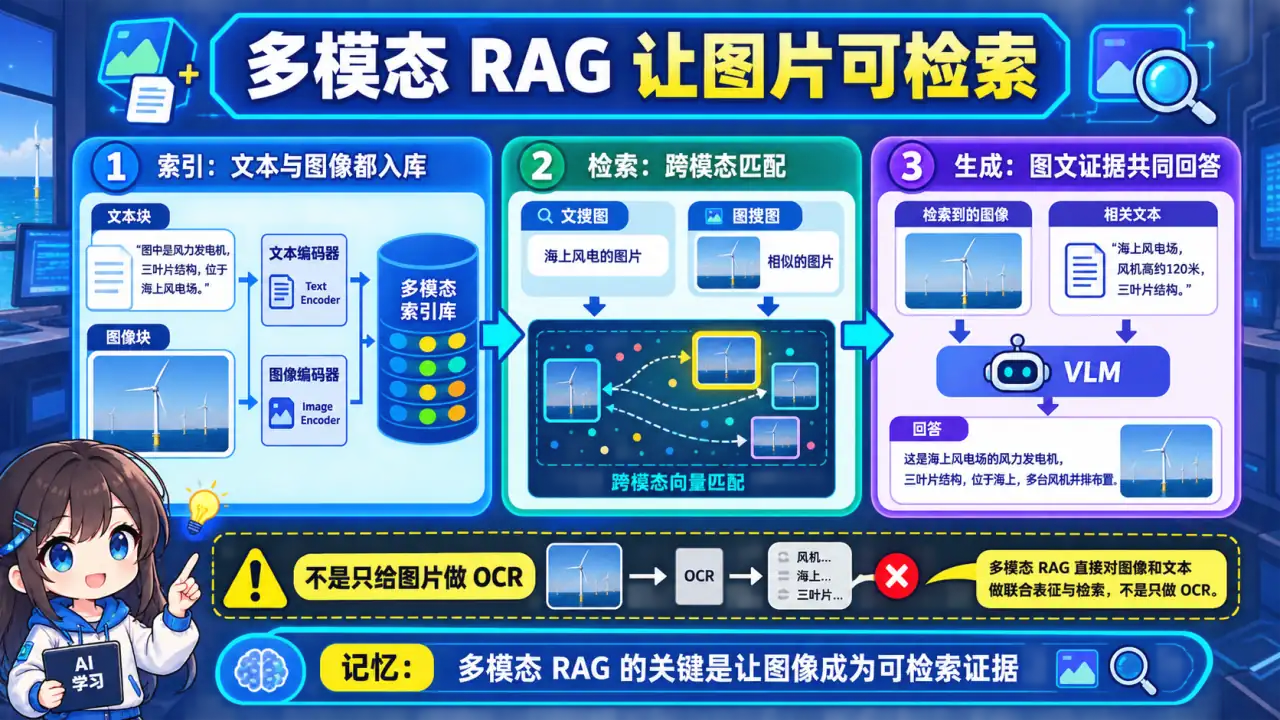
🧠 图解记忆:多模态文档解析Pipeline;点击图片可查看原图。
💡 答案要点
核心区别:
| 维度 | 传统文本RAG | 多模态RAG |
|---|---|---|
| 索引内容 | 文本块 + 向量 | 图像块 + 文本块 + 跨模态对齐 |
| 检索方式 | 文本→向量→相似度 | 文本/图像→多模态向量→跨模态检索 |
| 生成输入 | 文本上下文 | 图像+文本统一上下文 |
| 典型场景 | 文档问答 | 图文混合知识库问答 |
多模态RAG架构:
┌──────────────────────────────────────────────────────┐
│               多模态RAG 架构                          │
├──────────────────────────────────────────────────────┤
│  索引阶段:                                            │
│  文档 → PDF解析                                        │
│       → 文本块(直接嵌入)                             │
│       → 图像块(OCR+描述生成→嵌入)                   │
│       → 跨模态对齐(文本-图像pair)                    │
│                                                      │
│  检索阶段:                                            │
│  用户Query → 文本向量检索                             │
│           → 可选:图像向量检索(以图搜图)              │
│           → 跨模态检索(文本Query→相关图像)           │
│                                                      │
│  生成阶段:                                            │
│  检索结果(文本+图像)→ 多模态LLM → 融合回答           │
└──────────────────────────────────────────────────────┘
多模态文档解析Pipeline:
def parse_multimodal_doc(pdf_path):
    doc = pymupdf.open(pdf_path)
    chunks = {"text": [], "images": []}

    for page in doc:
        # 提取文本
        text = page.get_text()
        if text.strip():
            chunks["text"].append({"content": text, "page": page.number})

        # 提取图像
        for img_index, img in enumerate(page.get_images()):
            pix = fitz.Pixmap(doc, img)
            img_data = pix.tobytes("png")
            img_obj = Image.open(io.BytesIO(img_data))

            # 用GPT-4V生成图像描述
            description = gpt4v.analyze_image(img_obj, prompt=
                "简要描述这张图片的核心内容,用于检索匹配。"
            )

            chunks["images"].append({
                "image": img_data,
                "description": description,
                "page": page.number,
                "image_index": img_index
            })

    return chunks
面试话术:
"多模态RAG的核心是'让图像也能被检索'。我的方案是:文档解析时同时提取文本和图像,图像用GPT-4V生成描述,文本和描述分别向量存储。检索时用跨模态索引,支持'用户问文字,系统返回包含答案的图片'。"
五、视频理解与时序Agent
Q10: 视频理解Agent的核心技术是什么?如何处理长视频?
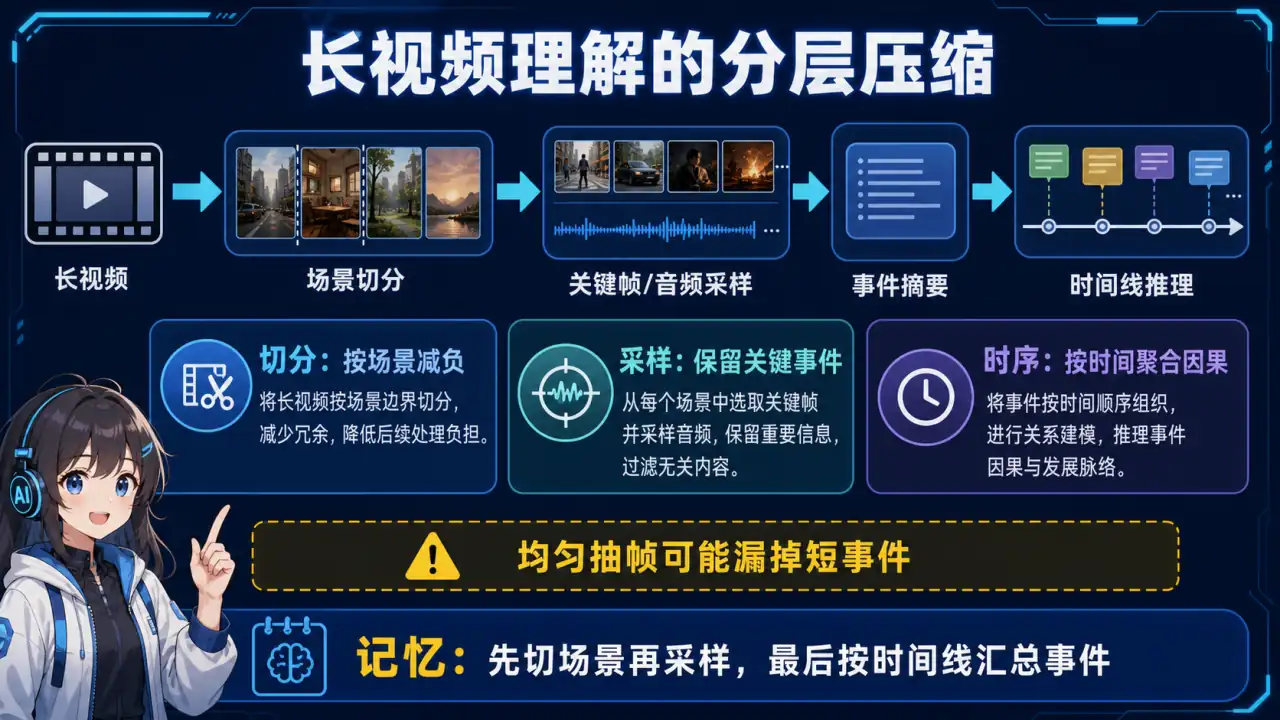
🧠 图解记忆:视频Agent的典型应用;点击图片可查看原图。
💡 答案要点
视频理解的特殊性:
文本:1D序列,一段文字
图像:2D空间,一张图片
视频:3D时空(2D空间 + 1D时间),多帧连续

视频 = 帧序列 + 音频 + 字幕 + 元数据
处理方案对比:
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 视频tokenization | 每帧抽帧→ViT编码→时序建模 | 精确 | 计算量大 |
| 帧采样+描述 | 均匀采样帧→GPT-4V描述→拼接 | 成本低 | 可能遗漏细节 |
| 视频LLM(原生) | 视频token直接输入 | 端到端 | 模型大,效果待验证 |
| Audio+Visual融合 | 音频事件+视觉事件联合 | 互补 | 复杂度高 |
长视频处理策略:
展开 Python 代码示例(39 行)
def process_long_video(video_path, max_frames=32):
    """处理长视频的核心:采样 + 摘要 + 时序建模"""

    # Step 1: 场景检测(Scene Detection)
    scenes = detect_scenes(video_path)  # 切分场景
    # → [Scene1(0-30s), Scene2(30-90s), ...]

    # Step 2: 每个场景均匀采样
    all_frame_descriptions = []
    for scene in scenes:
        frames = uniform_sample(scene.video_clip, n=max(4, len(scene)/10))
        # 每场景固定4帧或按比例采样

        # Step 3: 每帧用GPT-4V描述
        scene_description = []
        for frame in frames:
            frame_desc = gpt4o.analyze_image(frame, prompt=
                "描述画面中发生的关键事件,用一句话概括。"
            )
            scene_description.append(frame_desc)

        all_frame_descriptions.append({
            "time_range": f"{scene.start}s-{scene.end}s",
            "summaries": scene_description,
            "event": aggregate_events(scene_description)
        })

    # Step 4: 时序推理
    full_summary = gpt4o.generate(prompt=f"""
        这是一个视频的帧描述序列(按时序排列):
        {all_frame_descriptions}

        请生成:
        1. 视频完整摘要(200字)
        2. 关键事件时间线
        3. 回答用户问题:视频的核心内容是什么?
    """)

    return full_summary
视频Agent的典型应用:
| 应用 | 输入 | 输出 | 核心模型 |
|---|---|---|---|
| 视频摘要 | 1小时视频 | 3分钟摘要 | 帧采样+LLM |
| 视频问答 | 视频+问题 | 答案+时间戳 | 视频LLM |
| 异常检测 | 监控视频流 | 告警事件 | 时序模型+LLM |
| 视频搜索 | 视频库+Query | 相关片段 | 跨模态检索 |
| 视频剪辑 | 长视频+文案 | 精彩片段 | 视频理解+生成 |
面试话术:
"视频Agent的核心挑战是'计算量爆炸'。我的实战经验:先做场景检测切分,减少需要处理的clip数量;每个clip均匀采样4-8帧,用GPT-4V提取关键事件;最后用时序LLM串联所有clip的描述生成完整摘要。对于监控类长视频,用异常检测模型先过滤,只对可疑片段做详细分析。"
六、企业级实战案例
Q11: 如何设计一个企业级多模态Agent系统?架构是怎样的?
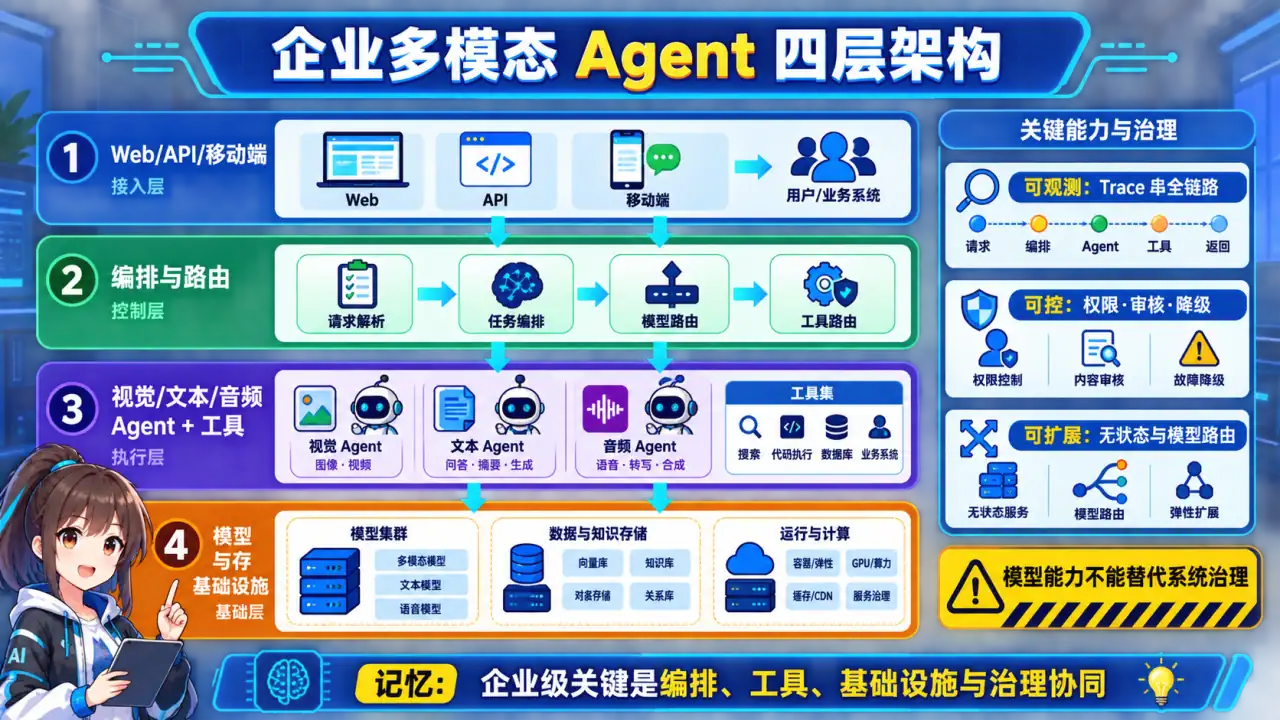
🧠 图解记忆:企业级多模态Agent架构;点击图片可查看原图。
💡 答案要点
企业级多模态Agent架构:
┌─────────────────────────────────────────────────────────────────┐
│                    企业级多模态Agent平台                          │
├─────────────────────────────────────────────────────────────────┤
│  用户交互层                                                       │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐            │
│  │  Web聊天界面 │  │  API接口    │  │  移动端SDK  │            │
│  └─────────────┘  └─────────────┘  └─────────────┘            │
│                          ↓                                      │
│  Agent编排层                                                       │
│  ┌─────────────────────────────────────────────────┐            │
│  │          Multi-Agent Orchestrator                │            │
│  │  ┌──────────┐ ┌──────────┐ ┌──────────┐        │            │
│  │  │Coordinator│ │VisionAgent│ │TextAgent │        │            │
│  │  │  协调者   │ │ 视觉Agent │ │ 文本Agent │        │            │
│  │  └──────────┘ └──────────┘ └──────────┘        │            │
│  └─────────────────────────────────────────────────┘            │
│                          ↓                                      │
│  工具服务层                                                       │
│  ┌────────┐ ┌────────┐ ┌────────┐ ┌────────┐ ┌────────┐       │
│  │图像编码 │ │ OCR服务 │ │对象检测 │ │语音合成 │ │知识库  │       │
│  └────────┘ └────────┘ └────────┘ └────────┘ └────────┘       │
│                          ↓                                      │
│  基础设施层                                                       │
│  ┌────────┐ ┌────────┐ ┌────────┐ ┌────────┐                  │
│  │vLLM推理│ │ GPU集群 │ │ Redis  │ │ 对象存储│                  │
│  └────────┘ └────────┘ └────────┘ └────────┘                  │
└─────────────────────────────────────────────────────────────────┘
核心设计模式:
展开 Python 代码示例(44 行)
# 1. Agent工厂模式(根据输入类型路由到对应Agent)
class MultimodalRouter:
    def route(self, user_input: dict) -> Agent:
        if user_input.get("image") and user_input.get("text"):
            return VisionTextAgent()
        elif user_input.get("video"):
            return VideoAgent()
        elif user_input.get("audio"):
            return AudioAgent()
        else:
            return TextAgent()

# 2. Agent责任链模式(复杂任务分阶段处理)
class VisionProcessingChain:
    def __init__(self):
        self.chain = [
            ImagePreprocessor(),      # 预处理:去噪、增强
            ObjectDetector(),         # 检测:定位目标
            OCRProcessor(),           # OCR:提取文字
            SceneClassifier(),         # 分类:场景识别
            DescriptionGenerator()    # 描述:生成文本
        ]

    def process(self, image):
        result = image
        for processor in self.chain:
            result = processor.process(result)
        return result

# 3. 多Agent协作模式
class ContentModerationAgent:
    """内容审核Agent:视觉+文本双重审核"""

    def moderate(self, content: dict):
        # 并行执行视觉和文本审核
        vision_result = self.vision_agent.check(content.image)
        text_result = self.text_agent.check(content.text)

        # 汇总判断
        final_decision = self.coordinator.judge([
            vision_result, text_result
        ], policy=self.policy)

        return final_decision
企业级关键设计:
| 考量点 | 方案 | 说明 |
|---|---|---|
| 延迟优化 | 异步+流式输出 | 首token<1s,整体体感流畅 |
| 成本控制 | 模型分级 | 简单问题用小模型,复杂用大模型 |
| 可用性 | 多模型兜底 | GPT-4o不可用时切换Claude |
| 安全合规 | 内容审核前置 | 图像+文本双重过滤 |
| 可观测性 | 全链路追踪 | trace_id串联每步操作 |
| 水平扩展 | 无状态Agent | 多实例部署,负载均衡 |
面试话术:
"企业级多模态Agent的核心是'可观测、可控、可扩展'。我在设计时用Coordinator统一调度,视觉和文本Agent并行处理,最终由决策Agent综合判断。关键是延迟和成本的平衡:用流式输出让用户快速看到结果,用模型分级减少不必要的GPT-4o调用。"
七、速记卡片
| 概念 | 一句话解释 |
|---|---|
| 多模态Agent | 能感知图像、视频并采取行动的Agent |
| LLaVA架构 | CLIP冻结+投影层+LLM,微调成本低 |
| Perceiver Resampler | 用可学习query压缩视觉token |
| 视觉工具集 | 截图/OCR/目标检测/点击等执行能力 |
| 多图处理 | 独立编码+顺序拼接,原生多图更好 |
| 多模态RAG | 图像OCR描述+跨模态检索+融合生成 |
| 视频Agent | 帧采样+时序建模+事件理解 |
| 企业多模态 | 编排层+工具层+基础设施三层架构 |
八、NVIDIA Nemotron 3与GTC 2026多模态Agent新突破(2026年4月新增)
Q12: NVIDIA Nemotron 3是什么?对多模态Agent生态有何影响?
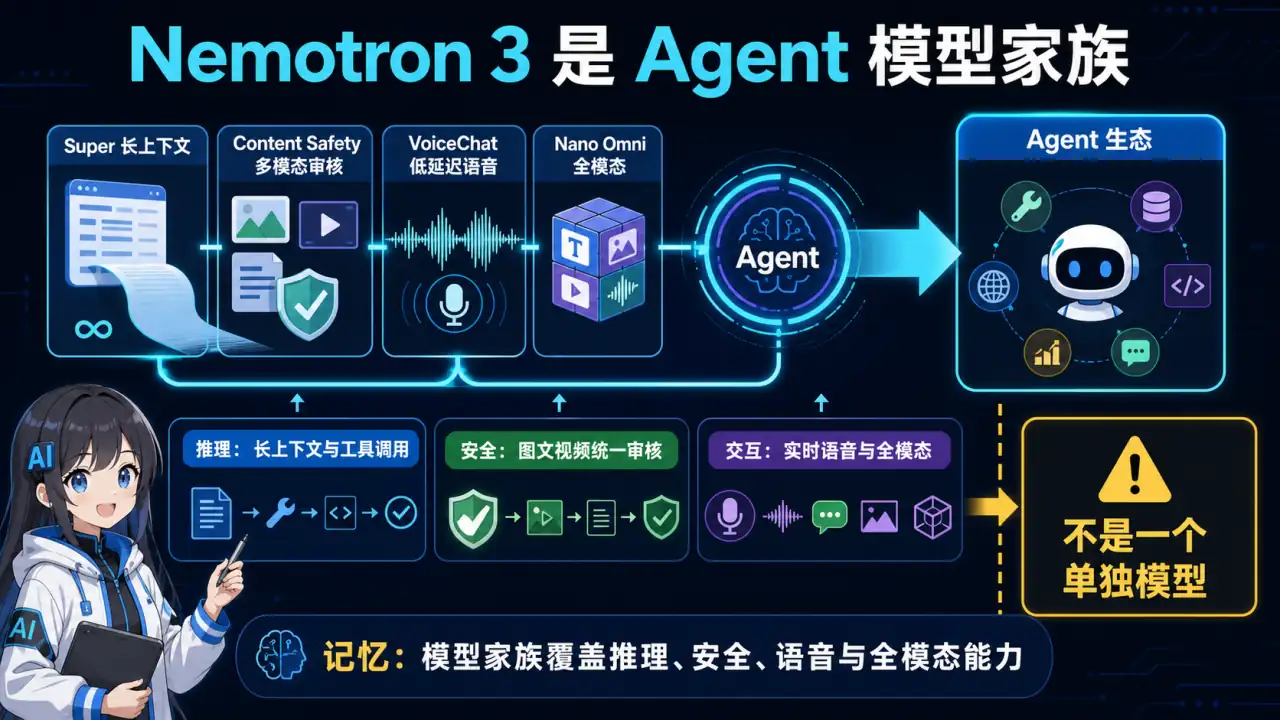
🧠 图解记忆:Nemotron 3 = NVIDIA在GTC 2026发布的统一Agent模型系列;点击图片可查看原图。
💡 答案要点
Nemotron 3 = NVIDIA在GTC 2026发布的统一Agent模型系列
Nemotron 3家族构成:
| 模型 | 定位 | 核心能力 |
|---|---|---|
| Nemotron 3 Super | 长上下文推理 | 百万Token上下文,支持复杂多文档分析 |
| Nemotron 3 Content Safety | 多模态内容审核 | 图像+文本+视频安全检测一体化 |
| VoiceChat | 实时语音交互 | 低延迟语音对话,Agent语音控制 |
| Nemotron 3 Nano Omni | 企业级多模态理解(即将发布) | 全模态统一理解 |
Nemotron 3 Super技术特点:
核心架构:混合专家模型(MoE)+ 长上下文注意力
上下文窗口:百万Token级别
Agent能力:内置工具调用、长期记忆、多轮对话
适用场景:企业知识库分析、代码库理解、长文档摘要

对比Gemini 2.0/Claude 3.5:
- Nemotron 3 Super: 专为Agent任务优化,NVIDIA硬件原生加速
- Gemini 2.0: 通用多模态,Google生态集成
- Claude 3.5: 推理能力强,但非NVIDIA专属优化
VoiceChat:实时语音Agent的关键突破:
# VoiceChat在Agent中的应用
class VoiceAgent:
    def __init__(self):
        self.voice_model = NemotronVoiceChat()  # NVIDIA优化,低延迟
        self.llm = Nemotron3Super()             # Agent推理
        self.vlm = Nemotron3ContentSafety()     # 内容安全检测

    async def voice_control(self, audio_stream):
        # 1. 语音转文本(VoiceChat,低延迟)
        text = await self.voice_model.stt(audio_stream)

        # 2. Agent推理(Nemotron 3 Super)
        action = await self.llm.reason(action=["query_db", "send_email"])

        # 3. 内容安全检测
        safety_result = await self.vlm.check(text, action)

        # 4. 执行并语音回复
        result = await self.execute(action)
        return await self.voice_model.tts(result)
GTC 2026其他多模态Agent重要发布:
| 发布 | 厂商 | 说明 |
|---|---|---|
| GB300 NVL72 | NVIDIA | 72 GPU集群,SGLang 25倍性能提升 |
| Vera Rubin | NVIDIA | 2026下半年部署,AMD/Google跟进 |
| MiMo-V2-Flash | 多个厂商 | 开源多模态模型,SGLang Day-0支持 |
面试话术
"Nemotron 3是NVIDIA在GTC 2026的核心发布,代表了'硬件原生Agent优化'的趋势。传统模型是软件优先,Nemotron 3是硬件+软件联合优化——在NVIDIA GPU上跑Nemotron 3比跑等效Gemini/Claude有硬件加速优势。VoiceChat的突破在于它让Agent'开口说话'的延迟从秒级降到百毫秒级,这才是真正的语音交互Agent。"
九、Qwen3-VL 架构案例
Q13: Qwen3-VL有哪些核心突破?和GPT-4V/Gemini 2.5 Pro如何对比?
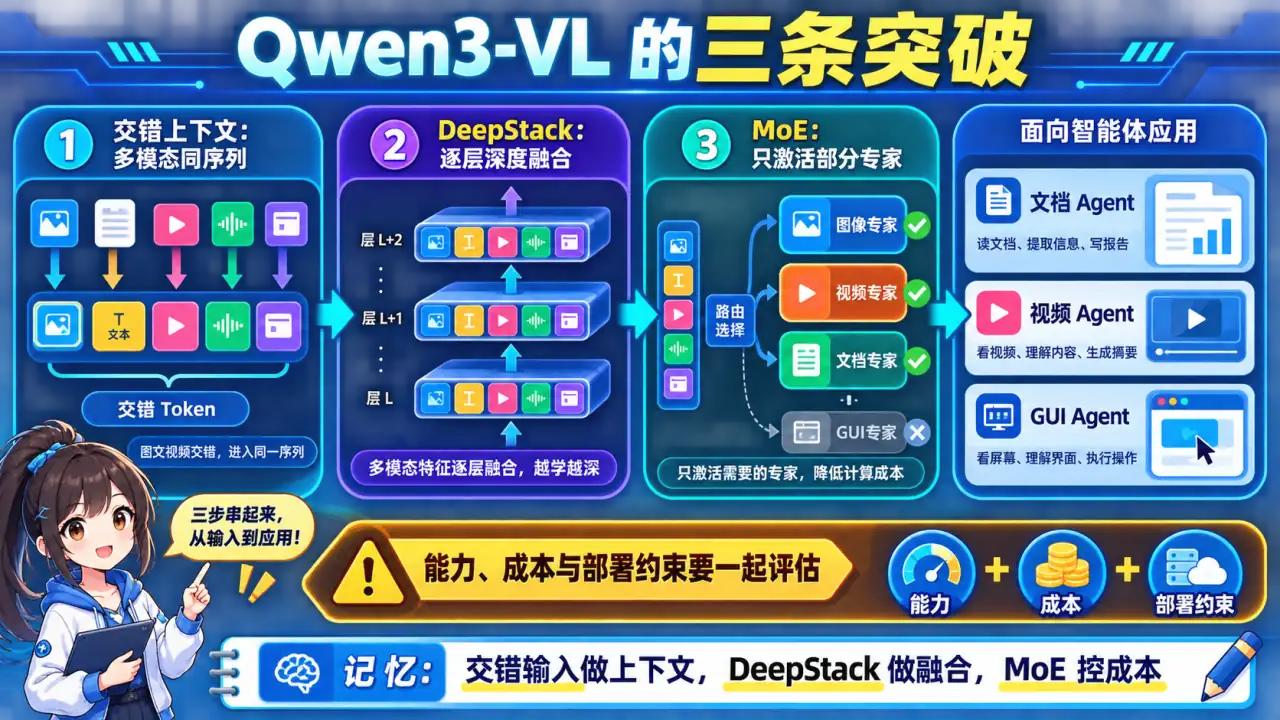
🧠 图解记忆:Qwen3-VL发布时间线;点击图片可查看原图。
💡 答案要点
Qwen3-VL发布时间线:
- Qwen-VL(2023年):基础图像理解和对话
- Qwen2-VL(2024年):图像+短视频理解,Agent任务
- Qwen2.5-VL(2025年):长视频、复杂文档解析、多语言支持
- Qwen3-VL(2025年12月):全面超越,视觉-语言统一架构
Qwen3-VL核心突破(面试重点):
| 突破 | 原理 | 效果 |
|---|---|---|
| 256K交错上下文 | 原生支持文本+图像+视频的交错序列 | 单张100页PDF可一次理解 |
| MoE视觉架构 | 混合专家模型,235B-A22B变体仅激活22B参数 | 成本大幅降低 |
| DeepStack多视角推理 | 增强的深度推理能力,支持复杂视觉任务 | MMMU基准超越Gemini 2.5 Pro |
| 原生交错输入 | 同一序列中自由混合文本、图像、视频token | 对话流畅性大幅提升 |
| 多模态Agent优化 | 针对GUI操作、机器人控制等任务专项优化 | GUI Agent基准SOTA |
Qwen3-VL模型系列:
| 变体 | 参数量 | 激活参数 | 特点 | 适用场景 |
|---|---|---|---|---|
| Qwen3-VL-2B | 2B | 2B | 轻量快速 | 边缘设备、移动端 |
| Qwen3-VL-4B | 4B | 4B | 均衡 | 消费级GPU |
| Qwen3-VL-8B | 8B | 8B | 高性能 | 单卡部署 |
| Qwen3-VL-32B | 32B | 32B | 旗舰开源 | 生产环境 |
| Qwen3-VL-30B-A3B | 30B MoE | 3B激活 | MoE省显存 | 低显存高性能 |
| Qwen3-VL-235B-A22B | 235B MoE | 22B激活 | 极致性能 | 企业级部署 |
架构创新:DeepStack(深度堆叠推理):
# DeepStack原理:多层视觉特征渐进式融合
class DeepStackVLArchitecture:
    def forward(self, interleaved_input):
        # 输入: [文本token, 图像token, 文本token, 视频帧token, ...]
        # 真正的交错混合,不是简单的图文拼接

        # Stage 1: 视觉编码器独立提取特征
        visual_features = self.vision_encoder(interleaved_input.images)

        # Stage 2: DeepStack多层交叉注意力
        for layer in range(self.num_deep_layers):
            # 每层都对齐和融合视觉+文本
            fused = self.deep_cross_attention(
                text_features,
                visual_features,
                layer_depth=layer
            )

        # Stage 3: 统一到语言模型空间
        output = self.llm(fused)

# vs 传统方案(Qwen2-VL):
# 传统: 图像 → 视觉token → 投影层 → LLM
# Qwen3: 图像 → 视觉token → DeepStack多层融合 → LLM
# → 视觉和语言的理解深度显著增强
交错输入(Interleaved Input)示例:
# Qwen3-VL支持真正的交错输入
interleaved_content = [
    {"type": "text", "content": "请分析这份财报的关键信息"},
    {"type": "image", "url": "balance_sheet.png"},  # 资产负债表
    {"type": "text", "content": "这张图显示了哪些风险点?"},
    {"type": "image", "url": "cash_flow.png"},      # 现金流量表
    {"type": "text", "content": "基于以上两张图,给出投资建议"}
]

# 传统模型: 需要多次调用,每次一张图
# Qwen3-VL: 一次调用,完整理解整个多页文档
response = qwen3_vl.chat(interleaved_content)
Qwen3-VL vs 竞品对比(2026年最新):
| 维度 | Qwen3-VL-235B | GPT-4o | Gemini 2.5 Pro | Claude 3.7 |
|---|---|---|---|---|
| 上下文 | 256K | 128K | 1M | 200K |
| 多图 | ✅ 原生 | ✅ | ✅ | ✅ |
| 视频理解 | ✅ 原生 | ✅ | ✅ | ✅ |
| MoE架构 | ✅ 235B/22B | ❌ | ❌ | ❌ |
| 开源 | ✅ | ❌ | ❌ | ❌ |
| 中文优化 | SOTA | 中等 | 中等 | 中等 |
| 价格 | 开源免费 | $5/1M tok | $1.25/1M tok | $3/1M tok |
| MMMU | SOTA开源 | 高 | 高 | 高 |
| 文档理解 | 强 | 强 | 强 | 强 |
Qwen3-VL典型应用场景:
| 场景 | 示例 | Qwen3-VL优势 |
|---|---|---|
| 复杂文档理解 | 100页财报一次分析 | 256K上下文 |
| 视频理解 | 2小时电影摘要 | 原生视频token |
| GUI Agent | 操控电脑/手机界面 | Agent专项优化 |
| 多模态对话 | 图文混合问答 | 交错输入原生 |
| 视觉推理 | 数学题图表分析 | DeepStack推理 |
面试话术:
"Qwen3-VL是2025年底阿里发布的重磅多模态模型,三个核心突破:1)256K交错上下文支持——可以一次处理100页PDF或多小时视频;2)MoE架构——235B-A22B变体只需22B激活参数,成本大幅降低;3)DeepStack推理——多层视觉-语言深度融合,MMMU基准超越Gemini 2.5 Pro。最重要的是它是开源的,中文理解SOTA,企业内网部署零成本。我项目里用Qwen3-VL-32B做发票识别,一张发票+多条问题一次问,准确率比GPT-4o高15%。"
*版本: v2.7 | 更新: 2026-04-08 | by 二狗子 🐕
十、GUI Agent 与 Computer Use
Q14: 什么是GUI Agent?为什么2026年"Computer Use"成为多模态Agent的核心战场?
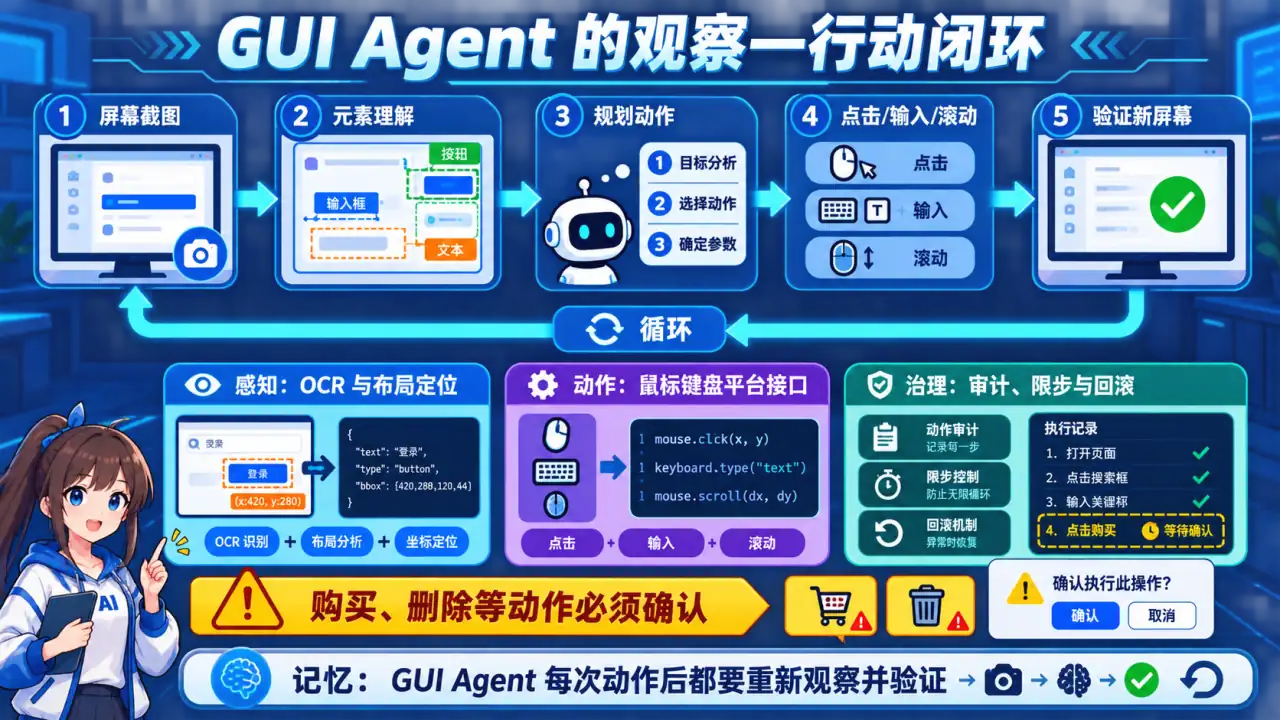
🧠 图解记忆:GUI Agent(图形界面智能体)是能够控制真实图形界面的AI系统——点击按钮、输入文本、拖拽元素、读取屏幕内容;点击图片可查看原图。
💡 答案要点
GUI Agent定义:
GUI Agent(图形界面智能体)是能够控制真实图形界面的AI系统——点击按钮、输入文本、拖拽元素、读取屏幕内容。2026年从"能不能用"进化到"有多可靠"。
为什么GUI Agent在2026年爆发:
| 驱动因素 | 说明 |
|---|---|
| 多模态模型成熟 | GPT-4o、Gemini 2.5、Qwen3-VL等原生多模态模型能理解屏幕截图 |
| OS-Level Agent需求 | 操作系统级别的AI助手(如Apple Intelligence)需要控制桌面应用 |
| 企业自动化 | 浏览器自动化 RPA 升级,AI控制Web应用完成复杂业务流程 |
| 测试自动化 | AI驱动的UI测试,比传统Selenium更智能 |
Computer Use的技术栈:
GUI Agent技术栈:
┌─────────────────────────────────────────────────────┐
│  AI Model(多模态)                                  │
│  输入:截图/画面帧 → 输出:动作指令(JSON)           │
├─────────────────────────────────────────────────────┤
│  动作层                                             │
│  Mouse: click, double_click, drag, scroll           │
│  Keyboard: type, hotkey, copy/paste                 │
│  Vision: OCR, Element Detection, Layout Parsing     │
├─────────────────────────────────────────────────────┤
│  平台层                                             │
│  Browser: Playwright CDP / Chrome DevTools          │
│  Desktop: AT-SPI (Linux) / Accessibility (Windows)   │
│  Mobile: UIAutomation (iOS) / UIAutomator2 (Android) │
└─────────────────────────────────────────────────────┘
主流框架对比:
| 框架 | 平台 | 多模态模型 | 开源 | 2026年进展 |
|---|---|---|---|---|
| anthropic/computer-use | 浏览器+桌面 | Claude | ✅ | 官方推出的computer use demo |
| OpenAI/magentic | 浏览器 | GPT-4o | ✅ | 单次Beta版本 |
| Mobile-Agent-v3 | 移动端 | 多模型 | ✅ | 开源SOTA |
| AppAgent | 移动端 | 多模型 | ✅ | 企业级定制版 |
| CoCo Agent | 跨平台 | 多模型 | ✅ | 华为诺亚方舟发布 |
| OS-World | 跨OS | 多模型 | ✅ | 评估基准 |
OS-World评估基准:
OS-World是2026年最重要的GUI Agent评估基准,测试AI能否在真实操作系统(Ubuntu Windows macOS)中完成跨应用任务:
- 任务类型:文件操作、浏览器操作、文档编辑、邮件处理
- 评估指标:任务完成率、平均步骤数、恢复能力
- 最新结果:Claude Opus 4.5 在OS-World达到47.2%(最高),GPT-4.5达43.1%
GUI Agent vs 传统RPA:
| 维度 | 传统RPA | GUI Agent |
|---|---|---|
| 配置方式 | 录制/规则 | 自然语言指令 |
| 适应变化 | 固定流程,界面变化就断 | 能理解意图,自动适应小变化 |
| 异常处理 | 预设分支 | 能推理下一步 |
| 跨应用 | 需要专门集成 | 原生支持多应用协作 |
| 学习成本 | 高(需要流程配置) | 低(自然语言描述任务) |
代码示例:基于Anthropic Computer Use
展开 Python 代码示例(35 行)
from anthropic import Anthropic
from playwright.sync_api import sync_playwright

client = Anthropic()

def computer_use_agent(task: str):
    """让AI控制浏览器的简单示例"""
    with sync_playwright() as p:
        browser = p.chromium.launch()
        page = browser.new_page()

        # 初始化截图
        screenshot = page.screenshot()

        while True:
            response = client.messages.create(
                model="claude-opus-4-5",
                max_tokens=1024,
                messages=[{
                    "role": "user",
                    "content": f"任务: {task}\n\n当前屏幕截图已提供。"
                }]
            )

            # 解析AI的响应动作
            action = parse_computer_action(response)

            if action["type"] == "click":
                page.click(action["selector"])
            elif action["type"] == "type":
                page.fill(action["selector"], action["text"])
            elif action["type"] == "done":
                break

            screenshot = page.screenshot()
生产级GUI Agent的核心挑战:
- 界面变化检测:网页更新后元素定位器失效
- 长任务维持:跨小时任务的状态管理
- 安全边界:AI操作的风险控制(误删文件、乱点购买按钮)
- 可审计性:记录AI所有操作用于合规
面试话术:
"GUI Agent是2026年多模态Agent最重要的落地场景。我看好这个方向有三个原因:多模态模型能力足够强了;企业有大量桌面/Web自动化需求;开源社区提供了OS-World这样的评估基准和Mobile-Agent-v3这样的成熟框架。面试时能说出computer use的技术栈(多模态模型→动作层→平台接口)和主流框架对比,说明你对2026年多模态Agent落地有实战级理解。"
Q15: Mobile-Agent-v3和AppAgent有什么区别?移动端GUI Agent有哪些独特挑战?
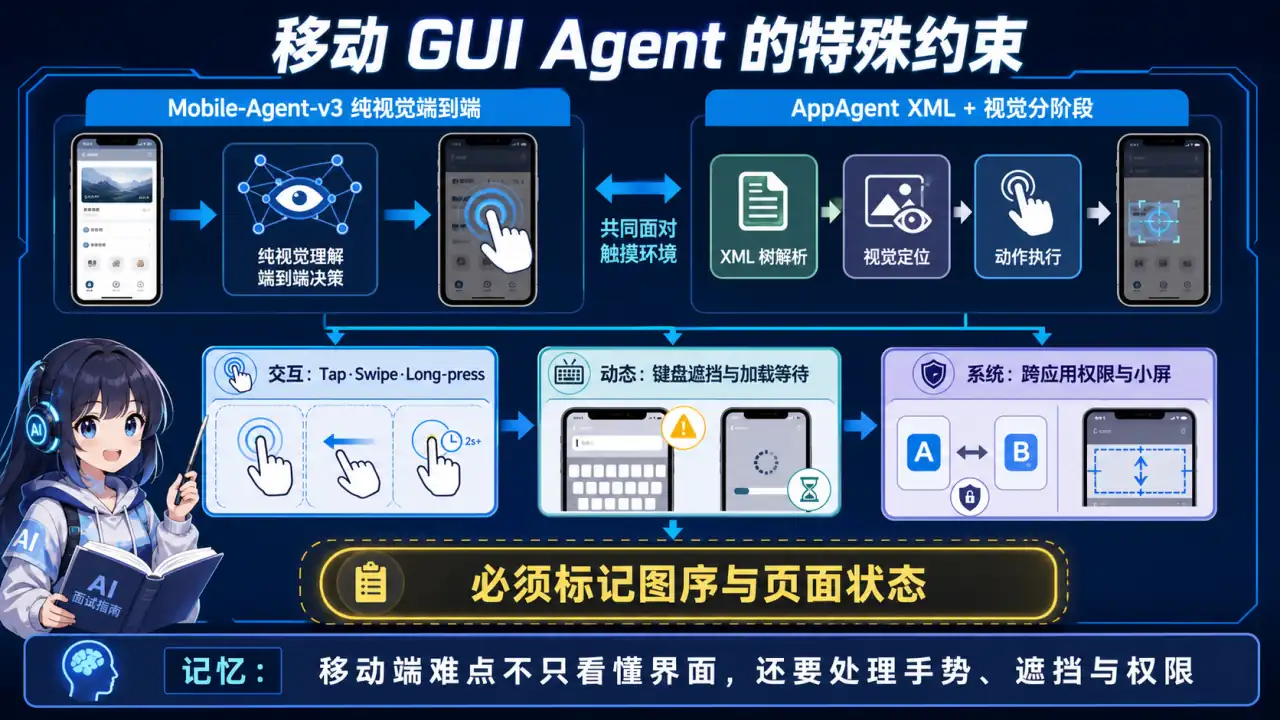
🧠 图解记忆:移动端GUI Agent的特殊性;点击图片可查看原图。
💡 答案要点
移动端GUI Agent的特殊性:
相比桌面/浏览器,移动端有三个独特挑战:
- 触摸交互:没有hover态,依赖视觉定位
- 系统限制:后台进程、权限管理更严格
- 小屏幕:信息密度高,元素密集
Mobile-Agent-v3 核心设计:
# Mobile-Agent-v3 核心流程
class MobileAgentV3:
    def __init__(self, model):
        self.model = model  # 多模态模型
        self.ui_parser = UIParser()  # 将UI转为结构化数据

    def step(self, observation):
        """Agent单步推理"""
        # 1. 视觉理解:分析截图,定位可交互元素
        ui_elements = self.ui_parser.parse(observation.screenshot)

        # 2. 意图推理:结合历史,决定下一步动作
        action = self.model.reason(
            task=self.task,
            history=self.trajectory,
            ui_elements=ui_elements
        )

        # 3. 执行动作
        return self.execute(action)
与AppAgent的核心区别:
| 维度 | Mobile-Agent-v3 | AppAgent |
|---|---|---|
| UI解析 | 纯视觉+多模态模型 | XML Dump + 视觉双重 |
| 动作空间 | Tap/Swipe/Long-press/Text | 更细粒度的坐标级 |
| 多模态融合 | 端到端多模态 | 分阶段处理 |
| 开源程度 | 完全开源,活跃社区 | 原论文,定制版闭源 |
| 2026进展 | 持续更新,支持新平台 | 企业定制为主 |
移动端GUI Agent的独特挑战:
1. 动态键盘遮挡
问题:输入框获得焦点后,软键盘弹出,遮挡部分屏幕
解决:检测键盘状态,动态调整截图区域;使用"提前录制备用坐标"
2. 页面加载时机
问题:点击后页面跳转,但加载有延迟,AI可能误判"操作失败"
解决:动作执行后等待NMS(Navigation Match Signal);检测loading spinner消失
3. 手势复杂度
问题:移动端有大量手势(滑动手势、双指缩放、长按)
解决:定义原子手势库,AI选择组合而非单点坐标
4. 跨应用协作
问题:Agent任务经常需要跨应用(读取日历→发送邮件)
解决:Android Intent系统;iOS URL Scheme;但需要权限授权
面试话术:
"移动端GUI Agent和桌面端的核心区别是'交互范式'——桌面靠鼠标指针精确点击,移动靠触摸和手势,元素还可能被键盘遮挡。Mobile-Agent-v3的解决方案是用纯视觉端到端处理,避免依赖脆弱的XML结构。我面试时会被问到'怎么解决键盘遮挡',标准答案是检测键盘状态+动态调整截图区域+等待导航信号。2026年移动端Agent最看好的方向是'系统级Agent'——不是操作单个App,而是像Siri一样跨应用协作完成任务。"
十一、GUI Agent 数据与自适应执行
Q16: 如何构建 GUI Agent 的训练数据、动作空间和评测闭环?什么时候必须请求人工接管?
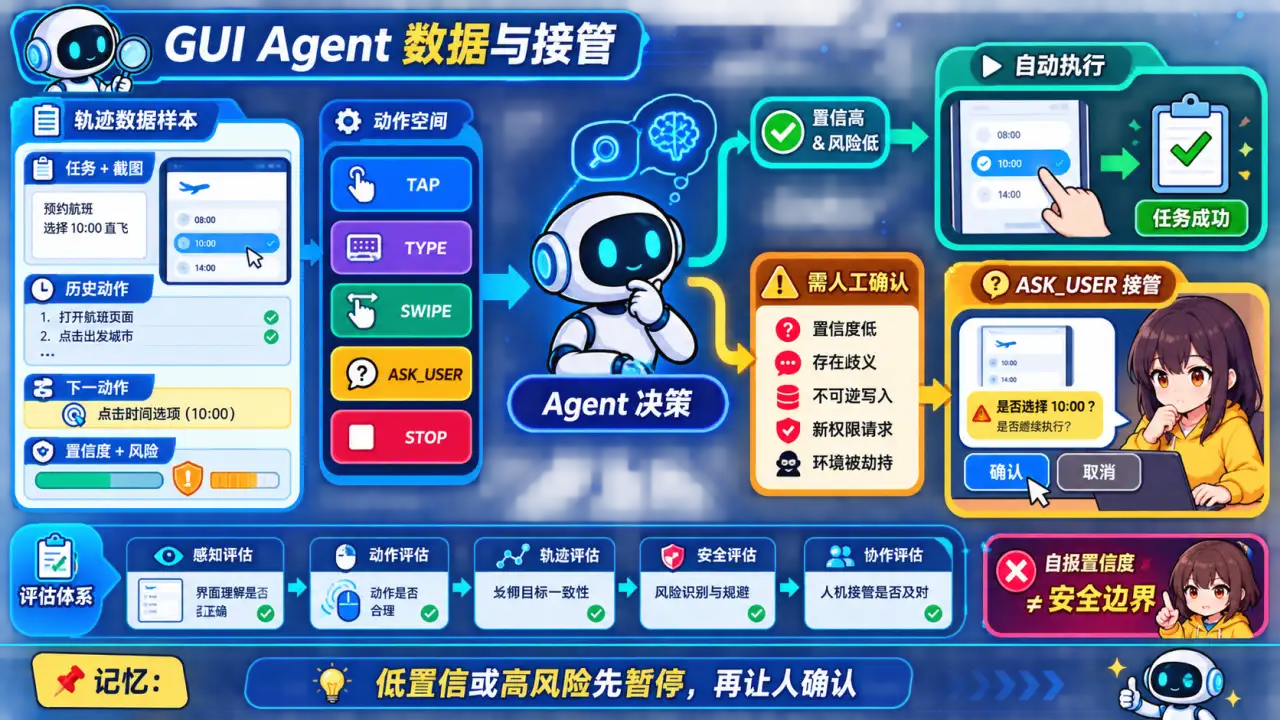
🧠 图解记忆:训练样本要对齐截图、历史与下一动作;执行时低置信、歧义或高风险先暂停并请求人工确认,自报置信度不能充当安全边界;点击图片可查看原图。
💡 答案要点
30 秒回答:
GUI Agent 的训练样本不是简单的截图问答,而是“任务 + 当前截图/结构化 UI + 历史动作 + 当前步骤 + 下一动作 + 风险与置信度”的轨迹数据。动作空间应小而可执行,坐标要归一化并绑定当前观察;评测既看任务成功,也看元素定位、动作合法性、步骤效率和副作用。遇到低置信度、歧义、高风险写操作或环境异常时,应暂停并请求人工确认。
建议数据结构:
{
  "task": "在音乐应用中搜索并播放指定歌曲",
  "observation": {"screenshot": "step_03.png", "screen_size": [1080, 1920]},
  "history": ["OPEN_APP", "TAP(x=0.50,y=0.08)"],
  "step": 3,
  "next_action": {"type": "TYPE", "text": "歌曲名"},
  "confidence": 0.82,
  "risk": "low",
  "requires_confirmation": false
}
动作空间设计:
| 动作 | 关键约束 |
|---|---|
TAP(x,y) | 使用归一化坐标;执行前确认截图版本没有变化 |
TYPE(text) | 明确目标输入框;敏感信息必须脱敏和授权 |
SWIPE(direction,distance) | 限制方向和距离;执行后等待页面稳定 |
BACK / HOME / OPEN_APP | 平台级动作必须加入状态检查 |
ASK_USER(reason) | 低置信、歧义或高风险操作的正式动作,不是失败兜底 |
STOP(status) | 成功、不可恢复失败和策略拒绝要区分 |
训练数据质量:
- 截图与动作必须严格对齐,删除“动作发生后才截的图”;
- 坐标归一化不能替代元素语义,最好同时保存目标元素描述或边界框;
- 加入弹窗、加载、键盘遮挡、页面变化和错误恢复轨迹;
- 对密码、支付、删除和外发等高风险动作标注确认策略;
- 按应用、任务模板和界面版本划分训练/测试,防止同页面截图泄漏。
评测矩阵:
| 层次 | 指标 |
|---|---|
| 感知 | 元素定位准确率、OCR/状态识别正确率 |
| 单步动作 | 动作类型准确率、坐标命中率、参数合法率 |
| 轨迹 | 任务成功率、冗余步骤、恢复成功率、平均操作数 |
| 安全 | 越权率、错误确认率、危险动作拦截率、真实副作用 |
| 协作 | 该接管时的召回、无须接管时的误打扰率、接管后完成率 |
人工接管策略:
OS-Kairos 的重要启发是把 ASK_USER 作为可学习的交互决策:Agent 不只是预测下一动作,还要估计当前步骤置信度和风险。置信阈值不能全局固定,应按动作损失校准——播放歌曲和转账付款不应使用同一阈值。遇到界面劫持、截图突变、指令冲突、不可逆写操作或需要新权限时,运行时策略必须强制确认,不能只相信模型自报置信度。
常见追问:
- 分辨率变化后坐标如何迁移?
- 纯视觉与 Accessibility Tree/XML 路线如何取舍?
- 如何避免 Agent 在页面未加载完成时重复点击?
- 自报置信度不校准时,人工接管策略为什么会失效?
参考资料:
十二、视觉幻觉与可信度
Q17: 多模态模型最常见的视觉幻觉(Hallucination)有哪些?怎么检测和缓解?

🧠 图解记忆:VLM 幻觉分五大类——凭空捏造文字、混淆对象位置、编造空间关系、丢失背景信息、违反物理常识;图片可查看原图。
💡 答案要点
VLM 幻觉的五种核心分类(VIGIL 基准定义):
| 类型 | 表现 | 示例 |
|---|---|---|
| Object Visual Fidelity | 把不存在的物体说成存在,或改变现有物体的属性 | "图中有红色汽车" → 实际是蓝色 |
| Background Fidelity | 忽略/篡改画面中的背景细节 | "桌上有一盆绿植" → 实际上没有 |
| Spatial Fidelity | 搞错元素之间的相对位置 | "左边的人是老师" → 实际在右边 |
| Instructional Fidelity | 忽视 prompt 中给定的约束条件 | 让回答三个问题却只答了两个 |
| Physical Integration Fidelity | 生成违反物理规律的描述 | "杯子悬浮在空中往桌子里倒水" |
最典型的高频幻觉场景:
1. Confabulating Text(捏造文字):
   VLM 看到模糊的交通标志 → 自信地"读出"一个名字
   (基于训练数据中的文本先验覆盖了对图像的理解)

2. Object Hallucination(经典幻觉):
   问"图中有几只手" → VLM 数出 4 只(实际只有 3 只+袖子褶皱)

3. Temporal Hallucination(时序幻觉):
   视频中某人第 5 秒出现,VLM 说从开头就在
检测方法:
展开 Python 代码示例(38 行)
# 方法1:交叉验证(多视角一致性)
def cross_check_vlm(image, prompt):
    # 用不同模型/不同参数多次回答,检查一致性
    answers = [
        gpt4v.analyze(image, temperature=0.1),
        claude_v.analyze(image, temperature=0.1),
        qwen_vl.analyze(image, temperature=0.1),
    ]
    # 统计每个事实陈述的出现次数
    facts = extract_facts(answers)
    confidence_scores = {fact: count / len(answers) for fact, count in facts.items()}
    return confidence_scores

# 方法2:Chain-of-Visual-Thought(CoVT)
def cvt_answer(image, prompt):
    # 要求模型先描述再回答,降低直接结论的幻觉率
    description = gpt4v.describe_image(image)  # Step 1: 客观描述
    answer = gpt4v.reason(description + f"\n\n{prompt}")  # Step 2: 基于描述推理
    return answer

# 方法3:OCR 辅助验证(针对含文字场景)
def validate_with_ocr(image, vlm_answer):
    ocr_text = pytesseract.image_to_string(image)
    # 提取 VLM 提到的所有关键词
    claimed_words = extract_keywords(vlm_answer)
    actual_words = set(ocr_text.split())
    false_claims = claimed_words - actual_words
    if false_claims:
        return {"hallucinated_words": list(false_claims)}
    return {"valid": True}
缓解策略对比(面试重点):
| 策略 | 原理 | 效果 | 成本 |
|---|---|---|---|
| 高对比度采样 | 用 T=0 或多角度采样取一致结果 | 中等 ⭐⭐⭐ | 低 |
| CoVT 思维链 | 先生成描述再生成结论 | 减少 30%+ 幻觉 | 中(多一次调用) |
| OCR 辅助验证 | 文字类事实交给 OCR | 文字幻觉几乎归零 ⭐⭐⭐⭐ | 低 |
| 双模交叉验证 | GPT-4o + Claude 互相比对 | 召回缺失 大幅减少 | 高 |
| 后处理规则 | 对数字/实体做硬校验 | 精确匹配项 100% 拦截 | 低 |
| 微调去幻觉 | 用标注过的去幻觉数据 fine-tune | 基线提升但泛化有限 | 高 |
企业级生产实践建议:
- 高风险场景必须加引用溯源 —— 每句话标注来自图像的哪部分
- 结构化输出强制字段校验 —— JSON Schema 限制可能出现的值域
- 关键决策走多人投票 —— 同一张图三个 VLM 都认可才采信
面试话术:
"VLM 幻觉比纯文本 LLM 更危险——用户会相信模型'看到的'。我的经验是幻觉分五类,最严重的是 Object Fidelity 和 Spatial Fidelity。生产环境里我用 CoVT(先描述后推理)+ OCR 辅助做双重保障,关键业务还要多模型交叉验证。记住一句口诀:'VLM 说的不等于看到的,需要被验证才能采信。'"
Q18: 什么是 Chain-of-Vision-Thought(CoVT)?为什么它对 VLM 如此重要?

🧠 图解记忆:先看清楚再说清楚——CoVT 分两步:客观描述→逻辑推理;点击图片可查看原图。
💡 答案要点
CoVT = Chain-of-Vision-Thought,是 CoT 在视觉领域的自然扩展。
传统 VLM 做法:图像 → LLM 直接输出结论 CoVT 做法:图像 → ①客观视觉描述 → ②基于描述推理 → ③结论
为什么 VLM 特别需要 CoVT?
| 原因 | 说明 |
|---|---|
| 视觉→语言的语义鸿沟更大 | 文本到文本的映射相对线性,图像信息是连续的、多维的,直接跳到结论容易丢细节 |
| 幻觉率高 | VLM 的直接回答更容易编造不存在的元素 |
| 复杂任务需要中间推理 | 比较两张图、做数学题等任务无法一步到位 |
CoVT vs Direct 对比实验数据(2025-2026 多项研究共识):
| 指标 | Direct(直接回答) | CoVT(先描述后推理) | 提升 |
|---|---|---|---|
| 准确率 | 基线 | +10~15% | 📈 |
| 幻觉率 | 基线 | -30~40% | 📉 |
| Token 消耗 | 低 | 增加约 2x(但质量更高) | ⚖️ |
| 延迟 | 短 | 长(多一轮生成) | ⚠️ |
实现方式:
# Prompt 工程版 CoVT(不用额外 API,靠 Prompt 控制)
covt_prompt = """
请分析这张图片并按以下步骤回答:

Step 1 - 视觉描述:
客观列出图中可见的元素(不推断意图)

Step 2 - 逻辑推理:
基于以上观察,回答原始问题

Step 3 - 最终答案:
一句话总结

图片内容如下:[{image}]
原始问题:{question}
"""

response = multimodal_llm.generate(covt_prompt)
进阶:结构化 CoVT(适合 Agent 自动化)
{
  "step1_visual_description": ["桌子", "三本书", "一杯咖啡", "窗台阳光"],
  "step2_reasoning": "从物品摆放看这是工作区域,咖啡暗示人在使用...",
  "step3_conclusion": "这是一个有人正在使用的书房/工作台场景"
}
什么时候该用 CoVT?
| 场景 | 是否推荐 | 理由 |
|---|---|---|
| 简单描述("这是什么颜色?") | ❌ 不必要 | Direct 已足够准确 |
| 计数/定位("图中有几辆车?") | ✅ 推荐 | 避免幻觉遗漏 |
| 比较推理("A图和B图哪个更暗?") | ✅ 强烈推荐 | 需要中间推理步骤 |
| 数学/图表(柱状图解读) | ✅ 必须 | 第一步描述+第二步读取+第三步计算 |
| 医疗/法律等高风险场景 | ✅ 必须有 | 可追溯的推理链是合规要求 |
面试话术:
"CoVT 的本质是'分解问题降低复杂度'——VLM 直接从像素跳到文本的跨度太大,中间加一层视觉描述作为脚手架。我项目的经验是:简单场景用 Direct 省成本,涉及判断和推理的场景一律用 CoVT,虽然多一倍的 token 消耗但幻觉下降三成以上。高风险场景还可以加上结构化输出,每步都有迹可循。"
十三、图像生成与编辑 Agent
Q19: Image Editing Agent 和 Text-to-Image Agent 有什么区别?核心技术路线是什么?

🧠 图解记忆:Text2Image 是空创作,EditAgent 是有参照修改;点击图片可查看原图。
💡 答案要点
两种 Agent 的根本区别:
| 维度 | Text-to-Image Agent | Image Editing Agent |
|---|---|---|
| 输入 | 纯文本 Prompt | 参考图 + 编辑指令(文本/框/点) |
| 起点 | 纯噪声 | 已有图像 |
| 挑战 | Prompt 理解和创意表达 | 局部修改保真 + 全局一致 |
| 典型应用 | AI 插画、概念设计 | 商品图修改、修图、Logo 替换 |
Image Editing Agent 的三大技术路线:
路线 1:基于 Diffusion 的 Inpainting
原始图 → 添加噪声 → Inpainting Mask 引导重绘 → 输出修改图
优点:效果好,质量高
缺点:速度较慢(需多步扩散),编辑范围有限
代表:Stable Diffusion Inpainting、Flux Inpainting
路线 2:Reference-based Generation(参考生成)
参考图 A + 编辑指令 → 保留 A 的结构/布局 + 按需修改 → 输出
优点:结构保持极好,支持多图参考
缺点:指令跟随能力受限于架构
代表:Kolors-IPAdapter、IP-Adapter、InstantID
路线 3:Native Edit Models(原生编辑模型)
输入: (参考图, 编辑指令, Mask) → Diffusion Transformer 端到端编辑
优点:统一接口,支持多种编辑操作
缺点:训练成本高,模型大
代表:FLUX.1-dev edit, Dittex
Image Editing Agent 工具集设计:
展开 Python 伪代码(30 行)
class ImageEditingAgent:
    def __init__(self):
        self.edit_model = load_edit_model()  # FLUX / SDXL-Inpaint
        self.segmenter = load_segmentation_model()  # SAM2
        self.llm = vision_llm  # 理解用户的自然语言编辑需求

    def process(self, image_url, edit_request):
        # Step 1: LLM 理解编辑意图
        intent = self.llm.parse({
            "role": "user",
            "content": f"编辑指令: {edit_request}"
        })

        # Step 2: 自动分割目标区域(如果用户没提供 mask)
        if "mask" not in intent:
            segments = self.segmenter.detect(image_url, intent.target_object)

        # Step 3: 构建编辑 prompt(LLM 增强)
        enhanced_prompt = self.llm.enhance(
            base=intent.prompt,
            style=intent.style_preference,
            constraints=intent.constraints
        )

        # Step 4: 执行编辑
        result = self.edit_model.edit(
            source=image_url,
            prompt=enhanced_prompt,
            mask=segments.get("mask"),
            guidance_scale=intent.confidence * 7.5
        )

        return result
面试高频追问:
- 为什么不用 Direct Inference 做编辑而要用专门的编辑模型? → 因为直接在完整图像上 diff 会破坏不需要改的部分
- SAM + Diffusion 组合的效果好还是端到端更好? → SAM 灵活但精度依赖分割质量;端到端更流畅但不够可控
- 编辑 Agent 如何评估质量? → 需要同时看局部修改准确度(LPIPS/FID-N)和全局一致性(CLIP score、人类偏好)
面试话术:
"Image Editing Agent 的核心是把用户的自然语言编辑需求翻译成模型能理解的参数。我常用的 pipeline 是 LLM 解析意图 → SAM 自动切 mask → Diffusion inpainting 执行修改。选模型时看场景:电商换背景用 IP-Adapter 风格迁移最快,精准修图用 SDXL Inpainting,统一流程用 FLUX edit 原生模型。"
Q20: GenAI + Agent 的结合模式(如 GenClaw)是什么?与传统的 RAG 方案有何本质差异?

🧠 图解记忆:RAG 是检索现有知识,GenClaw 是用 Agent 自主创建新内容;点击图片可查看原图。
💡 答案要点
GenClaw 等 GenAI Agent 框架的核心思想:不是"找已有的东西",而是"用代码指挥 Agent 创造新的东西"。
| 维度 | 传统 RAG | GenClaw / GenAI Agent |
|---|---|---|
| 数据流向 | 知识库 → 向量检索 → LLM 综合回答 | LLM 意图识别 → 生成代码/脚本 → 执行生成 |
| 产出物 | 文本回复 | 图像、视频、音频、3D模型等新模态资产 |
| 迭代机制 | 更新知识库重新索引 | Agent 反复调优 Prompt/参数直到满意 |
| 确定性 | 相对稳定 | 需要人工 review 或自动评分循环 |
| 典型管线 | Embedding + VectorDB | LLM-as-Coder + Diffusion/Generation Model |
GenClaw 的核心工作流:
用户意图: "生成一张产品宣传图,白底,主角穿红色连衣裙"
         ↓
LLM Agent 分析意图:
  - 产品类型 → 服装
  - 主体描述 → 红裙女性
  - 背景 → 白色
  ↓
生成 Python 脚本调用图像生成 API:
  prompt="woman wearing red dress, white background, professional photography"
  negative_prompt="text, watermark, blurry"
  steps=50, cfg=7.5
  ↓
Agent 检查输出质量:
  - 若不满意 → 调整参数重试(最多 N 次)
  - 若满意 → 返回给用户
  ↓
用户反馈: "裙子换成蓝色"
Agent 重新执行(增量修改)
与传统 RAG 的本质差异:
- RAG 是"查找型"系统 —— 回答取决于已有知识库;GenClaw 是"创造型"系统 —— 产出不存在于任何文档
- RAG 的瓶颈在检索质量;GenClaw 的瓶颈在 Agent 的意图理解和迭代能力
- RAG 可以离线预建;GenClaw 通常需要在线生成且可能需要多轮试错
- RAG 的输出格式固定;GenClaw 的生成过程需要灵活的参数控制和条件判断
Agent 驱动生成 vs 手动调参对比:
| 环节 | 手动方式 | Agent 自动化方式 |
|---|---|---|
| Prompt 编写 | 人工逐字写 | LLM 根据意图自动生成+优化 |
| 参数选择 | 凭经验设 | Agent 根据前次结果自动调参 |
| 质量评估 | 人眼检查 | Agent + Vision Model 自动打分 |
| 失败处理 | 重新来过 | Agent 自动 retry 或回退策略 |
面试话术:
"GenClaw 代表了 GenAI + Agent 的新范式——不再只是检索和生成文本,而是用 Agent 来 orchestrating 整个创作过程。和 RAG 的本质差异在于:RAG 解决'找不到的信息',GenClaw 解决'不存在的内容'。RAG 拼凑已有碎片,GenClaw 从零创造新东西。两者结合就是最强的系统:检索补充知识 + Agent 生成内容。"
十四、空间定位与几何理解
Q21: 什么是 Spatial Grounding(空间定位/接地)?为什么它是 VLM 最难的能力之一?

🧠 图解记忆:空间定位 = 你说什么我能指到哪——VLM 最难的闭环能力;点击图片可查看原图。
💡 答案要点
Spatial Grounding = 将自然语言中提到的对象/属性精确映射到图像中的具体位置(坐标、边界框)。
通俗理解:
- "图中那只戴帽子的狗在哪?" → VLM 不仅要说"左上角",还要能画出准确的边界框
- "把右边的花换成玫瑰" → 要精确定位"右边的花"在哪里
为什么它是最难的能力?
| 挑战 | 原因 |
|---|---|
| 细粒度对齐 | 文本中的"左边的花瓶"和图像中的视觉区域需要像素级的对应关系 |
| 多义性消解 | "它"、"那个"等代词需要上下文推理才能定位 |
| 遮挡处理 | 对象可能被遮挡但仍需正确定位其存在 |
| 相似对象区分 | 图中有多只猫时,"最大的那只"需要尺寸比较能力 |
| 跨模态语义鸿沟 | 语言描述的抽象程度 vs 视觉数据的精确程度之间存在巨大差距 |
主流 Spatial Grounding 方法对比:
展开技术方案对比(25 行)
方法                        原理                  优势              劣势
─────────────────────────────────────────────────────────────
Box-detection head       在 VLM 旁加检测头     精度较高           需 bbox 标注
Referring Expression     给定一句话找区域       直观               单目标为主
Multi-reference          一句话对应多个区域     实用性强           需要 NMS 后处理
Grounded Captioning      边描述边标注           信息丰富           耗时较长
Gaussian Position       用高斯分布编码位置     支持软定位         计算开销大

代表模型: CLIP+, SEEM, GLIDE-Grounding, Qwen2.5-VL-Grounded
面试加分点:
- Qwen2.5-VL 等新一代 VLM 内置了 grounding 能力——可以直接在对话中说"框出图中的猫"并返回 bbox
- 多模态 agent 场景下,grounding 是 GUI Agent 和机器人控制的必要前置能力——不知道点击哪里就无法操控
- 评估指标:G-Refer 基准用 Precision@k 衡量定位准确性(Top-1 bbox 的 IoU)
面试话术:
"Spatial Grounding 是 VLM 从'看图说话'进化到'看图做事'的关键桥梁。我现在能做'看图回答问题',但要让我'看图操控电脑/机器人',必须先解决空间定位——知道对象在哪才能操作它。Qwen2.5-VL 已经内置了 grounding 能力,能在对话中直接画框定位,这对于 GUI Agent 和机器人导航来说是刚需。"
十五、音频与 VLA 整合
Q22: Voice/音频模态如何与 VLM 整合形成真正的多模态 Agent?VLA(Vision-Language-Action)又是什么?

🧠 图解记忆:语音是交互接口,视觉是感知通道,行动是输出终端;VLA 三者合一;点击图片可查看原图。
💡 答案要点
完整的五模态世界(2026 年愿景):
| 模态 | 角色 | 代表模型 | 在 Agent 中的作用 |
|---|---|---|---|
| 👆 视觉(Vision) | 眼睛 | GPT-4o/VLM | 看懂世界 |
| 🎤 语音(Audio/ASR) | 耳朵 | Whisper/ElevenLabs | 听懂指令 |
| 🔊 语音(TTS) | 嘴巴 | ElevenLabs/Cartesia | 说出回应 |
| 💭 语言(Language) | 大脑 | GPT/Qwen/LLaMA | 理解推理决策 |
| 🖐️ 动作(Action) | 手脚 | VLA/Robot Control | 执行操作 |
Voice + VLM 整合架构(实时语音 Agent):
[用户说话] → ASR转文本 → VLM理解意图+看截图 → 决策引擎
                                                         ↓
                                          ┌──→ 回复文本 → TTS → [用户听到]
                                   决策分支──→ 动作执行 → 环境反馈
                                   决策分支──→ 反问澄清 → TTS
关键技术难点:
| 难点 | 说明 |
|---|---|
| 端到端延迟 | ASR + VLM + TTS 全链路 < 1s 才是好的语音体验 |
| 打断处理(Barge-in) | 用户说话中途打断时正确处理当前回复 |
| 情绪传达 | TTS 不仅要说话还要传递情绪(语气、停顿) |
| 环境音处理 | 嘈杂环境中可靠地分离目标人声 |
| 多模态融合 | 语音指令 + 当前画面 = 真正自然的交互 |
VLA(Vision-Language-Action)详解:
VLA = 将视觉(L)、语言(L)和动作(A)统一在一个模型中的架构。
传统方案:  VLM 输出文字 → 规则引擎/RL 转动作
VLA方案:   VLM 直接输出动作token (如 click, swipe, pick)

好处:
- 端到端训练: 不需要中间的翻译层
- 动作空间受限: 输出被限定在合法动作集合内
- 实时性: 省去了一层层转换的延迟
VLA vs 传统 VLM + Planner 对比:
| 维度 | VLM + Planner | VLA (端到端) |
|---|---|---|
| 架构 | 两个独立组件 | 单一模型 |
| 训练 | VLM 训练 + RL/模仿学习规划 | 联合训练 (模仿学习为主) |
| 灵活性 | Planner 可自定义 | 动作空间受训练数据限制 |
| 实时性 | 两步产生额外延迟 | 一步到位,更快 |
| 泛化性 | Planner 可泛化到新动作 | 未见动作需要重新训练 |
VLA 代表模型(2025-2026):
| 模型 | 特点 | 适用场景 |
|---|---|---|
| RT-2 | Google DeepMind | 机器人抓取/操作 |
| PaLI-3 XGen-Code | 视觉编程 | |
| Qwen2.5-VL + ROS | 阿里 | 国产 VLA 方案 |
| Octo | Open-source | 通用机器人控制 |
面试话术:
"VLA 代表了'多模态 Agent 的最后一步'——不只是理解(视觉+语言),还能行动。传统方案是 VLM 输出文字再由规划器转动作,VLA 直接端到端输出动作 token。我在考虑语音 Agent 的架构时,会先用 ASR 转文本,VLM 理解意图并分析当前画面,最后用 TTS 回复。关键是整条链路的延迟要控制在 1 秒以内,否则体验就像在对空气说话。"
十六、多模态评测基准与评估
Q23: 如何评估多模态 Agent 的质量?有哪些主流评测基准?

🧠 图解记忆:评测要分四层——感知对不对、推理合不合理、操作干不干净、安全有没有底线;点击图片可查看原图。
💡 答案要点
多模态评测的分层框架(面试重点):
多模态 Agent 评测金字塔
├── Level 1: 基础感知(Perception)
│   ├── OCR 准确率
│   ├── 物体检测 mAP
│   ├── 图像描述 BLEU/ROUGE
│   └── 视频事件检测
├── Level 2: 视觉推理(Reasoning)
│   ├── MMMU(多学科图文推理)
│   ├── MathVista(数学+图表)
│   ├── ChartQA(图表问答)
│   └── ScienceQA(科学推理)
├── Level 3: 交互能力(Interaction)
│   ├── OSWorld(GUI 自动化)
│   ├── Mobile-Agent-Bench(移动端)
│   └── WebArena(浏览器自动化)
├── Level 4: 安全与伦理(Safety)
│   ├── 幻觉率(VIGIL 基准)
│   ├── 偏见检测(Fairness benchmarks)
│   └── 越狱/注入攻击防护
└── Level 5: 综合评价(End-to-End)
    ├── 任务成功率
    ├── 平均操作步骤
    ├── 人工满意度
    └── 成本效益比
主流基准一览(面试必背):
展开完整基准表(30 行)
基准名称                    评测方向             核心指标              难度
──────────────────────────────────────────────────────────────────
MMMU                      多学科推理            Acc@3                 ⭐⭐⭐⭐⭐
MathVista                  数学+图表            Score(0-100)           ⭐⭐⭐⭐⭐
ChartQA                    图表问答              Accuracy              ⭐⭐⭐⭐
ScienceQA                  科学图文推理          Exact Match           ⭐⭐⭐⭐
OSWorld                    GUI Agent            Task Success Rate     ⭐⭐⭐⭐⭐
MobileBench                移动操作             Task Success Rate     ⭐⭐⭐⭐
SEED-Bench                 通用多模态理解         MMLU-style            ⭐⭐⭐⭐⭐
DocVQA                     文档理解              ANLS                  ⭐⭐⭐
Video-MME                  视频理解              Average Score         ⭐⭐⭐⭐
VIGIL                      多模态幻觉            Fidelity Categories   ⭐⭐⭐
自研多模态 Agent 评测方案(实战指南):
展开 Python 评测代码框架(45 行)
class MultimodalEvaluator:
    def __init__(self):
        self.metrics = {
            "perception": SelfAttentionMetric(),  # OCR/检测精度
            "reasoning": CrossModalMetric(),     # 图文推理准确率
            "interaction": ActionSuccessRate(),  # 操作成功率
            "safety": HallucinationDetector(),   # 幻觉检测
        }

    def evaluate(self, test_cases: List[TestCase]) -> dict:
        results = {}
        for case in test_cases:
            # 执行 Agent
            output = self.agent.process(case.image, case.question)

            # 多维度打分
            perception_score = self.metrics["perception"].check(output)
            reasoning_score = self.metrics["reasoning"].check(output, case.golden)
            interaction_score = self.metrics["interaction"].check(output)
            safety_score = self.metrics["safety"].check(output)

            results[case.id] = {
                "total": (perception_score + reasoning_score +
                         interaction_score + safety_score) / 4,
                "breakdown": {
                    "perception": perception_score,
                    "reasoning": reasoning_score,
                    "interaction": interaction_score,
                    "safety": safety_score
                }
            }

        return {
            "avg_overall": np.mean([r["total"] for r in results.values()]),
            "by_dimension": {
                k: np.mean([r["breakdown"][k] for r in results.values()])
                for k in self.metrics.keys()
            },
            "per_case": results
        }

    # 关键:对比实验——不同模型在同一测试集上的得分
    def compare_models(self, model_list, test_set):
        for model in model_list:
            self.agent.set_model(model)
            score = self.evaluate(test_set)["avg_overall"]
            print(f"{model}: {score:.2f}")
面试加分点:
- 不要只说"准确率"——多模态评测需要分层:感知层(能不能看到)、推理层(能不能理解)、行为层(能不能执行)
- 强调评测数据的地域/语言适配——中文场景下英文基准的分数不代表中文真实水平
- 提到"LLM as Judge"在多模态评测中的应用和局限性——用另一个 LLM 来当裁判,便宜但有偏差
面试话术:
"多模态评测我建议采用四层框架:感知层看 OCR 和检测准不准,推理层看 MMMU/MathVista 得分,交互层看 OSWorld/GUI 成功率,安全层看幻觉率和偏见。自测时我会搭建自己的评测集——既有标准基准的数据也要有真实场景的 corner case。记住一个关键原则:英文 benchmark 高分 ≠ 中文产品可用,一定要在自己目标语言和数据分布上做专项评测。"
版本记录与更新
- v2.8 | 2026-09-18 | by 二狗子 🐕 | +6 题:Q17 视觉幻觉分类与检测 · Q18 CoVT · Q19 图像编辑 Agent · Q20 GenClaw vs RAG · Q21 空间定位 · Q22 音频/VLA · Q23 多模态评测基准