🔥 AI 应用开发高级专题面试题
面试优先顺序(通用 AI 应用开发岗位):Q3、Q4、Q6、Q7、Q9、Q10、Q18。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
难度: ⭐⭐⭐⭐⭐
更新: 2026-05-20
考点: 多模态应用、自主 Agent、AI 产品思维、架构设计、前沿技术
📋 目录
一、多模态 AI 应用
Q1: 多模态输入进入复杂 AI 工作流时,如何设计处理与降级链路?
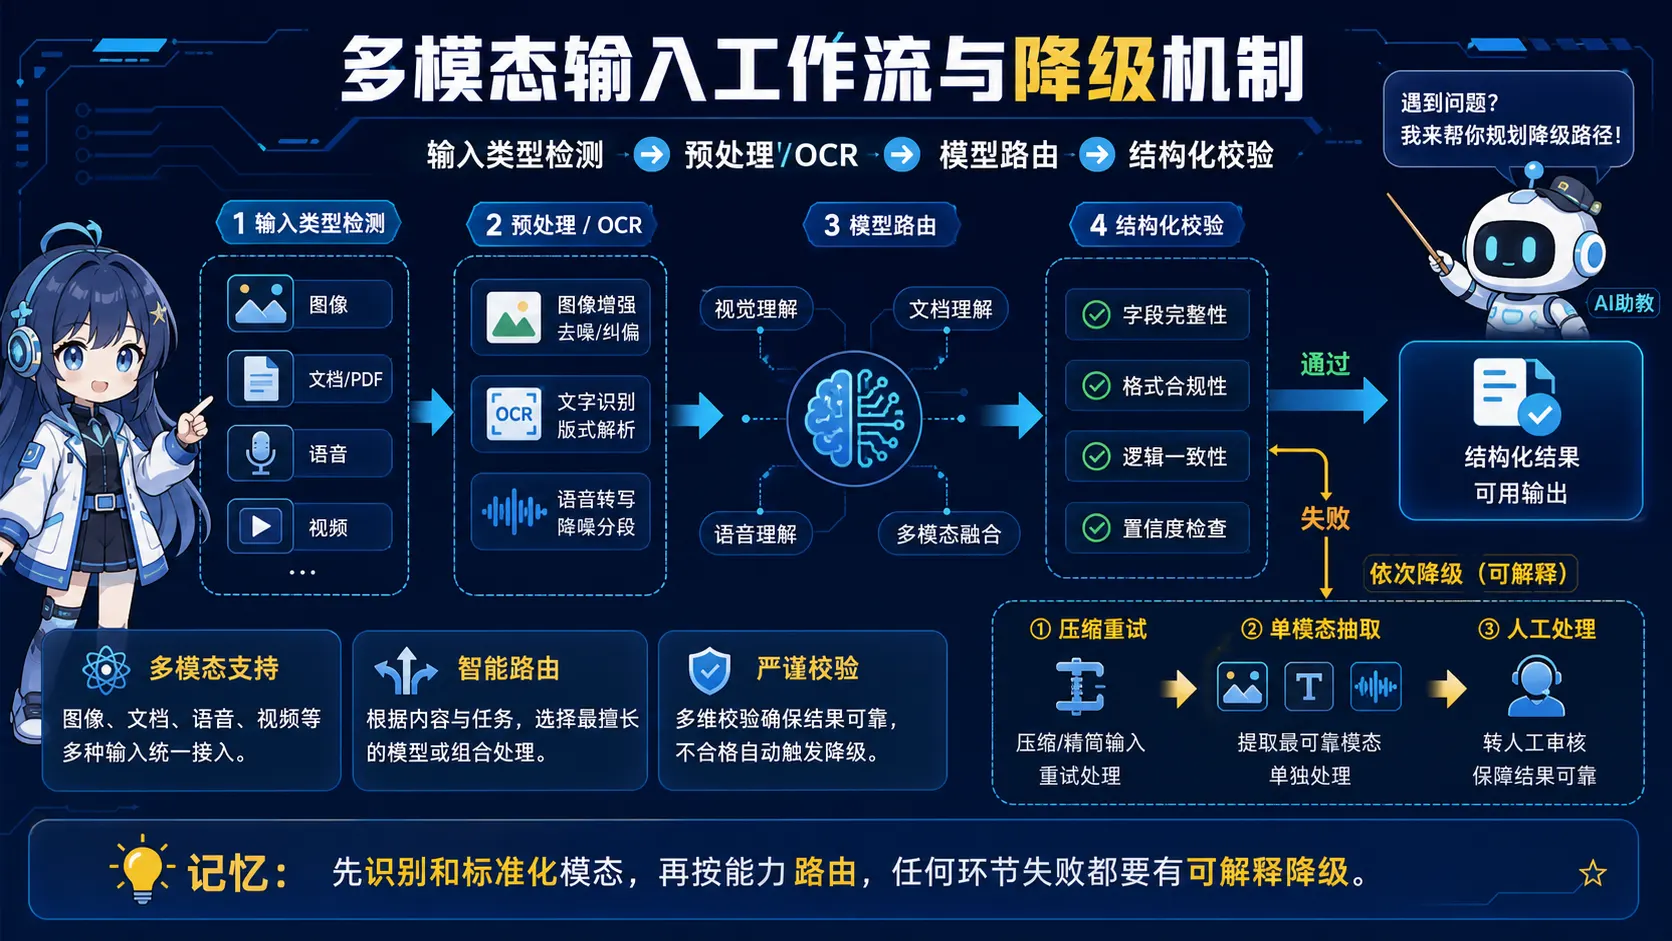
🧠 图解记忆: 先识别和标准化模态,再按能力路由;任何环节失败都要有可解释降级。
💡 答案要点
多模态模型:
- GPT-4o、GPT-4V
- Qwen-VL(阿里)
- LLaVA(开源)
- Gemini Pro Vision
应用场景:
| 场景 | 输入 | 输出 | 商业价值 |
|---|---|---|---|
| OCR 增强 | 扫描版 PDF 图片 | 结构化文本 + 表格 | 文档数字化 |
| 图表分析 | 折线图/柱状图 | 数据解读 + 趋势分析 | 商业智能 |
| 商品识别 | 商品图片 | 商品信息 + 价格对比 | 电商导购 |
| 文档理解 | 合同/发票图片 | 关键信息提取 | 财务自动化 |
| 视觉问答 | 图片 + 问题 | 图片内容理解 | 智能客服 |
实现示例:
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "请分析这张图表"},
            {"type": "image_url", "image_url": "https://example.com/chart.png"}
        ]
    }]
)
实战案例:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我在项目中用 GPT-4o 处理扫描版合同,传统 OCR 对表格识别率只有 65%,用多模态模型直接理解图片,识别率提升到 94%。虽然成本高一些,但对于高价值场景(合同、发票)是值得的。"
Q2: 多模态应用的性能和成本如何优化?
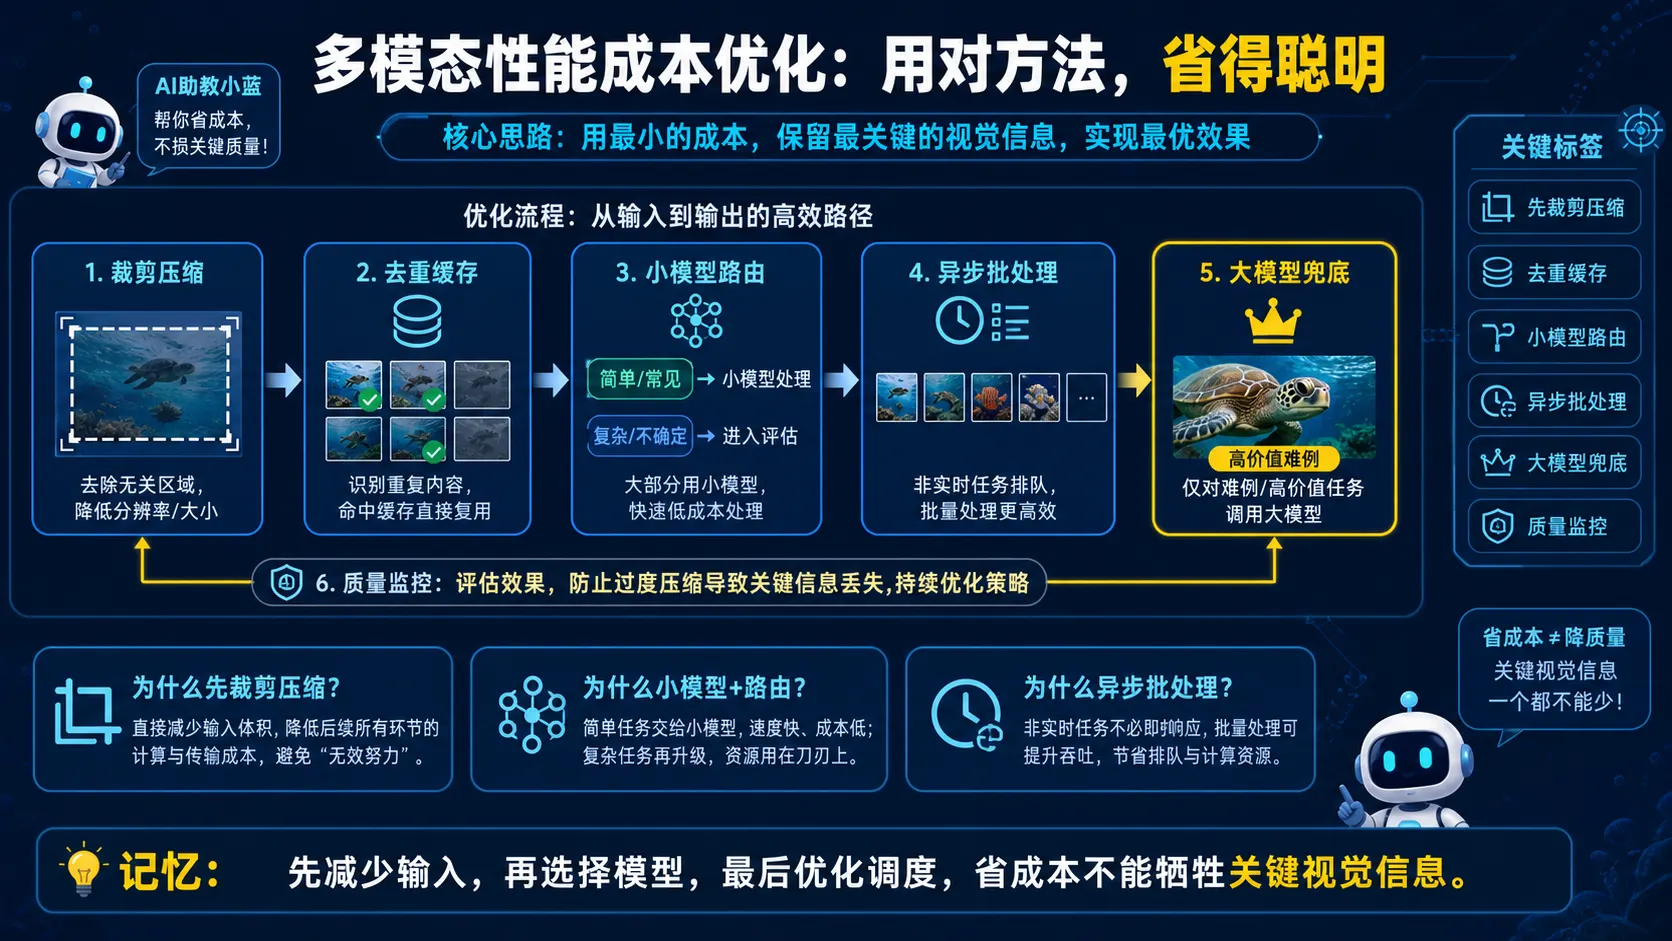
🧠 图解记忆: 先减少输入,再选择模型,最后优化调度;省成本不能牺牲关键视觉信息。
💡 答案要点
性能优化:
| 策略 | 说明 | 效果 |
|---|---|---|
| 图片压缩 | 降低分辨率,保持关键信息 | 延迟降低 50% |
| 图片裁剪 | 只保留相关区域 | Token 减少 70% |
| 缓存机制 | 相同图片不重复处理 | 成本降低 40% |
| 异步处理 | 非实时场景异步执行 | 用户体验提升 |
成本优化:
| 策略 | 说明 | 节省比例 |
|---|---|---|
| 模型路由 | 简单图片用小模型 | 30-50% |
| 预处理 | 先用 CV 模型提取信息 | 40-60% |
| 混合方案 | OCR+LLM 结合 | 50-70% |
实现示例:
# 图片预处理:先用 CV 模型检测是否有文字
def has_text(image):
    result = ocr_model.detect(image)
    return len(result) > 0

# 根据情况选择模型
if has_text(image):
    # 有文字,用 OCR+LLM
    text = ocr_model.extract(image)
    response = llm.generate(text)
else:
    # 无文字,用多模态模型
    response = gpt4v.generate(image, prompt)
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我设计了混合方案:先用轻量级 OCR 模型检测图片是否有文字,有文字就用 OCR+LLM,没有就用多模态模型。这样成本降低了 60%,响应速度提升了 2 倍。"
二、自主 Agent 与 Agentic Workflow
Q3: 什么是 Agentic Workflow?和传统 AI 应用有什么区别?
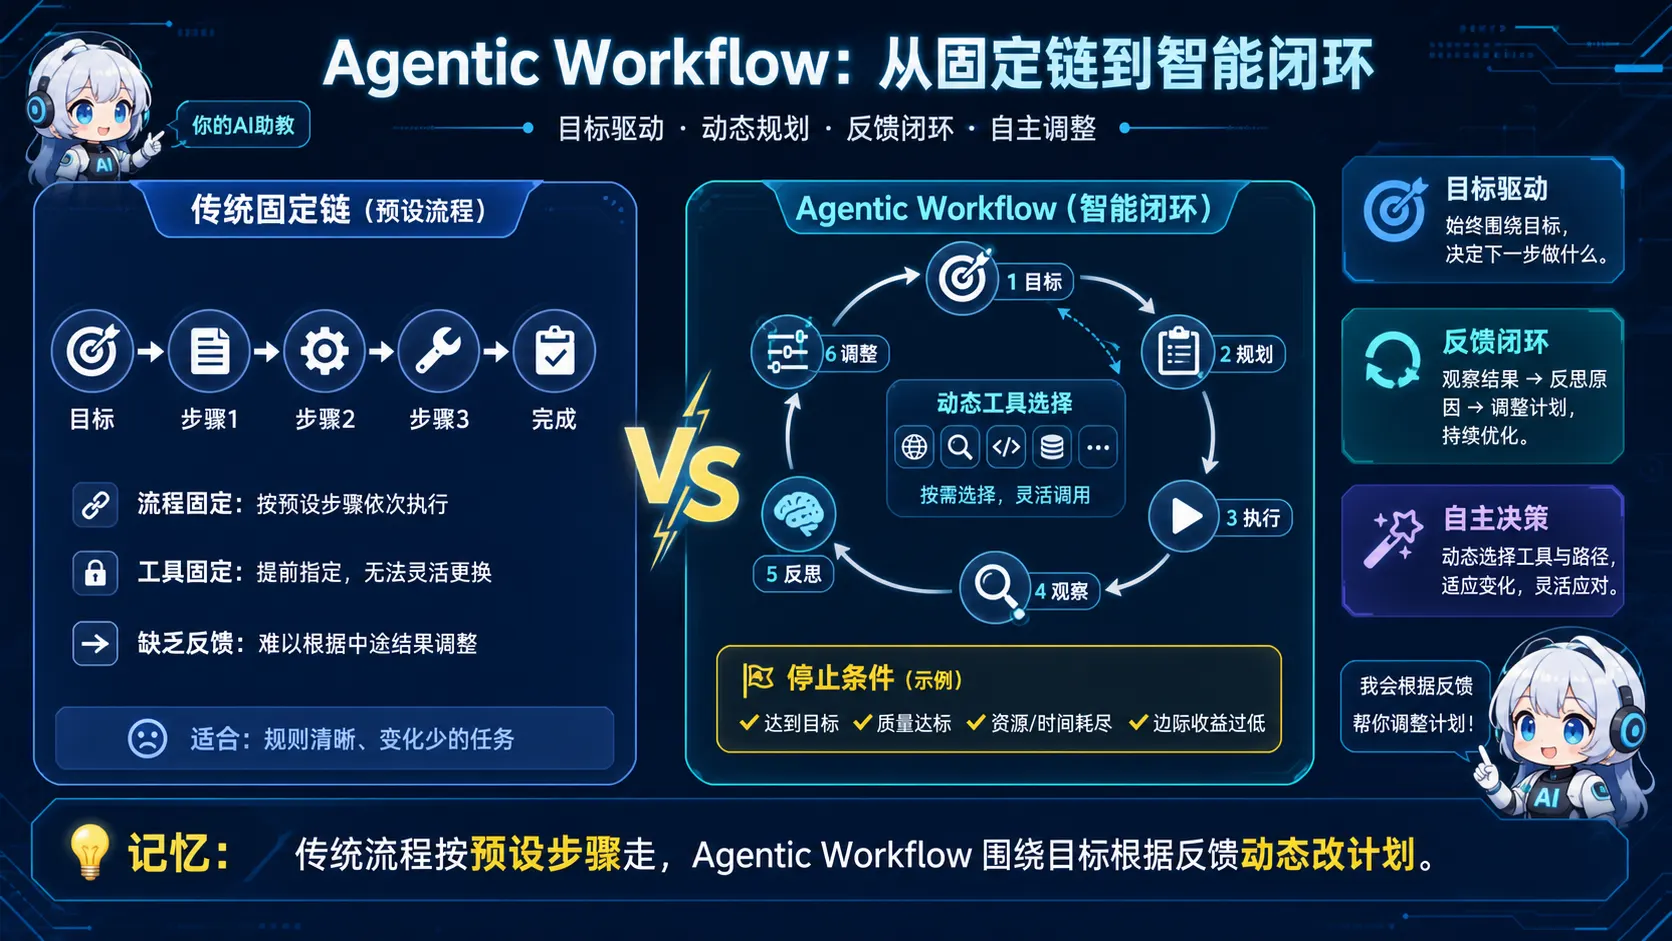
🧠 图解记忆: 传统流程按预设步骤走,Agentic Workflow 围绕目标根据反馈动态改计划。
💡 答案要点
Agentic Workflow = 自主 Agent 工作流
核心特征:
┌─────────────────────────────────────────────────────────┐
│                  Agentic Workflow                        │
└─────────────────────────────────────────────────────────┘

目标 → 规划 → 执行 → 反思 → 调整 → 完成
        ↓       ↓       ↓       ↓
      分解    行动    评估    修正
与传统 AI 应用的区别:
| 维度 | 传统 AI 应用 | Agentic Workflow |
|---|---|---|
| 控制流 | 线性(用户输入→AI 输出) | 循环(自主决策直到完成) |
| 决策权 | 用户主导 | Agent 自主决策 |
| 工具使用 | 单次调用 | 多次迭代调用 |
| 错误处理 | 直接报错 | 自我修正 |
| 适用场景 | 简单问答 | 复杂任务 |
典型案例:
- Devin:自主编程 Agent,可以独立完成开发任务
- AutoGPT:自主完成目标,如"研究某个主题并写报告"
- LangGraph Agent:支持循环和状态管理的 Agent 编排
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "传统 AI 应用是'你说我做',Agentic Workflow 是'给我目标,我自己完成'。我在项目中实现了一个数据分析 Agent,用户只说'分析上个月销售数据',Agent 自主完成数据查询、分析、可视化、报告生成的全流程。"
Q4: 如何设计一个自主编程 Agent(类似 Devin)?
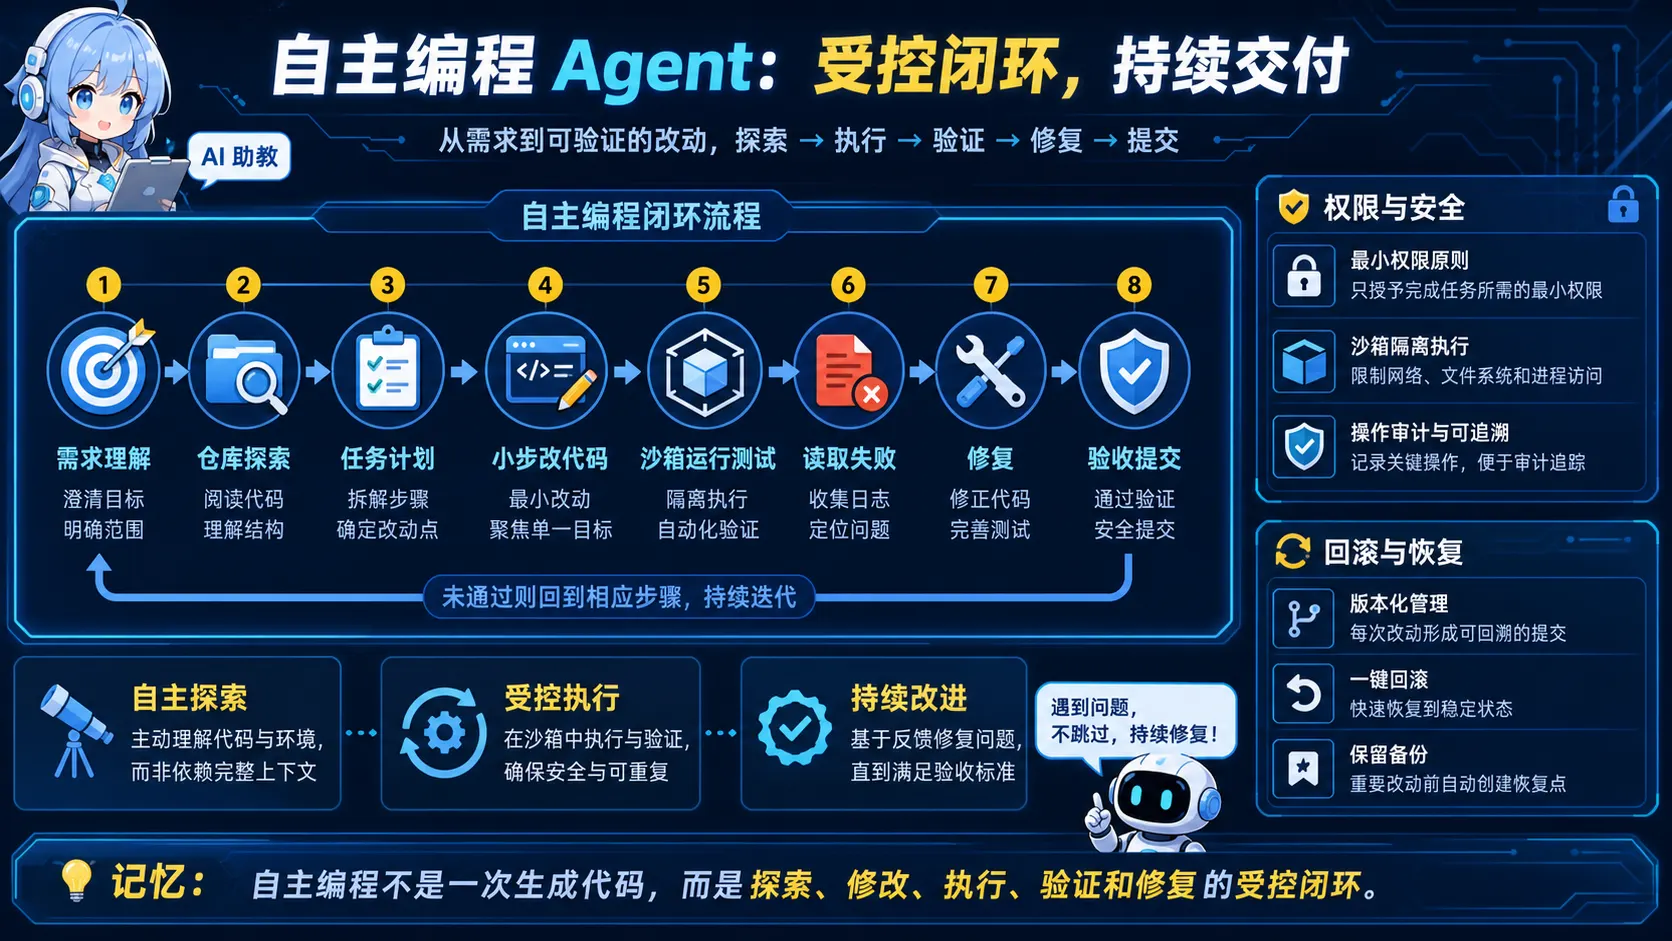
🧠 图解记忆: 自主编程不是一次生成代码,而是探索、修改、执行、验证和修复的受控闭环。
💡 答案要点
核心能力:
┌─────────────────────────────────────────────────────────┐
│                  自主编程 Agent                          │
└─────────────────────────────────────────────────────────┘

需求理解 → 任务规划 → 代码生成 → 执行测试 → 修复 Bug → 完成
              ↓           ↓           ↓           ↓
          分解步骤    编写代码    运行测试    自我修复
架构设计:
| 模块 | 职责 | 技术实现 |
|---|---|---|
| 需求理解 | 理解用户想要什么 | LLM + Few-shot |
| 任务规划 | 分解成可执行步骤 | ReAct/Plan-and-Execute |
| 代码生成 | 编写代码 | Code LLM(StarCoder、CodeLlama) |
| 执行测试 | 运行代码并测试 | 沙箱环境 + 单元测试 |
| Bug 修复 | 分析错误并修复 | 错误信息 + LLM 修复 |
| 状态管理 | 追踪进度和上下文 | 向量数据库 + 短期记忆 |
实现示例:
class CodingAgent:
    def __init__(self):
        self.planner = Planner()
        self.coder = CodeGenerator()
        self.tester = TestRunner()
        self.debugger = BugFixer()

    async def execute(self, requirement):
        # 1. 任务规划
        plan = await self.planner.decompose(requirement)

        # 2. 逐步执行
        for step in plan:
            while True:
                # 3. 代码生成
                code = await self.coder.generate(step)

                # 4. 执行测试
                result = await self.tester.run(code)

                if result.success:
                    break
                else:
                    # 5. Bug 修复
                    code = await self.debugger.fix(code, result.error)

        return code
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我设计的编程 Agent 核心是'规划 - 执行 - 修复'循环。Agent 先把需求分解成小步骤,每步生成代码后自动运行测试,失败就自我修复。关键是沙箱环境,确保 Agent 写的代码不会破坏系统。"
Q5: 多 Agent 协作系统怎么设计?
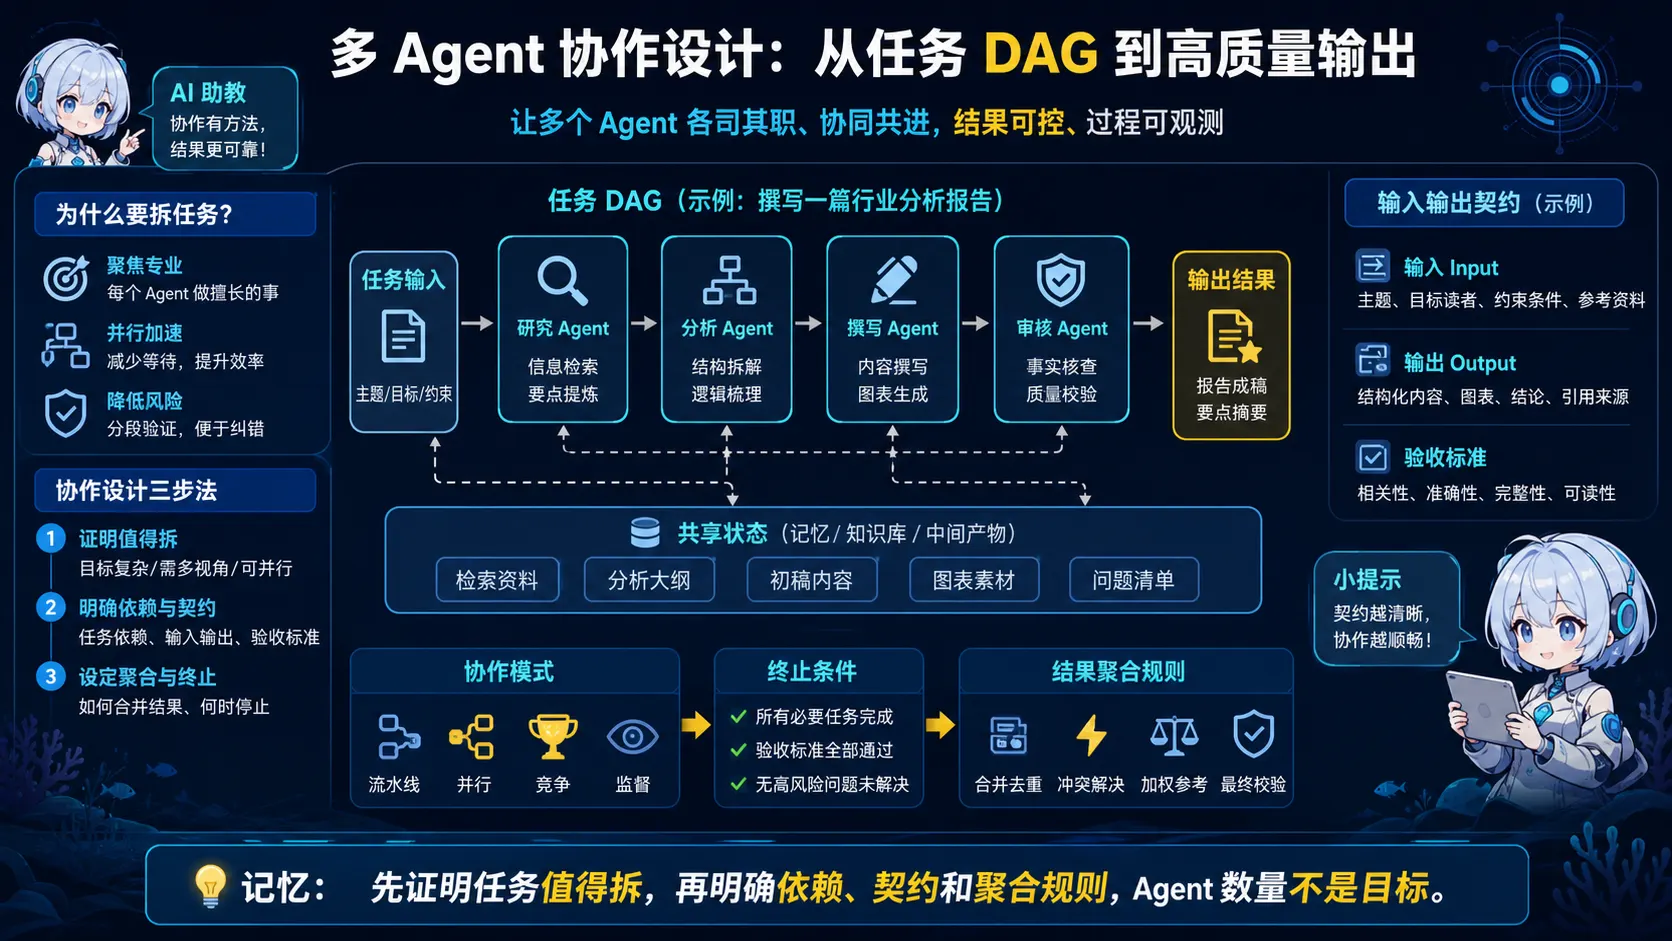
🧠 图解记忆: 先证明任务值得拆,再明确依赖、契约和聚合规则;Agent 数量不是目标。
💡 答案要点
协作模式:
| 模式 | 说明 | 适用场景 |
|---|---|---|
| 流水线 | Agent A→Agent B→Agent C | 内容创作、数据处理 |
| 协作 | 多个 Agent 并行处理 | 复杂任务分解 |
| 竞争 | 多个 Agent 给出方案,择优 | 决策支持 |
| 监督 | 一个 Agent 监督其他 Agent | 质量控制 |
典型架构:
┌─────────────────────────────────────────────────────────┐
│                  多 Agent 协作系统                        │
└─────────────────────────────────────────────────────────┘

                    ┌──────────────┐
                    │  Coordinator │ ← 协调者
                    └──────┬───────┘
                           │
        ┌──────────────────┼──────────────────┐
        ↓                  ↓                  ↓
┌──────────────┐   ┌──────────────┐   ┌──────────────┐
│  Researcher  │   │   Writer     │   │   Reviewer   │
│   研究员      │   │    写手       │   │    审核员     │
└──────────────┘   └──────────────┘   └──────────────┘
通信机制:
- 共享内存:所有 Agent 访问同一状态
- 消息队列:Agent 之间通过消息通信
- 黑板模式:Agent 在共享空间发布/获取信息
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我设计了一个内容创作多 Agent 系统:Researcher 负责搜索信息,Writer 负责写作,Reviewer 负责审核。协调者分配任务并整合结果。相比单 Agent,内容质量提升了 40%,生产效率提升了 3 倍。"
三、AI 产品思维与架构设计
Q6: 如何判断一个场景是否适合用 AI 解决?
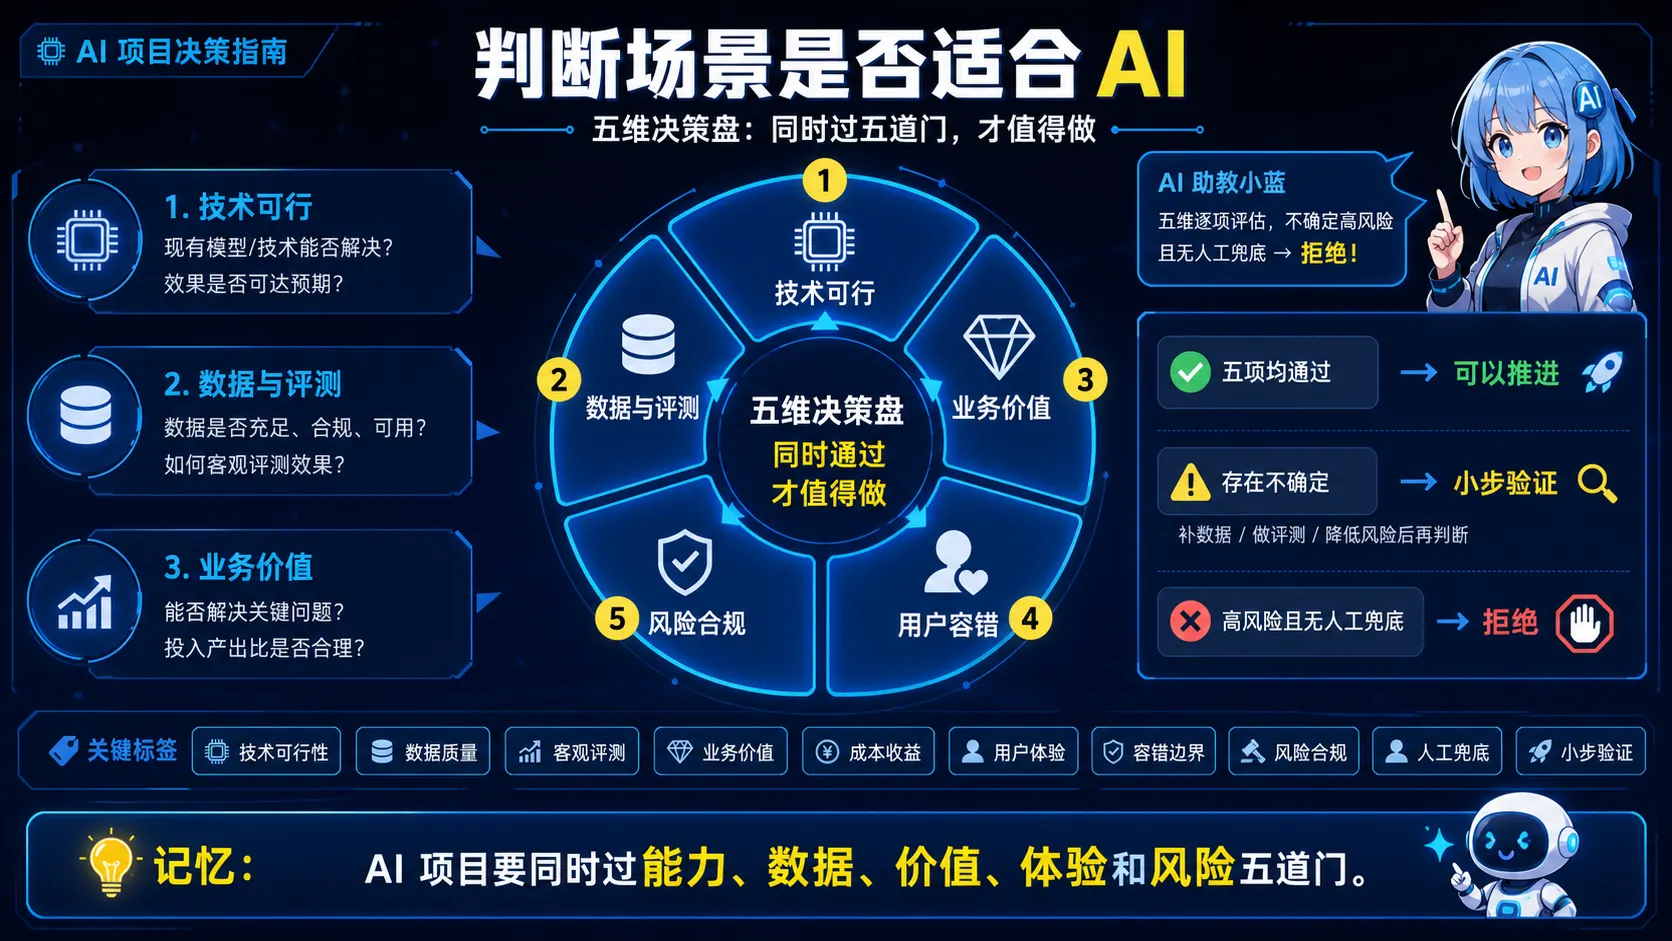
🧠 图解记忆: AI 项目要同时过能力、数据、价值、体验和风险五道门。
💡 答案要点
评估维度:
┌─────────────────────────────────────────────────────────┐
│                   AI 场景适用性评估                       │
└─────────────────────────────────────────────────────────┘

技术可行性 ←→ 商业价值 ←→ 数据准备 ←→ 用户体验 ←→ 风险评估
评估框架:
| 维度 | 关键问题 | 评分标准 |
|---|---|---|
| 技术可行性 | 现有 AI 能力能否解决? | 高/中/低 |
| 商业价值 | 能带来多少收益/节省多少成本? | ROI > 3 |
| 数据准备 | 有足够的高质量数据吗? | 充足/一般/缺乏 |
| 用户体验 | AI 比传统方案好吗? | 明显提升/持平/更差 |
| 风险评估 | 失败后果严重吗? | 可接受/需谨慎/不可接受 |
适合 AI 的场景特征:
- ✅ 有大量数据可供训练/检索
- ✅ 任务有一定模糊性,规则难以穷尽
- ✅ 允许一定容错率
- ✅ 人力成本高或效率低
- ✅ 用户能接受 AI 辅助决策
不适合 AI 的场景特征:
- ❌ 需要 100% 准确性(如医疗诊断、法律判决)
- ❌ 数据极度缺乏或质量差
- ❌ 规则清晰明确,传统编程更可靠
- ❌ 失败后果严重且不可逆
面试话术:
"我评估 AI 场景用五维框架:技术可行性、商业价值、数据准备、用户体验、风险评估。核心是 ROI,如果 AI 方案不能带来 3 倍以上收益,我宁愿用传统方案。"
Q7: 设计一个企业级 AI 应用架构,需要考虑哪些方面?
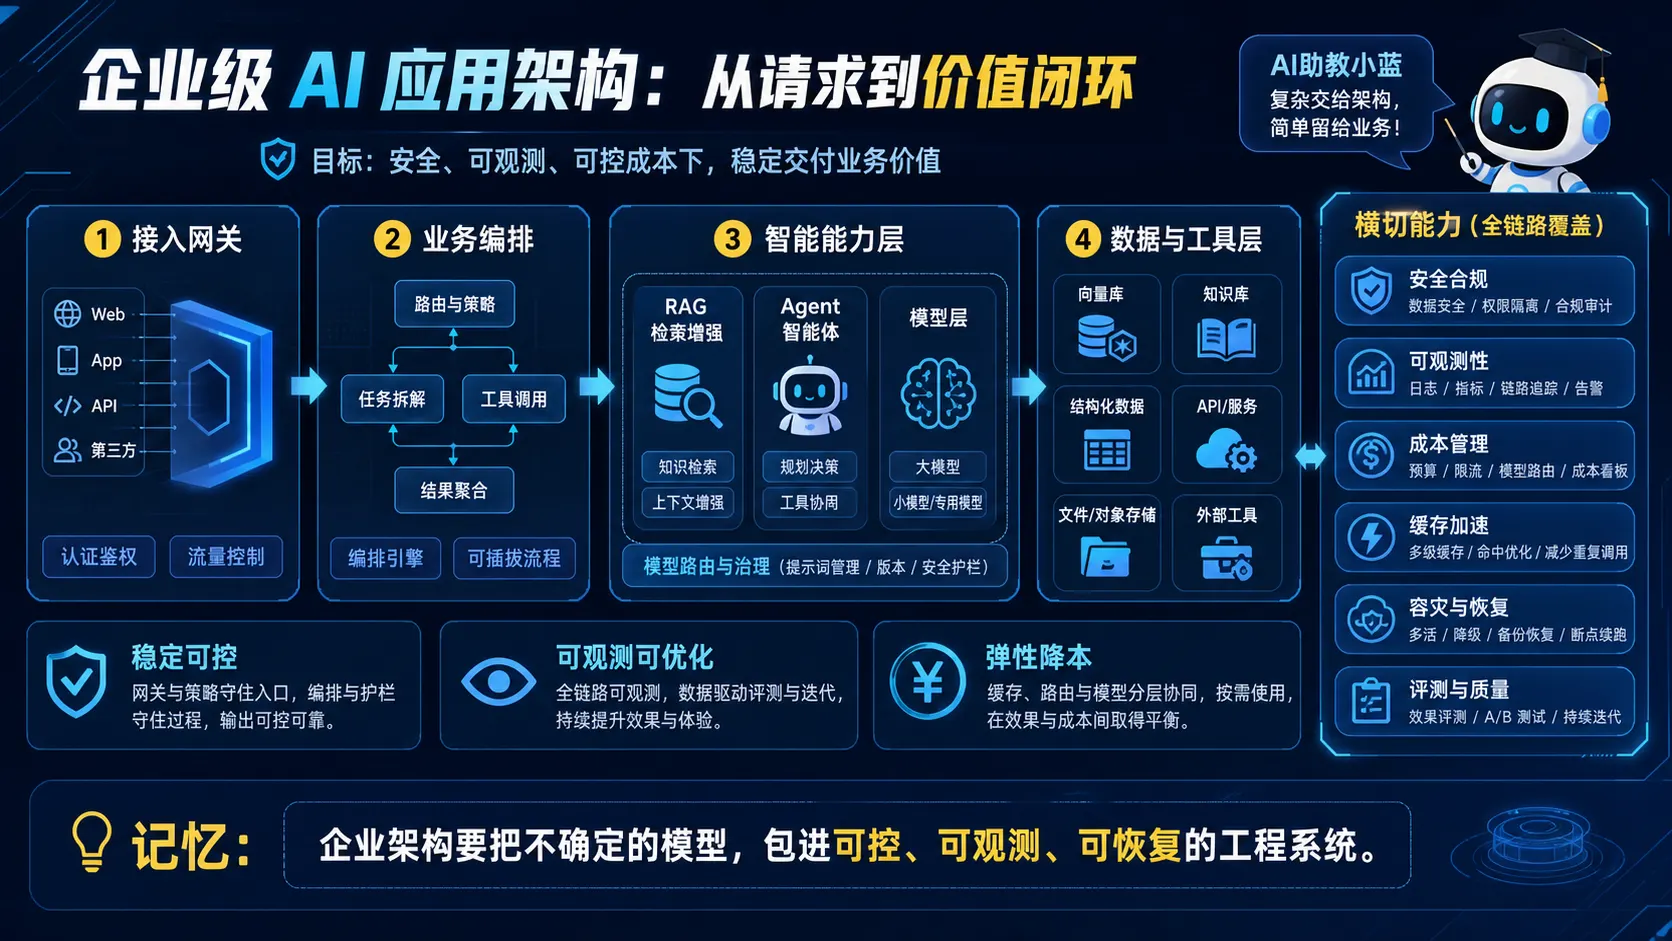
🧠 图解记忆: 企业架构要把不确定的模型包进可控、可观测、可恢复的工程系统。
💡 答案要点
架构设计:
┌─────────────────────────────────────────────────────────┐
│                    企业级 AI 应用架构                     │
└─────────────────────────────────────────────────────────┘

                         ┌──────────────┐
                         │   用户界面    │
                         │ (Web/App/IM) │
                         └──────┬───────┘
                                │
                         ┌──────▼───────┐
                         │  API Gateway │
                         │ (鉴权/限流)   │
                         └──────┬───────┘
                                │
        ┌───────────────────────┼───────────────────────┐
        ↓                       ↓                       ↓
┌──────────────┐       ┌──────────────┐       ┌──────────────┐
│  AI 服务集群   │       │  业务服务    │       │  数据服务    │
│ (LLM 调用)    │       │ (业务逻辑)    │       │ (DB/缓存)    │
└──────┬───────┘       └──────┬───────┘       └──────┬───────┘
       │                      │                       │
       ↓                      ↓                       ↓
┌──────────────┐       ┌──────────────┐       ┌──────────────┐
│  模型管理     │       │  监控告警     │       │  日志审计    │
│ (路由/缓存)   │       │ (指标/追踪)   │       │ (合规/追溯)   │
└──────────────┘       └──────────────┘       └──────────────┘
核心考虑方面:
| 方面 | 关键点 | 实现方案 |
|---|---|---|
| 高可用 | 服务不中断 | 多实例 + 自动故障转移 |
| 高性能 | 低延迟响应 | 缓存 + 异步 + 流式输出 |
| 高并发 | 支撑大量用户 | 负载均衡 + 弹性伸缩 |
| 安全性 | 数据不泄露 | 鉴权 + 加密 + 审计 |
| 可扩展 | 易于增加功能 | 微服务 + 插件化 |
| 可观测 | 问题可追踪 | 日志 + 指标 + 追踪 |
| 成本可控 | 预算不超标 | 配额 + 优化 + 告警 |
面试话术:
"企业级 AI 应用架构,我核心关注七个方面:高可用、高性能、高并发、安全性、可扩展、可观测、成本可控。特别是成本可控,AI 调用是要钱的,必须做配额管理和成本告警。"
Q8: 什么是企业级AI四层黄金架构?RAG、AI Agents、MCP、A2A如何协同?
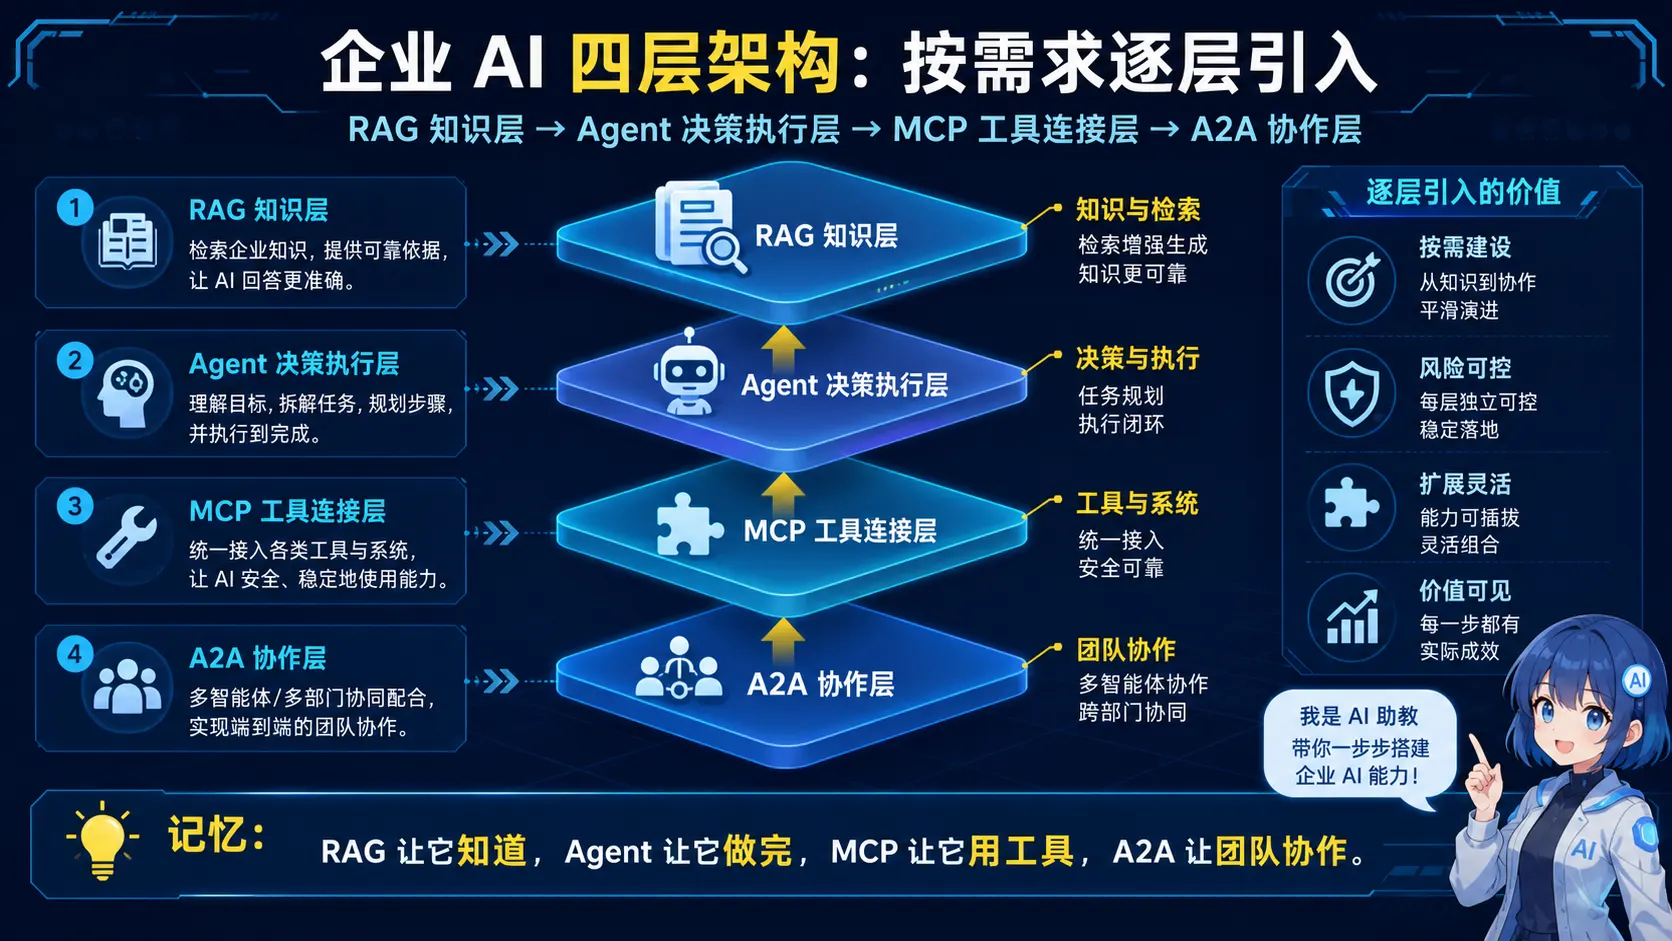
🧠 图解记忆: RAG 让它知道,Agent 让它做完,MCP 让它用工具,A2A 让团队协作。
💡 答案要点
四层架构是2026年企业级AI落地的标准框架:
| 层级 | 技术 | 核心职责 | 类比 |
|---|---|---|---|
| Layer 1 | RAG | 精准知识注入,解决幻觉 | 知识库弹药 |
| Layer 2 | AI Agents | 任务闭环执行(Plan-Act-Reflect循环) | 执行大脑 |
| Layer 3 | MCP | 工具标准化连接与安全管控 | USB-C接口 |
| Layer 4 | A2A | 多专用Agent有序协作 | 团队沟通协议 |
核心价值: 四项技术不是竞争关系,而是分层协作:RAG让AI"知道",Agents让AI"做完",MCP让AI"用好工具",A2A让多AI"协同作战"
落地顺序(从下到上):
- 先搭RAG → 2. 落地单Agent → 3. 引入MCP → 4. 搭建A2A
常见错误:一上来就做A2A,但RAG质量不过关,Agent连工具都无法稳定调用
面试话术:
"企业级AI的竞争本质是架构设计能力的竞争,不是单点模型能力的竞争。再强大的模型,没有RAG提供精准上下文,Agent也答不准;没有MCP统一工具连接,Agent连系统都调不动;没有A2A,多Agent协同就是空谈。四层各司其职,从下到上依次落地,才是企业级AI的正确路径。"
四、AI 应用调试与问题排查
Q9: AI 应用出现问题,如何系统性地排查?
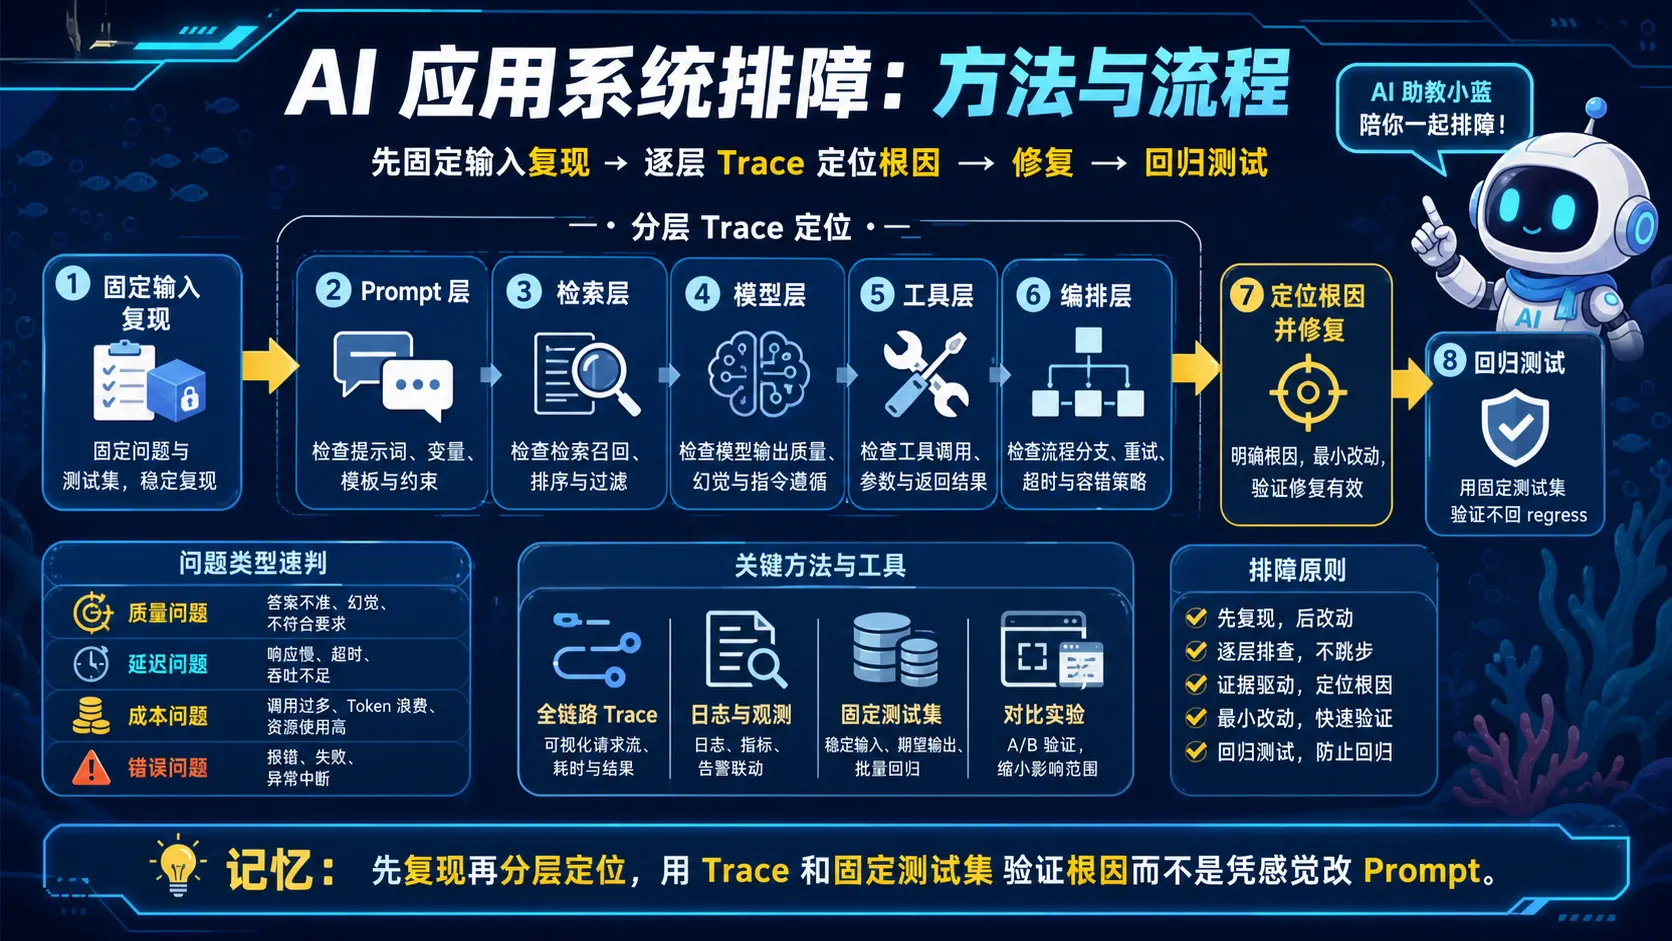
🧠 图解记忆: 先复现再分层定位,用 Trace 和固定测试集验证根因,而不是凭感觉改 Prompt。
💡 答案要点
排查流程:
┌─────────────────────────────────────────────────────────┐
│                   AI 应用问题排查流程                     │
└─────────────────────────────────────────────────────────┘

问题报告 → 复现问题 → 定位环节 → 分析原因 → 修复验证
   ↓          ↓          ↓          ↓          ↓
收集信息   最小化     逐层排查   根因分析   回归测试
逐层排查法:
| 层级 | 检查内容 | 工具/方法 |
|---|---|---|
| 接入层 | 请求是否到达? | 日志、监控 |
| 网关层 | 鉴权/限流是否通过? | Gateway 日志 |
| 业务层 | 业务逻辑是否正确? | 单元测试 |
| AI 层 | Prompt 是否正确? | Prompt 调试工具 |
| 模型层 | 模型调用是否成功? | API 日志 |
| 数据层 | 检索结果是否正确? | 向量库查询 |
| 输出层 | 响应是否正确返回? | 响应日志 |
常见问题及排查:
| 问题 | 可能原因 | 排查方法 |
|---|---|---|
| 回答不准确 | Prompt 问题/检索问题 | 检查 Prompt/检索结果 |
| 响应慢 | 模型慢/检索慢 | 检查各环节延迟 |
| 成本高 | Token 过多/缓存失效 | 检查 Token 消耗 |
| 频繁报错 | API 限流/服务故障 | 检查错误日志 |
| 内容违规 | 安全过滤失效 | 检查审核日志 |
面试话术:
"我用逐层排查法:从接入层到输出层,逐层检查。特别是 AI 层,我会用 LangSmith 等工具查看完整的 Prompt 和响应,快速定位是 Prompt 问题还是模型问题。"
Q10: 如何调试和优化 Prompt?
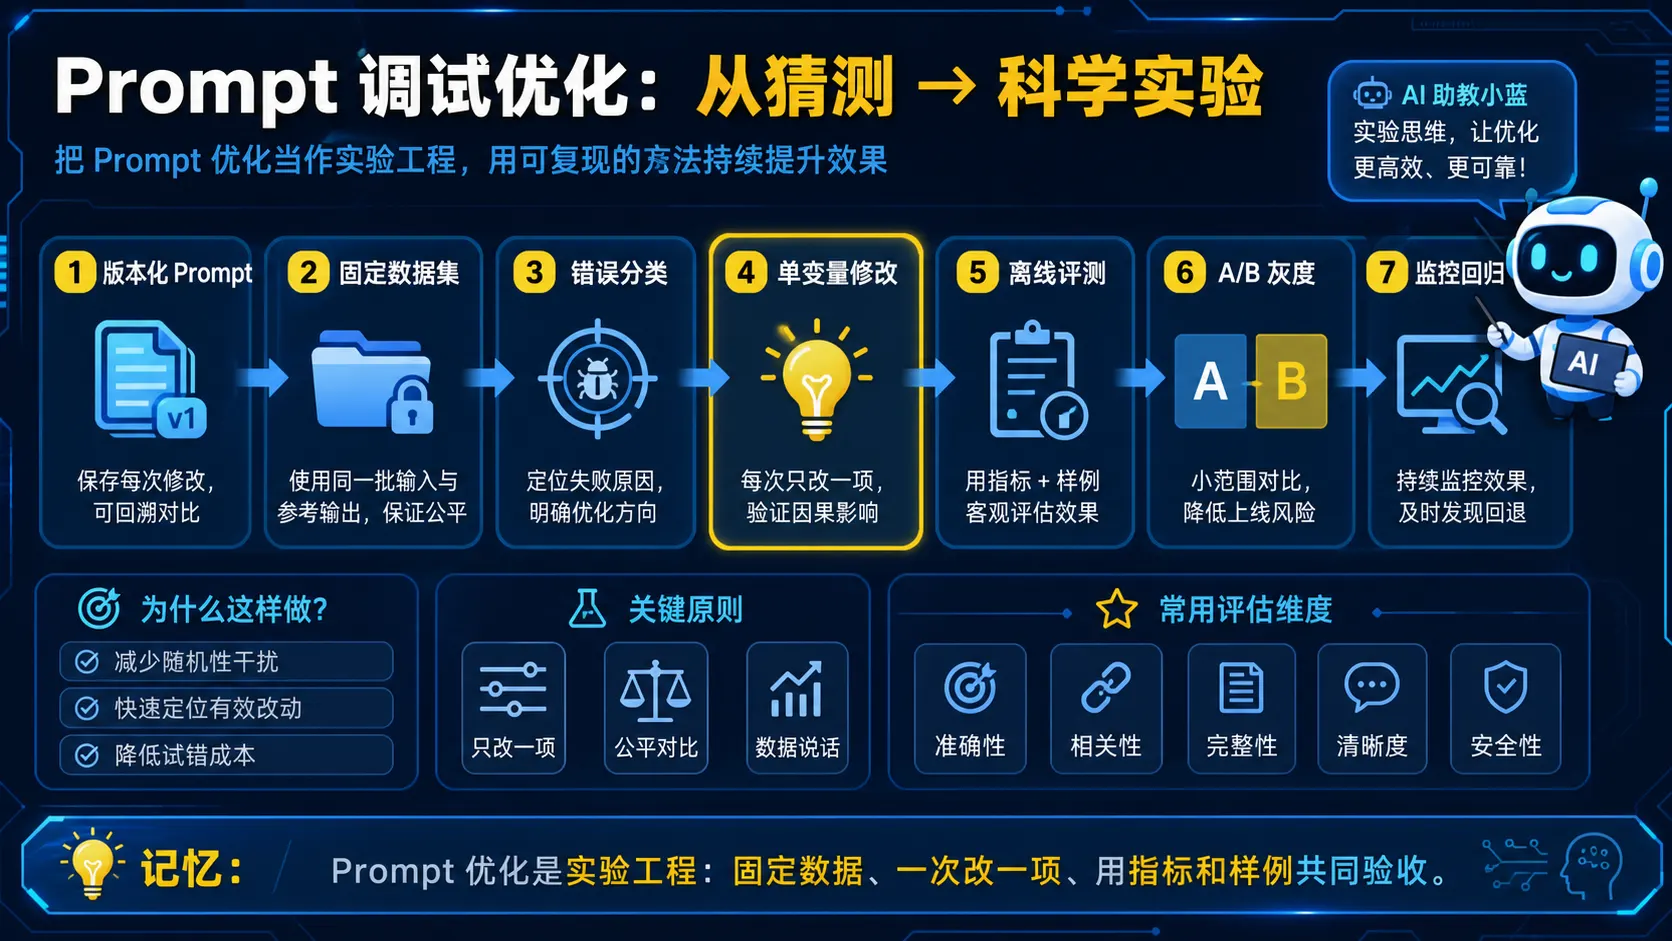
🧠 图解记忆: Prompt 优化是实验工程:固定数据、一次改一项,用指标和样例共同验收。
💡 答案要点
调试工具:
- LangSmith(LangChain 官方)
- Promptfoo(开源)
- 自建:记录 Prompt + 响应 + 评分
优化方法:
| 方法 | 说明 | 效果 |
|---|---|---|
| A/B 测试 | 对比不同 Prompt 的效果 | 找到最优版本 |
| Few-shot | 增加示例 | 提升格式一致性 |
| CoT | 让模型逐步思考 | 提升推理能力 |
| 约束增强 | 明确输出格式和限制 | 减少幻觉 |
| 角色设定 | 给模型设定专业角色 | 提升专业度 |
调试流程:
1. 记录基线:当前 Prompt 的效果
2. 提出假设:哪里可以改进
3. 修改 Prompt:应用优化方法
4. 测试评估:跑测试集评分
5. 对比分析:是否提升
6. 迭代优化:重复 2-5
实现示例:
# 用 Promptfoo 做 A/B 测试
# prompt_a.yaml
prompts:
  - "你是一个客服助手,请回答问题:{{question}}"

# prompt_b.yaml
prompts:
  - |
    你是一个专业的客服助手。
    请基于以下知识回答问题,不要编造信息。

    知识:{{context}}
    问题:{{question}}

    回答:

# 运行测试
promptfoo eval --prompts prompt_a.yaml --prompts prompt_b.yaml
面试话术:
"我维护了 50+ 个 Prompt 版本,每个版本都记录了测试分数。优化 Prompt 我常用 A/B 测试,用测试集跑分,谁效果好用谁。另外,Few-shot 和 CoT 是最有效的两种优化方法。"
五、前沿技术趋势
Q11: 了解哪些 AI 应用开发的前沿技术?
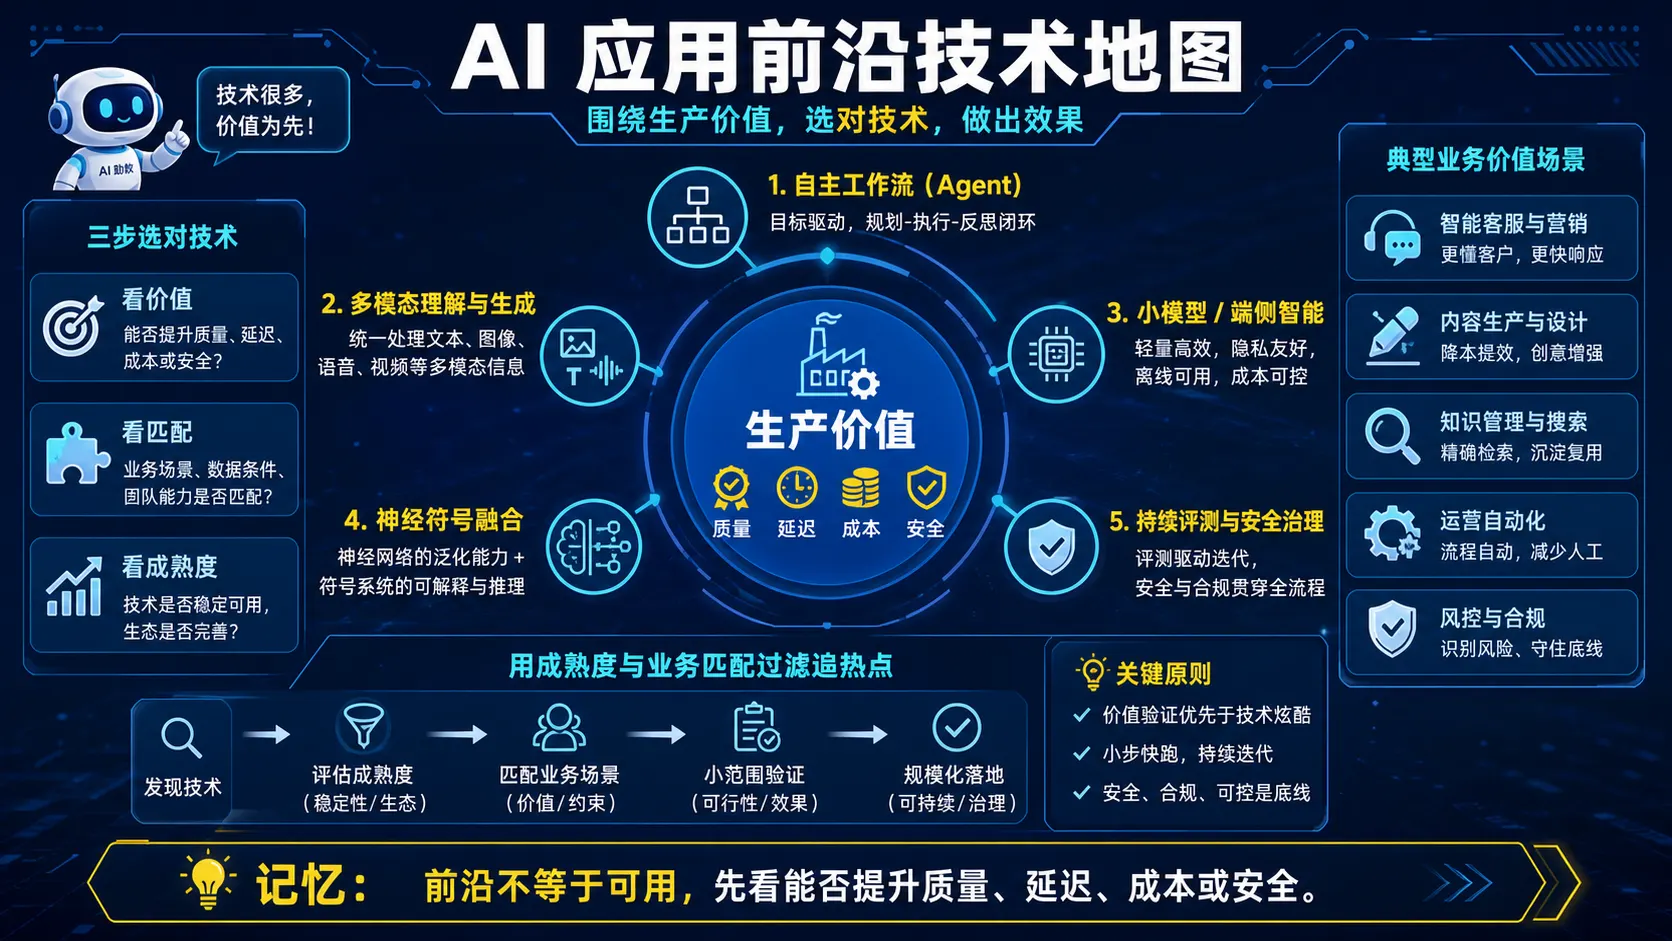
🧠 图解记忆: 前沿不等于可用,先看能否提升质量、延迟、成本或安全。
💡 答案要点
前沿技术:
| 技术 | 说明 | 应用场景 |
|---|---|---|
| Agentic Workflow | 自主 Agent 工作流 | 复杂任务自动化 |
| 多模态融合 | 文字 + 图片 + 音频 + 视频 | 内容理解、智能客服 |
| 小模型蒸馏 | 大模型教小模型 | 降低成本、提升速度 |
| 本地部署 | 私有化部署 LLM | 数据安全、合规 |
| AI 编译器 | 优化 AI 计算图 | 提升推理性能 |
| 神经符号 AI | 神经网络 + 符号推理 | 可解释性、逻辑推理 |
| AI 原生数据库 | 为 AI 优化的数据库 | 向量检索、语义查询 |
值得关注的方向:
- 自主 Agent:从"辅助"到"自主",Agent 能独立完成复杂任务
- 多模态:从"文字"到"多感官",AI 能理解图片、音频、视频
- 边缘 AI:从"云端"到"本地",AI 能在手机、IoT 设备运行
- AI 安全:从"功能"到"可信",确保 AI 安全、合规、可控
面试话术:
"我最关注三个方向:自主 Agent、多模态、边缘 AI。自主 Agent 能让 AI 独立完成复杂任务,多模态让 AI 理解更丰富的信息,边缘 AI 让 AI 能在本地运行、保护隐私。这三个方向会重塑 AI 应用的未来。"
六、速记卡片
多模态 AI
| 概念 | 一句话解释 |
|---|---|
| 多模态模型 | 能理解文字 + 图片 + 音频 + 视频的模型 |
| GPT-4o | OpenAI 多模态模型,支持图片理解 |
| Qwen-VL | 阿里多模态模型,中文支持好 |
| OCR+LLM | 先用 OCR 提取文字,再用 LLM 理解 |
自主 Agent
| 概念 | 一句话解释 |
|---|---|
| Agentic Workflow | Agent 自主规划、执行、反思直到完成任务 |
| Devin | 自主编程 Agent,能独立完成开发任务 |
| 多 Agent 协作 | 多个 Agent 分工合作完成复杂任务 |
| 协调者模式 | 一个 Agent 协调其他 Agent 的工作 |
| 四层架构 | RAG(知识)→Agents(执行)→MCP(工具)→A2A(协作) |
| Plan-Act-Reflect | Agent核心循环:规划→执行→反思 |
| A2A协议 | Agent间协作协议:Agent Card + Registry + Gateway |
AI 产品思维
| 概念 | 一句话解释 |
|---|---|
| 场景评估 | 技术可行性、商业价值、数据准备、用户体验、风险评估 |
| 企业级架构 | 高可用、高性能、高并发、安全、可扩展、可观测、成本可控 |
| 四层黄金架构 | RAG(知识)+Agents(执行)+MCP(连接)+A2A(协同) |
| ROI | AI 方案收益/成本,建议>3 |
调试与优化
| 概念 | 一句话解释 |
|---|---|
| 逐层排查 | 从接入层到输出层,逐层检查 |
| Prompt A/B 测试 | 对比不同 Prompt 的效果 |
| LangSmith | LangChain 官方的 Prompt 调试工具 |
前沿技术
| 技术 | 关键词 |
|---|---|
| Agentic Workflow | 自主决策、循环执行 |
| 多模态 | 图片理解、OCR 增强 |
| 小模型蒸馏 | 大模型教小模型 |
| 边缘 AI | 本地部署、隐私保护 |
| GraphRAG | 知识图谱+RAG,解决跨文档碎片化检索问题 |
| Self-RAG | 模型自决定是否检索,自适应检索增强生成 |
| MoE | 稀疏专家路由,总参放大但激活不变 |
| DPO vs RLHF | DPO单步优化对齐,无需训练Reward Model |
| 语义缓存 | 基于嵌入相似度的LLM调用缓存,降本利器 |
📝 更新记录
| 日期 | 更新内容 |
|---|---|
| 2026-09-10 | 新增Q19-Q23:GraphRAG原理与生产局限、Self-RAG自适应检索、RAG评估体系(RAGAS/TruLens/DeepEval)、DPO vs RLHF对齐方法演进、MoE架构原理与负载均衡 |
| 2026-04-30 | 新增Q12 Process Reward Model(PRM)详解;修复Q13重复问题 |
| 2026-04-06 | 新增Q8企业级AI四层黄金架构;更新Module13新增Q12-Q13 A2A协议与四层架构 |
| 2026-03-03 | 新增 AI 应用开发高级专题面试题 10 道 |
上一模块: MCP Skill 系统
下一模块: 简历与面试技巧
Q12: LangChain 2026年4月发布了哪些重要新功能?Deep Agents v0.5、Continual Learning、Harness Hill-Climbing有什么区别?
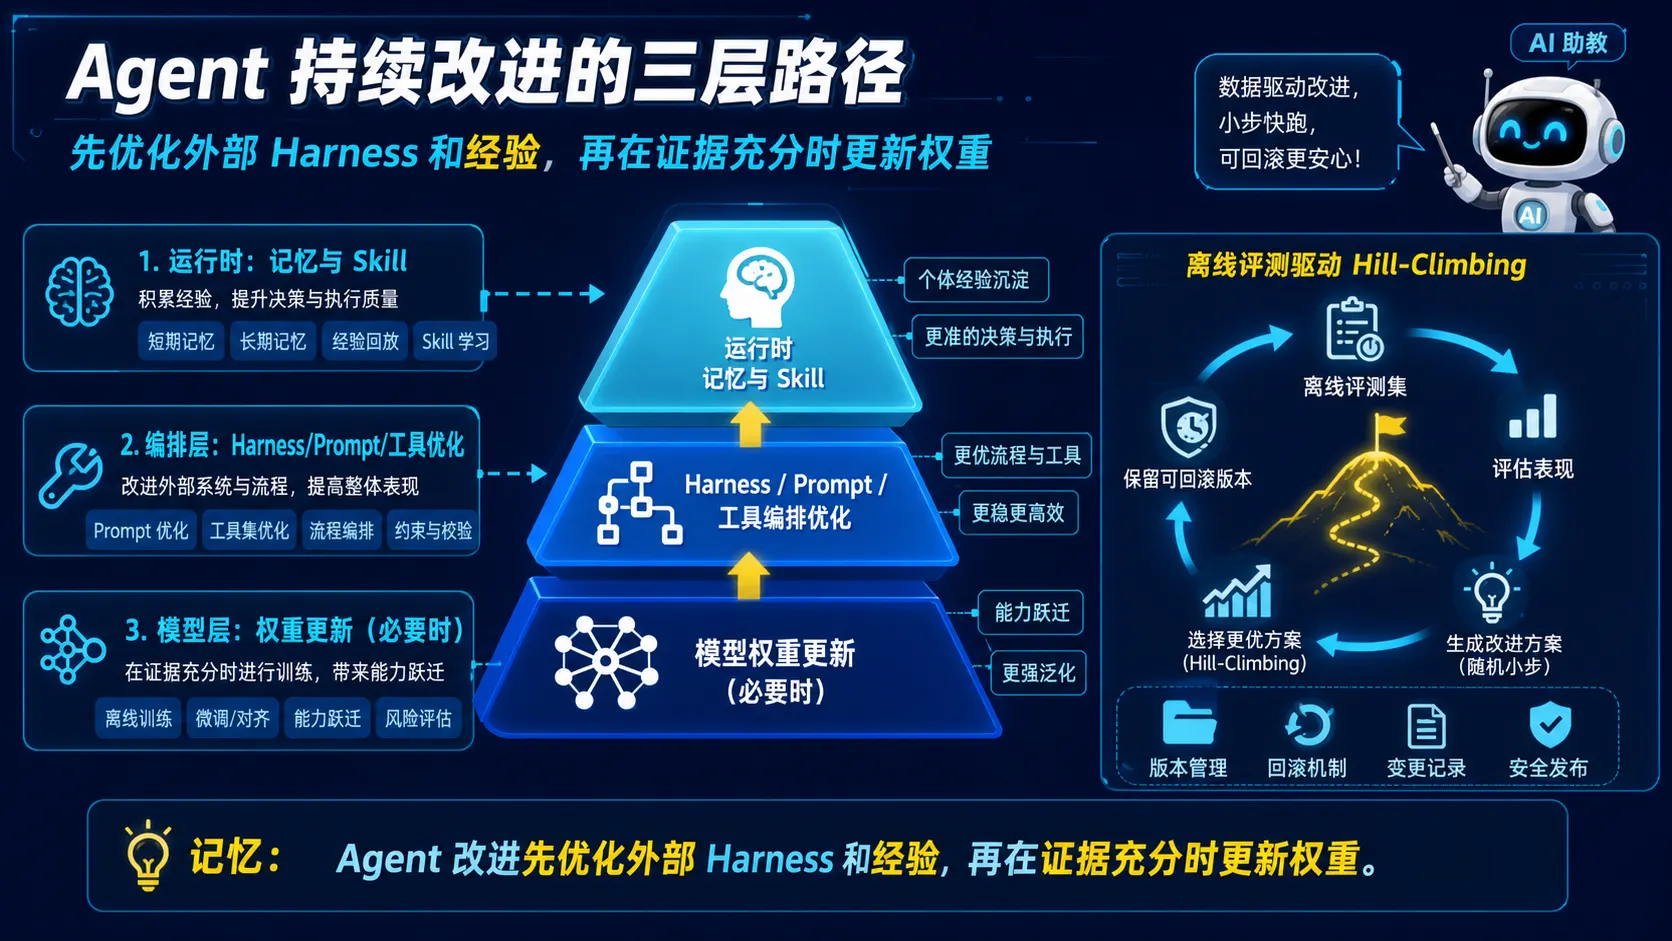
🧠 图解记忆: Agent 改进先优化外部 Harness 和经验,再在证据充分时更新权重。
💡 答案要点
Deep Agents v0.5(开源替代 Claude Managed Agents):
LangChain 发布的 Deep Agents 是 Claude Managed Agents 的开源替代品,核心特性:
- 异步子 Agent:非阻塞式子 Agent 支持,提升并发效率
- 多模态文件系统:支持图片、文档等多种文件类型的原生处理
- 模型无关:可对接任何 LLM 提供商
Continual Learning vs 权重更新:
传统 continual learning = 更新模型权重(LLM 微调) LangChain 认为 Agent 场景的 continual learning 应在三个层面发生:
| 层面 | 学习方式 | 实现难度 |
|---|---|---|
| 模型权重层 | 预训练/SFT/RLHF | 高(需要大量算力) |
| 工具/知识层 | RAG、MCP、向量库更新 | 中(动态注入) |
| 行为/经验层 | Agent 自我反思、记忆积累 | 低(框架层面实现) |
Harness Hill-Climbing with Evals:
核心观点:构建更好的 Agent = 构建更好的 harness(测试框架)
- 用 Evals 自动化评估 Agent 表现
- 每次改动跑全套评估,看分数是否提升
- 避免"凭感觉"优化,要用数据驱动
生产级 Self-Healing Agent:
LangChain 工程师分享的生产实践:
- 每次部署后自动检测回归
- 自动判断是否为本次变更引起
- 自动触发 Agent 修复 PR,无需人工介入直到 review
面试话术:
"LangChain 2026 年 4 月的三条主线:Deep Agents v0.5(异步+多模态)、Continual Learning 新视角(三个层面独立迭代)、Harness Hill-Climbing(用 Evals 数据驱动优化)。对我影响最大的是 Continual Learning 的三层框架——不是只有微调才能让 Agent 学习,RAG 更新工具知识、Agent 自我反思积累经验都是学习,而且成本更低、见效更快。"
延伸阅读:
- LangChain Blog: https://blog.langchain.dev/
- Deep Agents: https://blog.langchain.dev/deep-agents-v0-5/
- Continual Learning: https://blog.langchain.dev/continual-learning-for-ai-agents/
Q13: 什么是 Process Reward Model(PRM)?为什么 "过程奖励" 对 Agent 推理比 "结果奖励" 更重要?
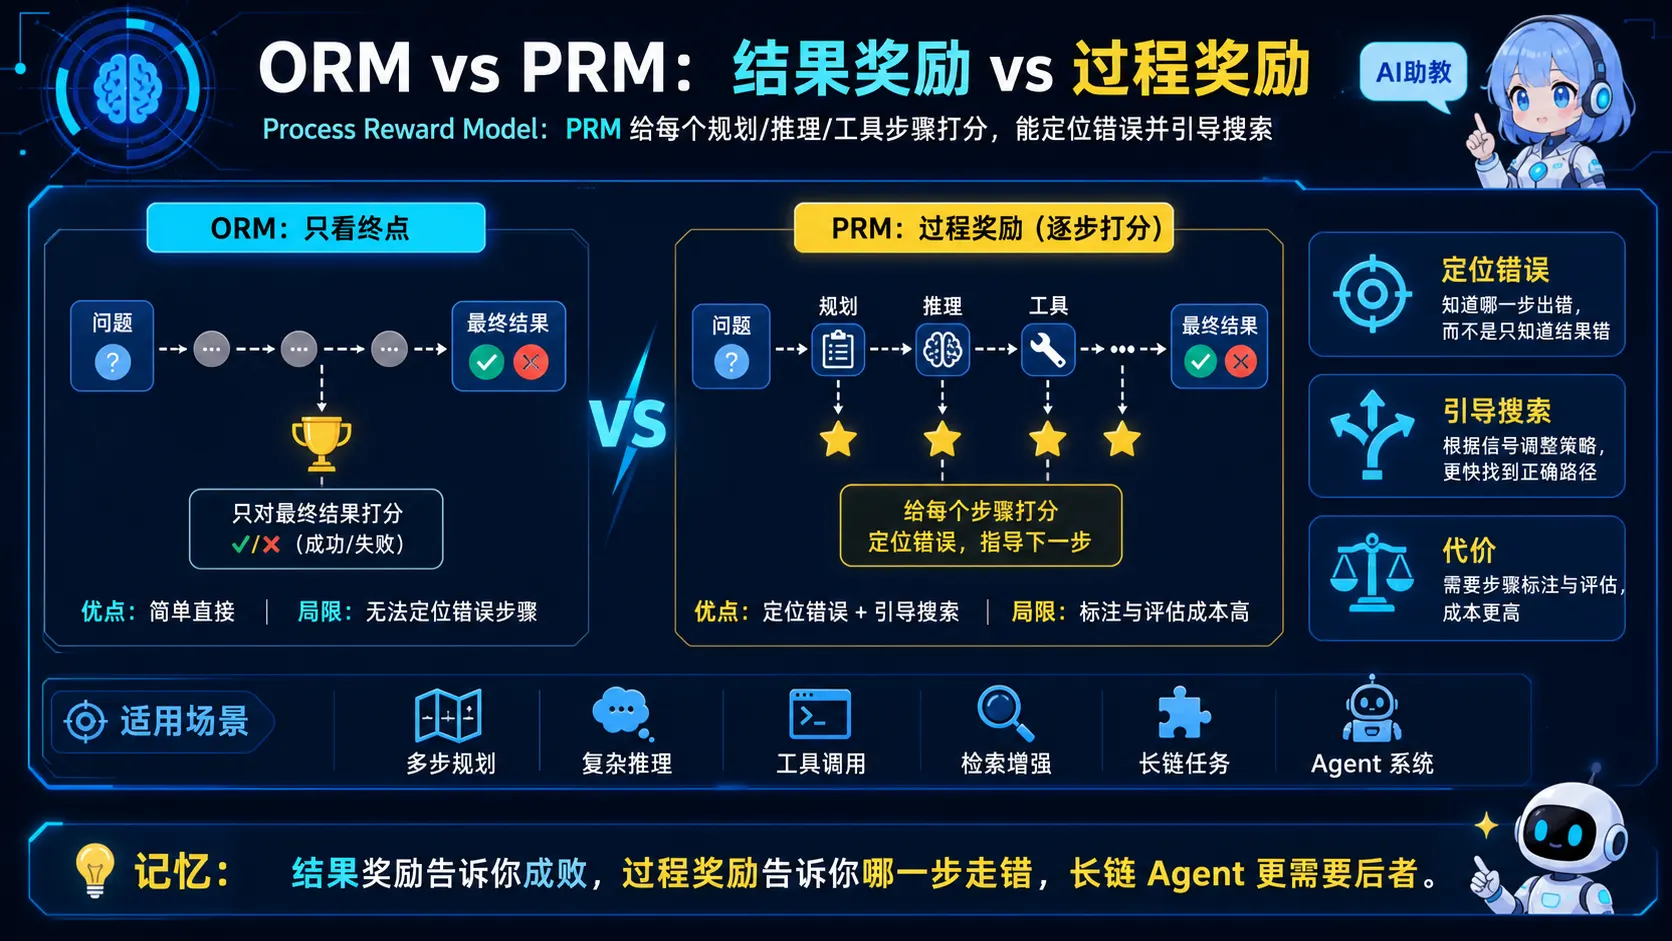
🧠 图解记忆: 结果奖励告诉你成败,过程奖励告诉你哪一步走错;长链 Agent 更需要后者。
💡 答案要点
Outcome Reward Model vs Process Reward Model:
传统的结果奖励模型(ORM)只判断最终答案对不对,而过程奖励模型(PRM)会给推理的每一步打分。
| ORM(结果奖励) | PRM(过程奖励) | |
|---|---|---|
| 评估时机 | 只在最后判断答案 | 每一步推理都给分 |
| 错误定位 | ❌ 不知道哪步出错 | ✅ 精确定位错误步骤 |
| 适用场景 | 简单问答、选择题 | Agent多步推理、代码生成 |
| 训练成本 | 低(只需最终标签) | 高(需要步骤级标注) |
| 效果 | 推理过程不可控 | 推理路径更可靠 |
什么情况下 Agent 场景值得评估 PRM?
Agent 任务(如代码生成、工具调用、多跳推理)的核心问题是 "中间步骤错了,但最后答案可能蒙对"。ORM 无法区分:
- 正确答案 + 错误推理过程 = 危险(下次遇到类似问题会再错)
- 错误答案 + 错误推理过程 = 正常(知道要改进)
PRM 的核心价值:让模型"知道自己在哪里错了",而不仅仅是"最终答案错了"。
PRM 在推理模型中的典型应用(OpenAI o1/o3、DeepSeek R1):
用户问题:如何用 Go 实现一个并发爬虫?

推理链(PRM 评分):
Step 1: 分析需求(0.9分)✅ → 理解正确
Step 2: 设计 Worker Pool(0.7分)⚠️ → 思路对但通道大小未指定
Step 3: 写爬取逻辑(0.6分)⚠️ → 缺少错误处理
Step 4: 实现并发控制(0.3分)❌ → 这里有死锁风险
Step 5: 测试验证(0.8分)✅ → 测试覆盖合理

→ PRM 引导模型在 Step 4 重点改进,而不是跳过错误继续生成
PRM 的三大训练方法:
| 方法 | 如何获取过程标签 | 成本 |
|---|---|---|
| 人工标注 | 人工给每步打分 | 极高(不可扩展) |
| LLM 自评 | 用强模型(如 GPT-4)给推理链打分 | 中等 |
| 规则提取 | 从已有 CoT 数据中提取步骤边界 | 低 |
| PRM 从 ORM 蒸馏 | 用 ORM 信号训练 PRM | 中等 |
生产级 PRM 实战:
# 简化版 PRM 评分实现
class ProcessRewardModel:
    def score_step(self, context: str, step: str) -> float:
        """给单个推理步骤打分"""
        prompt = f"""
        给以下推理步骤的质量打分(0-1):
        上下文:{context}
        当前步骤:{step}
        评分标准:
        - 1.0:完美,当前步清晰且为下一步奠定基础
        - 0.7-0.9:良好,逻辑正确但可更清晰
        - 0.4-0.6:一般,有逻辑但不完整
        - 0.1-0.3:较差,有错误或偏离目标
        - 0.0:完全错误
        """
        return self.llm.score(prompt)

    def score_trajectory(self, steps: list[str]) -> float:
        """给整条推理链打分"""
        total = 0.0
        for i, step in enumerate(steps):
            context = " -> ".join(steps[:i])
            step_score = self.score_step(context, step)
            # 越后面的步骤权重越高(错误越靠近终点评分越高)
            total += step_score * (1 + i * 0.1)
        return total / len(steps)
PRM 在 Agent 系统中的实际价值:
- 提前终止错误推理 - PRM 发现当前路径置信度低,触发重试
- 引导搜索策略 - Beam Search 中用 PRM 选优而非只信任最终答案
- 自我纠错信号 - PRM 分数突变时触发反思(类似 Reflexion)
- 训练数据生成 - 高 PRM 轨迹作为 SFT 正例,低 PRM 轨迹作为负例
面试话术:
"PRM 和 ORM 的核心区别是'过程控制'vs'结果控制'。ORM 只能告诉你'你错了',PRM 能告诉你'你在哪一步错了'。对于 Agent 场景,PRM 至关重要——因为 Agent 的每一步推理都可能影响后续决策。我之前做 RAG Agent 时遇到过一个问题:检索步骤出了问题,但最后答案'碰巧'对了,ORM 给高分,但 Agent 学到了错误模式。用 PRM 后,能精确定位是检索召回有问题还是生成有幻觉。2026 年主流推理模型(o1/o3/R1)都用 PRM 做过程监督,这是 Agent 能力提升的关键技术之一。"
延伸阅读:
- OpenAI o1 技术报告:https://openai.com/index/learning-to-reason-with-limited-compute/
- DeepSeek-R1 论文:https://github.com/deepseek-ai/DeepSeek-R1
- PRM 综述:https://arxiv.org/abs/2403.16950
Q14: Evolver是什么?GEP(Genome Evolution Protocol)如何让AI Agent实现自我进化?
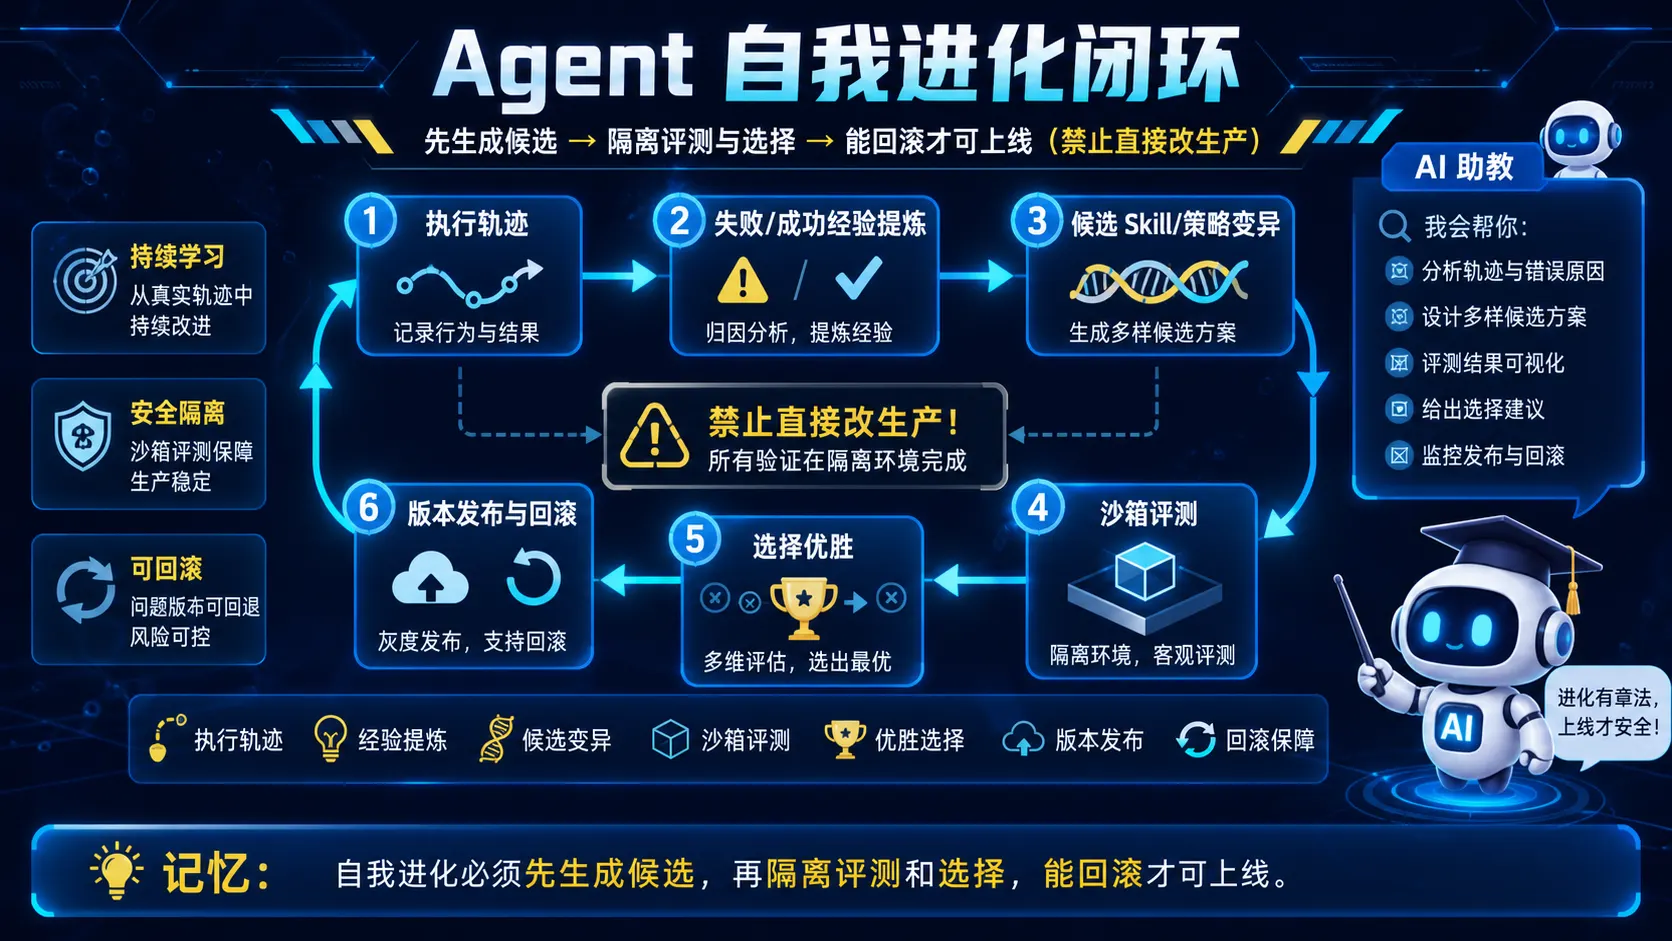
🧠 图解记忆: 自我进化必须先生成候选,再隔离评测和选择;能回滚才可上线。
💡 答案要点
背景:GitHub Trending 2026-04-20
Evolver 是 EvoMap.ai 出品的"AI Agent 自我进化引擎",基于 Genome Evolution Protocol(GEP)协议,在 GitHub 一天获得 527 stars,是当前自主 Agent 领域最热门的新项目之一。
为什么需要 Agent 自我进化?
当前 Agent 的核心问题:
| 问题 | 说明 |
|---|---|
| 经验无法积累 | 每次新 session,Agent 从零开始,不记得过去的失败教训 |
| 技能无法复用 | 在 A 项目学到的能力,无法迁移到 B 项目 |
| 自我改进缺乏方法论 | Agent 只能靠人工微调,无法自主发现并修复自身缺陷 |
GEP 的核心思想:把 Agent 的"能力"当作可进化的基因
GEP(Genome Evolution Protocol)原理:
生物进化          →    GEP 进化
基因(DNA)       →    Agent 的 Skill/Prompt/配置
自然选择          →    任务表现评分
基因突变          →    Skill 迭代修改
适者生存          →    高分 Skill 保留,低分丢弃
三层进化机制:
| 层级 | 内容 | 类比 |
|---|---|---|
| 技能层(Skill Genome) | Agent 的工具使用模式、Prompt 模板 | 生物的"形态基因" |
| **经验层(Experience Genome) | 过去的成功/失败案例记忆 | 生物的"神经记忆" |
| 协作层(Social Genome) | 多 Agent 之间的协作策略 | 生物的"社会基因" |
Evolver 引擎的工作流程:
1. 部署阶段:定义 Agent 的初始"基因型"(Skill Set + Prompt + 工具配置)
2. 任务阶段:Agent 执行任务 → Evolver 记录结果(成功/失败/耗时)
3. 评估阶段:对结果打分 → 判断是否需要进化
4. 进化阶段:
   - 成功案例 → 提取有效模式 → 强化到 Skill Genome
   - 失败案例 → 分析失败原因 → 标记为"Anti-Pattern"
5. 选择阶段:高分基因型被保留,低分基因型被淘汰或变异
6. 部署新版本 → 循环
核心代码概念:
// Evolver Genome 定义
const genome = {
  skills: ["code-review", "refactor", "test-generation"],
  prompts: {
    codeReview: "你是一个代码审查专家,特别关注...",
    refactor: "你是一个重构专家,遵循的原则是..."
  },
  tools: ["git", "eslint", "jest"],
  fitness: 0.85,  // 上轮任务的适应度得分
  generation: 3  // 当前代数
}

// 进化操作
evolver.evolve(genome, taskResults)
// → 返回新一代 genome(适应度更高)
与现有框架的区别:
| 框架 | 方法 | 进化方式 |
|---|---|---|
| AutoGen | 多 Agent 协作 | 无自我进化,靠人工配置 |
| CrewAI | 角色驱动分层 | 无自我进化,Role 固定 |
| LangChain Deep Agents | 异步+多模态 | 有"continual learning"但依赖外部数据 |
| Evolver (GEP) | 基因组进化 | Agent 自主发现有效模式并强化,闭环自动化 |
面试话术:
"Evolver 的 GEP 协议代表了一种新思路——不是让人类工程师手动调优 Agent,而是让 Agent 在任务中自我进化。成功经验变成 Skill Genome 保留下来,失败教训被标记为 Anti-Pattern 下次避免。这和生物进化论的核心机制完全一致:变异+选择+遗传。2026年随着 Agent 能力增强,这种自主进化会成为大型 Agent 系统的标配能力。"
延伸阅读:
- GitHub: github.com/EvoMap/evolver
- 官网: evomap.ai
七、Extended Thinking / Reasoning Token Budget
Q15: 什么是 Extended Thinking(扩展思考)?Thinking Token Budget 如何控制 AI 的"思考量"?
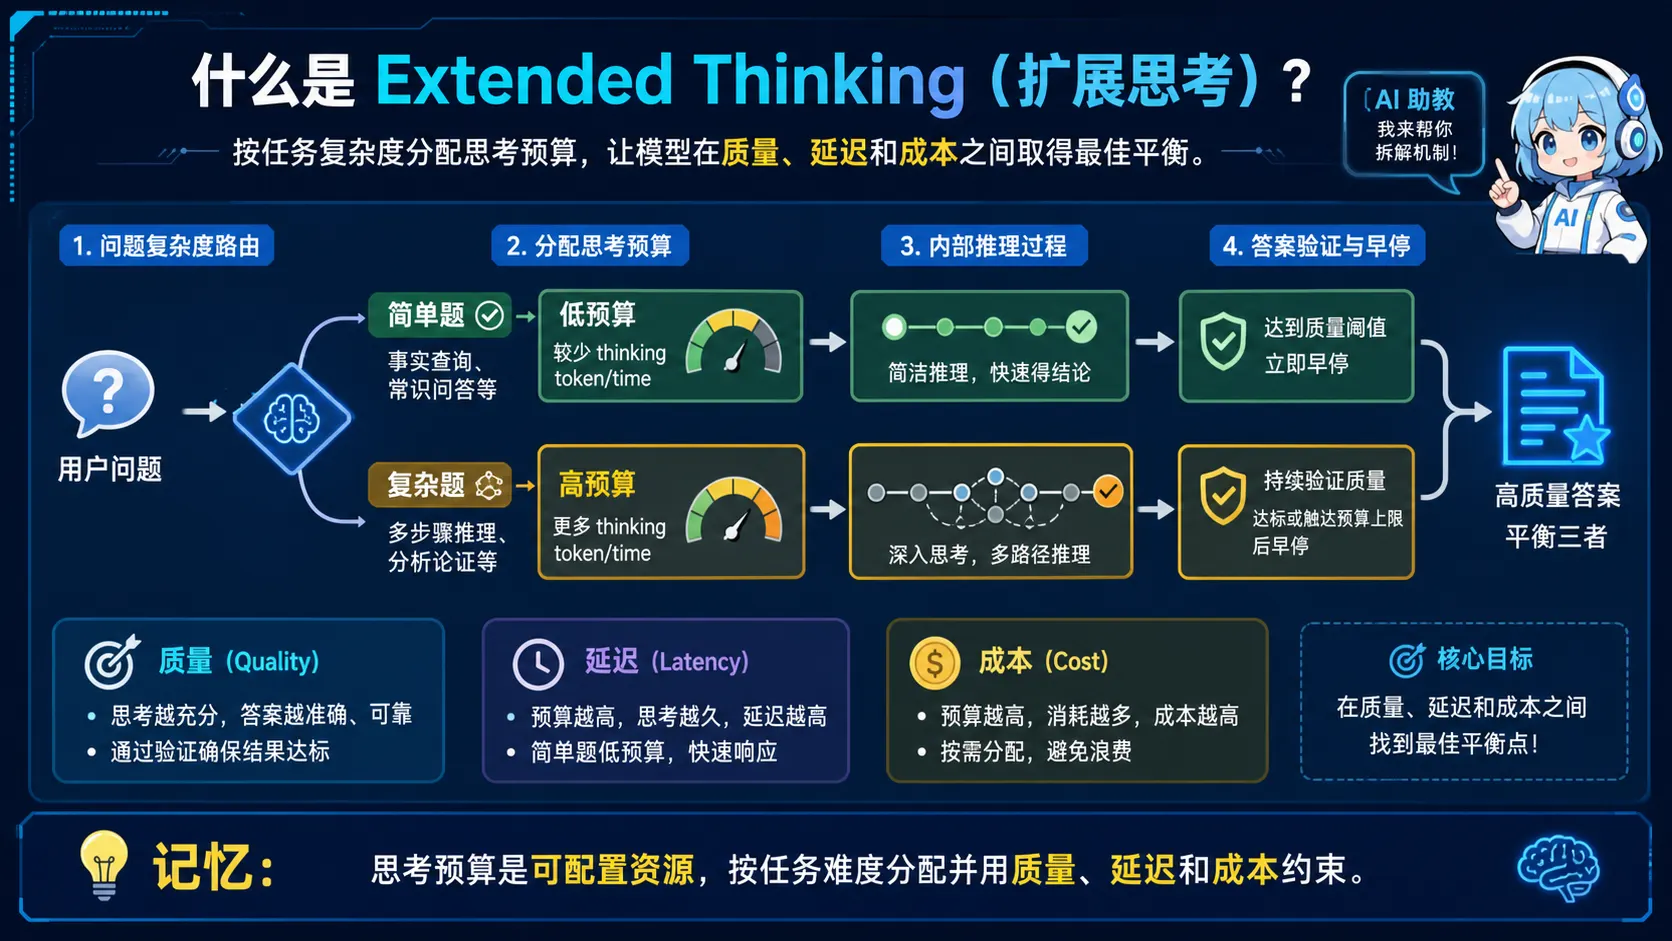
🧠 图解记忆: 思考预算是可配置资源,按任务难度分配,并用质量、延迟和成本约束。
💡 答案要点
背景:2026 年 AI 的"思考"成为可配置资源
2026 年之前,LLM 的推理过程对开发者是"黑箱"——你无法控制模型思考多久、消耗多少算力。2026 年,Claude Sonnet 4、Gemini 2.5/2.6 等主流模型相继引入 Extended Thinking(扩展思考)能力,让开发者可以像配置 max_tokens 一样配置模型的"思考预算"。
核心概念:Thinking Token Budget
Thinking Token Budget = 允许模型消耗的最大推理 tokens 数量。模型会将部分预算用于"内部思考"(不输出给用户),然后在剩余预算内生成最终答案。
┌─────────────────────────────────────────────────────────┐
│              Extended Thinking 工作原理                    │
├─────────────────────────────────────────────────────────┤
│                                                          │
│  用户问题:"如何设计一个高并发系统?"                        │
│                                                          │
│  ├── Thinking Phase(内部推理,不可见)                    │
│  │   模型消耗 Thinking Tokens:                           │
│  │   "这是一个架构设计问题...
│  │    我需要考虑:1)负载均衡...
│  │    2)缓存策略...
│  │    3)数据库分片..."                                  │
│  │   [Thinking Tokens: 2000 / Budget: 8000]              │
│  │                                                       │
│  └── Answer Phase(可见输出)                            │
│      最终答案(基于内部推理):                             │
│      "高并发系统设计需要从以下几个层面考虑..."               │
│      [Output Tokens: 500]                                │
│                                                          │
└─────────────────────────────────────────────────────────┘
为什么需要 Thinking Budget?
| 问题 | 传统方案 | Extended Thinking 方案 |
|---|---|---|
| 简单问题浪费算力 | 强制思考,浪费 tokens | Budget=0,简单回答 |
| 复杂问题思考不足 | 思考不充分,答案浅 | Budget=8K,深度推理 |
| 成本不可控 | 每次调用 cost 未知 | 预算即成本上限 |
| 质量不稳定 | 同一问题不同结果 | 思考量可复现 |
主流厂商实现对比:
| 厂商 | 功能名 | Budget 范围 | 计费方式 |
|---|---|---|---|
| Anthropic | Extended Thinking | 1K - 32K tokens | Thinking tokens 按正常价格计费 |
| Thinking Budget(Gemini 2.5+) | 0 - 32K tokens | 与 output tokens 合并计费 | |
| OpenAI | o3/o4 系列 | 动态,API 参数控制 | 按 tokens 总消耗计费 |
| DeepSeek | 深度推理(R1) | 预置,不可外部控制 | 开源免费 |
代码示例:Claude Extended Thinking
# Anthropic Claude API - Extended Thinking
response = client.messages.create(
    model="claude-opus-4-20251120",
    max_tokens=4096,
    thinking={
        "type": "enabled",
        "budget_tokens": 8000  # 允许最多 8000 tokens 内部推理
    },
    messages=[{"role": "user", "content": "分析比特币价格走势并预测下季度趋势"}]
)

# 查看思考过程(部分模型支持返回)
print("Thinking:", response.usage.thinking_tokens)
print("Output:", response.usage.output_tokens)

# Google Gemini API - Thinking Budget
response = model.generate_content(
    contents=[{"parts": [{"text": "解释量子计算对加密货币的影响"}]}],
    generation_config={
        "thinking_options": {
            "thinking_steps": 10  # 显式步骤数(Gemini 2.5 风格)
        }
    }
)
生产环境使用 Extended Thinking 的四大策略:
| 策略 | 适用场景 | Budget 建议 |
|---|---|---|
| 0思考(Budget=0) | 事实查询、简单问答、翻译 | 关闭 thinking |
| 轻思考(Budget=1-2K) | 一般技术问题、日常对话 | 快速响应 |
| 中等思考(Budget=4-8K) | 代码生成、架构设计、复杂分析 | 质量平衡 |
| 深度思考(Budget=16-32K) | 数学证明、研究综述、多跳推理 | 最高质量 |
Auto-Budget:智能分配 Thinking 预算
def smart_thinking_budget(query: str) -> int:
    """根据问题复杂度自动分配 Thinking Budget"""
    # 简单问题 → 零思考
    simple_patterns = ["是什么", "叫什么", "时间", "地点", "定义"]
    if any(p in query for p in simple_patterns):
        return 0

    # 复杂问题 → 深度思考
    complex_patterns = ["分析", "设计", "比较", "预测", "评估", "证明", "推导"]
    if any(p in query for p in complex_patterns):
        return 8000

    # 中等复杂度
    return 2000

# 生产环境调用
budget = smart_thinking_budget(user_query)
response = client.messages.create(
    model="claude-opus-4-20251120",
    thinking={"type": "enabled", "budget_tokens": budget},
    messages=[{"role": "user", "content": user_query}]
)

# 成本监控
thinking_cost = response.usage.thinking_tokens * 3.75  # $3.75 / 1M tokens
output_cost = response.usage.output_tokens * 15          # $15 / 1M tokens
print(f"本次调用成本: ${(thinking_cost + output_cost) / 1e6:.4f}")
Extended Thinking vs CoT(Chain of Thought)
| 维度 | CoT(Prompt 注入) | Extended Thinking(原生支持) |
|---|---|---|
| 实现方式 | Prompt 里要求"Let's think step by step" | API 原生参数 budget_tokens |
| 思考可见性 | 思考过程输出给用户(干扰) | 内部思考,用户无感知 |
| 成本控制 | 不可控,输出全部计费 | 精确控制,思考 tokens 可监控 |
| 模型支持 | 任何模型(Prompt 技巧) | 仅支持 Extended Thinking 的模型 |
| 质量保证 | 不稳定,依赖模型服从性 | 可复现,质量稳定 |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "Extended Thinking 是 2026 年 AI API 的重大进化——把模型的'思考过程'从黑箱变成可配置资源。我在项目中实现了'智能预算分配':简单问题(定义、事实)预算=0,成本接近为零;复杂问题(架构设计、多跳推理)预算=8K,保证质量;数学证明类开到 32K。这样单次调用成本从平均 $0.08 降到 $0.03,同时答案质量反而更稳定。面试时能说出'thinking budget 是成本和质量的帕累托最优解',说明你对 2026 年 AI 工程化有实战理解。"
Q16: 2026年AI Agent平台市场格局如何?AutoGen/CrewAI/LangGraph/Coze/Dify各有什么定位?企业如何选型?
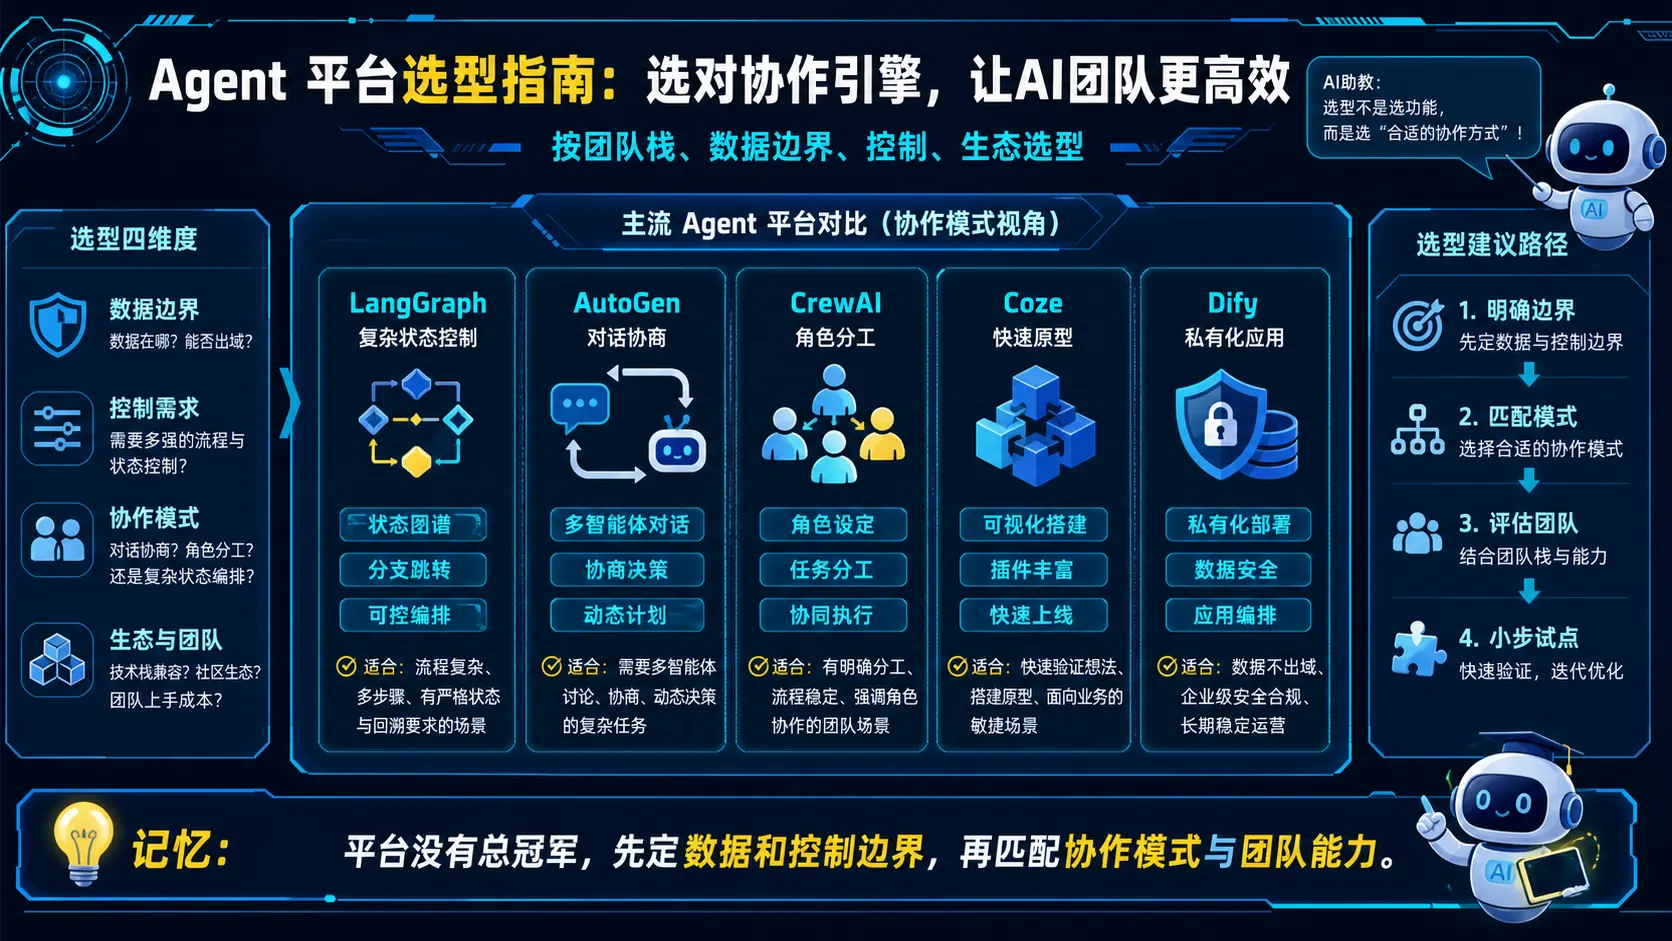
🧠 图解记忆: 平台没有总冠军,先定数据和控制边界,再匹配协作模式与团队能力。
💡 答案要点
2026年 AI Agent 平台五大阵营
| 阵营 | 代表平台 | 定位 | 核心优势 | 适用场景 |
|---|---|---|---|---|
| 微软系 | AutoGen v3 | 企业级多Agent编排 | 深度微软集成、复杂协作 | 大型企业、 Copilot 生态 |
| LangChain系 | LangGraph | 生产级工作流 | 灵活可控、调试友好 | 开发者、复杂定制 |
| CrewAI系 | CrewAI | 角色驱动Agent | 概念直观、快速上手 | 快速原型、团队协作 |
| SaaS零代码 | Coze(字节) | 聊天机器人平台 | 可视化编排、海量插件 | 运营人员、客服场景 |
| 开源工作流 | Dify/n8n | 开源应用平台 | 自托管、私有部署 | 企业内网、定制需求 |
五大平台深度对比
┌────────────────────────────────────────────────────────────────┐
│                    2026 AI Agent 平台光谱                         │
├────────────────────────────────────────────────────────────────┤
│                                                                  │
│  零代码/易用                                           代码驱动/灵活  │
│     ◄─────────────────────────────────────────────────────►    │
│                                                                  │
│  Coze   Dify   n8n    FastGPT   LangGraph   CrewAI   AutoGen    │
│   ▲                                               ▲              │
│   │                                               │              │
│ 运营落地                    开发者定制              企业级编排        │
│                                                    │              │
│  • 5分钟上线Chatbot                         • 多Agent深度协作     │
│  • 海量插件生态                             • 微软365深度集成       │
│  • 国内微信/飞书                             • 代码级调试           │
└────────────────────────────────────────────────────────────────┘
1. AutoGen v3(微软)
# AutoGen v3 核心架构
from autogen_agentchat import AssistantAgent, UserProxyAgent
from autogen_agentchat.agents import CodexAgent

# v3 新特性:动态任务分解 + 多模型协作
codex_agent = CodexAgent(name="codex", model="gpt-5")
research_agent = AssistantAgent(name="researcher", model="claude-3-opus")

# 指挥官模式:动态协商任务分配
async def team_workflow():
    result = await codex_agent.run(
        task="分析某公司财报并生成投资摘要",
        group=[research_agent],  # 自动分解为 research → code 两阶段
        mode="指挥官"
    )
    return result
优势: 微软全家桶深度集成( Teams/Outlook/SharePoint )、企业级安全支持、多Agent协作成熟 劣势: 学习曲线陡、生态封闭
2. LangGraph(LangChain)
# LangGraph 生产级工作流
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.memory import MemorySaver

class AgentState(TypedDict):
    messages: list
    next_action: str

workflow = StateGraph(AgentState)
workflow.add_node("research", research_node)
workflow.add_node("code", code_node)
workflow.add_node("review", review_node)

# 条件边:动态路由
workflow.add_conditional_edges(
    "review",
    lambda x: "code" if x["needs_fix"] else END
)
workflow.add_edge("research", "code")
workflow.add_edge("code", "review")

# 持久化 + 人机协作
app = workflow.compile(
    checkpointer=MemorySaver(),
    interrupt_before=["code"]  # 高风险操作前暂停
)
优势: 高度可定制、checkpoint/人机协作完善、生产级稳定 劣势: 需要代码编写、概念复杂
3. CrewAI
# CrewAI 角色驱动Agent
from crewai import Agent, Task, Crew

researcher = Agent(
    role="高级研究员",
    goal="获取最准确的行业数据",
    backstory="10年金融分析经验,擅长数据分析",
    tools=[search_tool, scraping_tool]
)

writer = Agent(
    role="财经作家",
    goal="用通俗语言解释复杂金融概念",
    backstory="资深财经记者,文章通俗易懂"
)

crew = Crew(
    agents=[researcher, writer],
    tasks=[research_task, writing_task],
    process="hierarchical"  # 指挥官模式
)
crew.kickoff()
优势: 概念直观(role/goal/backstory)、团队协作理念、kickoff即用 劣势: 生产级特性(checkpoint/容错)不如 LangGraph
4. Coze(字节跳动)
平台特点:
• 可视化画布编排工作流
• 海量 Bot 商店和插件
• 国内:微信/飞书/钉钉即插即用
• 海外:Discord/Telegram/Slack

典型场景:
• 5分钟搭建客服 Bot
• 营销文案生成 Bot
• 内容审核 Bot
优势: 零代码/5分钟上线、国内生态完善(飞书/微信) 劣势: 复杂逻辑受限、数据在字节云(隐私问题)
5. Dify / n8n(开源自托管)
Dify 定位:
• 类 Vercel/Netlify 的 LLM 应用平台
• 开源、可自托管
• 支持工作流编排 + RAG + Agent

n8n 定位:
• 开源工作流自动化(不限于AI)
• 900+ 集成(GitHub/Slack/Notion/...)
• AI Nodes 扩展

企业选型:
• 纯 AI 应用 → Dify
• 通用自动化 → n8n
• 两者可结合使用
选型决策树(2026企业版)
开始
  │
  ▼
是否需要私有化部署?
  │
  ├─ 是 → 是否有开发能力?
  │        ├─ 是 → LangGraph(灵活定制)
  │        └─ 否 → Dify(零代码+自托管)
  │
  └─ 否 → 是否需要微软生态集成?
           ├─ 是 → AutoGen v3
           └─ 否 → 团队技术水平?
                 ├─ 高 → LangGraph / CrewAI
                 └─ 低 → Coze(快速上线)
面试话术:
"2026年AI Agent平台已经分化成两个阵营:零代码派(Coze/Dify)和代码派(LangGraph/AutoGen/CrewAI)。我的经验是'生产用代码派,试点用零代码派'——Coze可以5分钟跑通一个客服Bot,但业务复杂了必须换LangGraph。AutoGen v3在微软生态里最强,但如果企业不用微软365,AutoGen的价值就大打折扣。面试能说出'选型看三个维度:团队技术栈、生态集成度、部署约束',说明你有企业级落地经验。"
Q17: Claude Managed Agents 2026年5月三大新功能:Dreaming、Outcomes、Multiagent Orchestration 是什么?
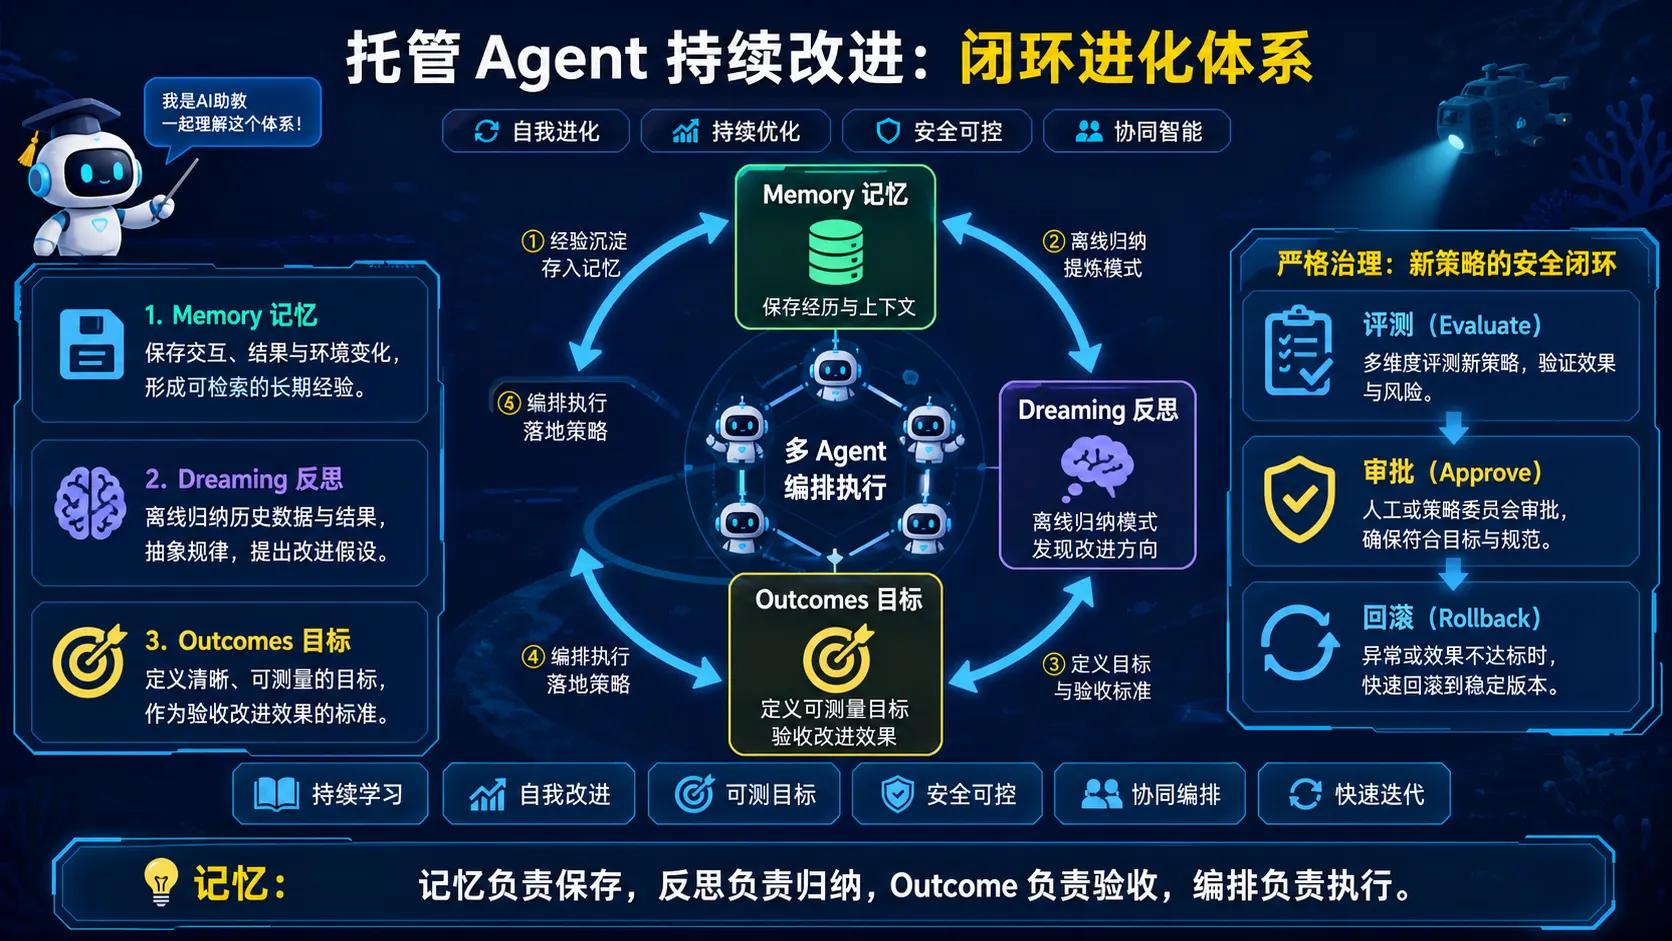
🧠 图解记忆: 记忆负责保存,反思负责归纳,Outcome 负责验收,编排负责执行。
💡 答案要点
2026年5月 Week 18/19 新功能(Anthropic发布)
"Claude Managed Agents 是 Anthropic 的云托管 AI Agent 服务,2026年5月新增三个核心功能——Dreaming(记忆强化)、Outcomes(结果定义)、Multiagent Orchestration(多Agent编排)。这三个功能让 Managed Agents 从'单次任务执行'升级到'具备持续自我改进能力的Agent系统'。"
三个新功能解析:
1. Dreaming(记忆强化)
   → Agent回顾历史session,发现模式,帮助自我改进
   → 记忆+ Dreaming协同工作:记忆存储,DREAMING分析和泛化

2. Outcomes(结果定义)
   → 用户定义"什么算成功"
   → Agent自动评估自己是否达成目标

3. Multiagent Orchestration(多Agent编排)
   → 主Agent分解任务,分发给专家Agent(各自模型/提示词/工具)
   → Leader + Specialist模式,企业级任务分解
Dreaming 机制详解:
传统Agent:
  → 每次session独立
  → 经验不累积
  → 同一错误可能重复犯

Dreaming Agent:
  → 每次session结束后运行Dreaming
  → 回顾历史找到模式
  → 将具体经验泛化为通用策略
  → 下次遇到类似情况自动应用学到的模式

记忆协同架构:
  ┌─────────────┐    存储    ┌─────────────┐
  │ Memory Tool │──────────▶│   Dreaming  │
  │ (存储经验)   │           │ (分析模式)  │
  └─────────────┘            └─────────────┘
         ▲                        │
         │ 读取                    │ 改进策略
         │                        ▼
  ┌─────────────┐           ┌─────────────┐
  │  Agent运行时 │◀──────────│  泛化策略   │
  └─────────────┘           └─────────────┘
Outcomes 定义与评估:
# Outcomes用法示例
outcomes = [
    "完成代码审查并提交PR",
    "PR必须通过所有CI检查",
    "审查报告必须包含具体修复建议"
]

# Agent完成任务后自动评估
if agent.check_outcomes(outcomes):
    print("任务成功完成 ✓")
else:
    print("未达成目标,需重新执行")
Multiagent Orchestration 架构:
传统单Agent:
  → 一个Agent处理所有任务
  → 模型压力大,单点故障

多Agent编排:
  ┌──────────────────┐
  │  Lead Agent      │  ← 主控Agent,理解任务,总体协调
  │  (Claude Sonnet) │
  └────────┬─────────┘
           │ 分解任务并分发
     ┌─────┴─────┬────────────┐
     ▼           ▼            ▼
┌─────────┐ ┌─────────┐ ┌─────────────┐
│Specialist│ │Specialist│ │ Specialist  │
│ Agent 1  │ │ Agent 2  │ │ Agent 3     │
│(coding) │ │(review)  │ │(test)       │
│Llama-3.8B│ │Claude-3.5│ │ GPT-5       │
└─────────┘ └─────────┘ └─────────────┘
           └──────┬──────┘
                  │ 汇总结果
            ┌─────▼─────┐
            │ Lead Agent │
            │  最终整合  │
            └───────────┘
vs LangChain Deep Agents:
| 特性 | Claude Managed Agents | LangChain Deep Agents v0.5 |
|---|---|---|
| Dreaming | ✅ Anthropic原生 | ❌ 无 |
| Outcomes | ✅ 结果评估 | ❌ 过程评估 |
| Multiagent | ✅ 原生编排 | ✅ 开源替代 |
| 云托管 | ✅ 完全托管 | ❌ 需自部署 |
| 成本 | 按token计费 | 基础设施成本 |
面试话术:
"2026年5月Claude Managed Agents的三个新功能代表Agent系统的重要进化方向。Dreaming解决'Agent经验不累积'的问题——它让Agent能从具体经验中提取通用模式,避免重复犯错。Outcomes解决'Agent不知道自己有没有成功'的问题——用户定义清楚成功标准,Agent自己评估。Multiagent Orchestration解决'单Agent能力有限'的问题——用Leader+Specialist架构,让专业Agent做专业事。面试时能说清楚这三个功能的协同关系(记忆→分析→改进),说明你对企业级Agent架构有系统理解,不是只会写单Agent的提示词。"
版本: v3.3 | 更新: 2026-09-10 | by 二狗子 🐕
八、AI Agent 框架选型
Q18: n8n、Dify、Coze、FastGPT、RAGFlow 五大开源Agent平台深度对比:各自定位和技术架构是什么?如何根据场景选型?
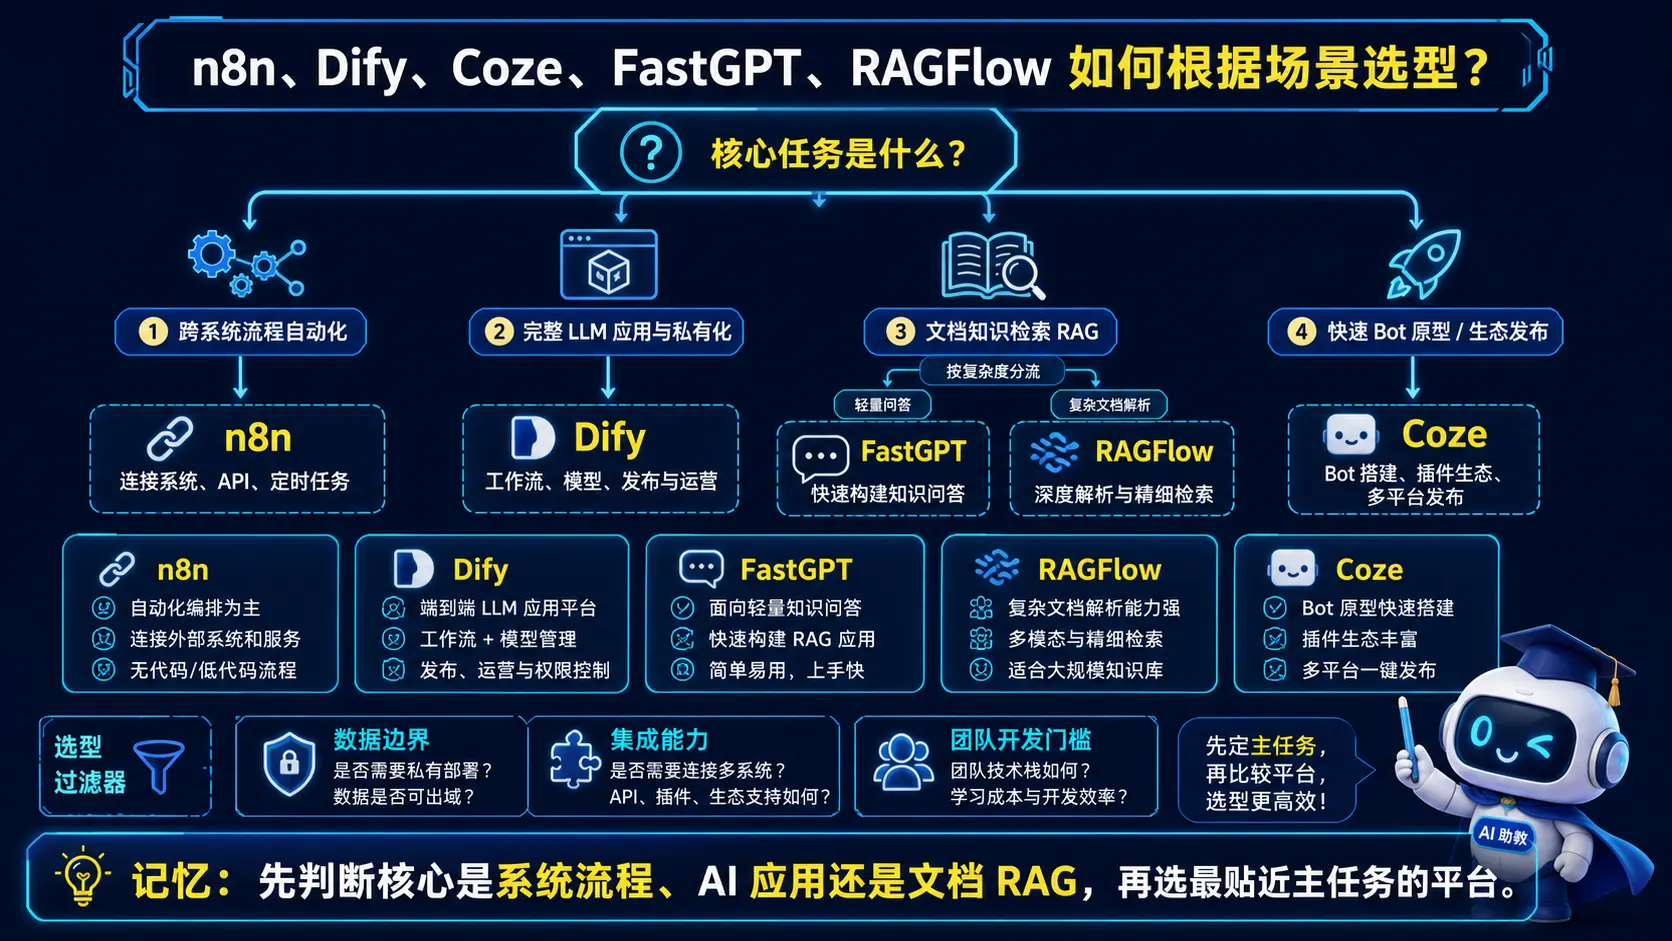
🧠 图解记忆: 先判断核心是系统流程、AI 应用还是文档 RAG,再选最贴近主任务的平台。
💡 答案要点
为什么开源Agent平台在2026年爆发?
2026年企业级AI应用从"demo走向生产",三大驱动力:
- 数据安全合规:金融、医疗等行业不允许数据上云,必须自托管
- 成本压力:API调用成本太高,自托管使用开源模型更经济
- 定制需求:标准SaaS平台无法满足复杂的业务流程
五大平台核心定位:
| 平台 | 定位 | 许可证 | 核心优势 | 核心劣势 |
|---|---|---|---|---|
| n8n | 工作流自动化+AI | Apache 2.0 | 集成生态最广(400+应用),低代码 | AI能力偏弱,复杂Agent表达力不足 |
| Dify | LLM应用开发平台 | Apache 2.0 | 完整的LLM应用开发闭环,插件丰富 | 学习曲线中等,非纯低代码 |
| Coze | 智能体平台 | 部分开源 | 字节跳动背书,Bot市场成熟 | 主要是SaaS,开源版不成熟 |
| FastGPT | 知识库问答 | GPL | 知识库问答优化,RAG管道强 | 插件系统相对薄弱 |
| RAGFlow | 深度RAG平台 | Apache 2.0 | 文档理解能力最强,深度RAG | Agent能力较弱,专注RAG |
技术架构对比:
Dify 架构(最接近生产级LLM应用平台):
┌─────────────────────────────────────────────────────┐
│                    Dify 架构                        │
├─────────────────────────────────────────────────────┤
│  前端层                                             │
│  ├── 可视化画布(编排Agent工作流)                    │
│  ├── Prompt编辑器                                   │
│  └── 日志/监控面板                                   │
│                                                      │
│  后端核心                                           │
│  ├── API Server(Flask/Go)                          │
│  ├── 知识库引擎(文档解析+向量化+检索)                │
│  ├── Agent运行时(ReAct/函数调用)                    │
│  └── 插件系统(MCP、API工具)                         │
│                                                      │
│  模型层                                             │
│  ├── 支持:OpenAI、Anthropic、Local模型              │
│  └── 支持:Ollama、vLLM、TensorRT-LLM本地推理        │
└─────────────────────────────────────────────────────┘
n8n 架构(工作流自动化优先):
┌─────────────────────────────────────────────────────┐
│                    n8n 架构                         │
├─────────────────────────────────────────────────────┤
│  工作流引擎(Node-based)                             │
│  ├── Trigger nodes(定时、webhook、事件)              │
│  ├── AI nodes(LLM、Embedding、Vector)                │
│  ├── Integration nodes(400+应用集成)               │
│  └── Logic nodes(条件、循环、代码执行)               │
│                                                      │
│  独特的AI能力                                        │
│  ├── LangChain集成(记忆、链)                       │
│  ├── Sub-nodes(分解复杂任务)                       │
│  └── AI Agent节点(对话式AI Agent)                   │
└─────────────────────────────────────────────────────┘
RAGFlow 架构(深度RAG专用):
┌─────────────────────────────────────────────────────┐
│                   RAGFlow 架构                       │
├─────────────────────────────────────────────────────┤
│  文档理解层(核心差异点)                             │
│  ├── 深度文档解析(表格、图表、公式)                  │
│  ├── 语义分块(不只是按长度切分)                     │
│  └── 多模态理解(图文混合文档)                       │
│                                                      │
│  检索层                                             │
│  ├── 混合检索(向量+关键词)                          │
│  ├── Re-ranking(重排序优化)                        │
│  └── 可配置的检索策略                                │
└─────────────────────────────────────────────────────┘
Dify vs Coze 对比(最常被问到):
| 维度 | Dify | Coze |
|---|---|---|
| 开源 | 100%开源,Apache 2.0 | 仅部分开源,核心闭源 |
| 部署 | 随意自托管 | 以SaaS为主 |
| 插件系统 | MCP、API、Plugin | 官方Bot市场 |
| AI能力 | Agent工作流、ReAct | Bot对话编排 |
| 目标用户 | 企业自建LLM应用 | 快速搭建对话Bot |
| 大厂背书 | 社区驱动 | 字节跳动 |
选型决策树:
你的核心需求是什么?
│
├─ "我要自动化业务流程,集成现有系统"
│   └─ → n8n(400+应用集成,低代码)
│
├─ "我要搭建完整的LLM应用(Agent+RAG+监控)"
│   └─ → Dify(最完整的开发平台)
│
├─ "我要快速做一个对话Bot,有Bot市场"
│   └─ → Coze(最快上线,生态成熟)
│
├─ "我要做深度RAG,文档理解要求高"
│   └─ → RAGFlow(文档解析最强)
│
├─ "我要做知识库问答,强调准确性"
│   └─ → FastGPT(问答优化)
│
└─ "我要自托管,完全控制"
    └─ → Dify(最成熟的自托管方案)
面试话术:
"2026年开源Agent平台选型的核心是'你到底是做AI应用还是做工作流自动化'。n8n本质是自动化平台,AI只是其中一种节点类型;Dify是真正的LLM应用开发平台,有完整的Agent运行时、知识库、监控。我的经验是:用n8n做系统集成和流程自动化,用Dify做AI Agent应用开发,用RAGFlow做深度文档理解。面试时能说出这五个平台的技术架构和定位差异,说明你做过真实的LLM应用选型,不是只看表面的功能列表。"
各平台与MCP的集成情况:
| 平台 | MCP支持 | 说明 |
|---|---|---|
| Dify | ✅ 原生MCP插件 | 从2025年开始支持 |
| n8n | ✅ 通过代码节点 | 需手动配置 |
| Coze | ⚠️ 部分支持 | 主要通过API集成 |
| FastGPT | ❌ 暂无 | 专注知识库 |
| RAGFlow | ❌ 暂无 | 专注RAG |
Q19: 什么是GraphRAG?与传统向量RAG相比有什么优势和局限?
🧠 图解记忆: 传统RAG只搜片段,GraphRAG建关系网——跨文档推理必须用图,简单问答没必要上图。
💡 答案要点
GraphRAG = Knowledge Graph + RAG,由微软提出(2024年9月发布)。它的核心思想是:纯向量检索只能做到"片段级相似",无法理解实体间关系。GraphRAG通过构建知识图谱来解决这个问题。
为什么需要GraphRAG?
| 问题 | 传统向量RAG | GraphRAG |
|---|---|---|
| 跨文档关联推理 | ❌ 搜索碎片化,答案片面 | ✅ 沿图谱游走找到多跳路径 |
| 全局总结性查询 | ❌ 无法回答"整体怎么看" | ✅ 社区摘要聚合形成全景 |
| 复杂实体关系问答 | ❌ 语义匹配不够精确 | ✅ 显式表达实体+关系 |
| 相同词汇不同含义 | ❌ 同名同义词混淆 | ✅ 通过实体消歧解决 |
GraphRAG的五大生产痛点:
1. 构建成本极高 → 每个分块都需要LLM调用提取实体/关系,百万级文档成本巨大
2. 增量更新困难 → 新增文档不只是追加,可能需要重新做社区检测、重新生成摘要
3. 实时性差 → 每次更新都要触发完整的图谱重建流程
4. 调试困难 → 当答案错误时,很难定位是图谱构建阶段还是检索阶段的问题
5. 不一定更优 → 对于单文档问答、常识性问题,传统RAG可能更好、更快、更便宜
适用场景判断:
| 适合 GraphRAG | 不适合 GraphRAG |
|---|---|
| 需要跨文档综合回答 | 单文档问答 |
| 实体关系查询(谁跟谁有关) | 事实查询(某个具体值) |
| 全球综述类问题("整体趋势怎样") | 精确数值查询 |
| 法律/金融分析场景 | 快速原型验证 |
| 大规模企业知识库(>10万篇文档) | 中小规模知识库(<1万篇) |
面试话术:
"GraphRAG的核心创新是引入了知识图谱结构来弥补向量检索的碎片化问题。但在实际项目中我不会盲目上GraphRAG——先看查询类型:如果主要是实体关系查询和全局总结,值得投入;如果是简单的事实查询,传统RAG加混合检索效果更好且成本低得多。我的评估标准是:当需要跨多篇文档综合回答时才引入知识图谱。"
Q20: Self-RAG是什么?自适应检索如何解决传统RAG的固定检索问题?
🧠 图解记忆: 传统RAG不管需不需要都去查,Self-RAG让模型自己决定要不要查、查得够不够、答得对不对。
💡 答案要点
Self-RAG核心理念: 传统RAG对每个查询都做固定数量的检索,但有些问题根本不需要检索(常识性问题),有些需要多次检索。Self-RAG训练一个统一的模型,让它能够:(1) 自主决定是否检索;(2) 评估检索结果的相关性;(3) 验证生成的内容。
四大反射Token机制:
| Token | 含义 | 作用 |
|---|---|---|
| `< | Retrieve> | ` |
| `< | IsRel> | ` |
| `< | IsSup> | ` |
| `< | IsUse> | ` |
自适应检索的三种模式:
# 模式1:阈值驱动
if P(Retrieve) > threshold:
    documents = retriever.search(query)
else:
    # 直接生成,跳过检索
    answer = model.generate(query)

# 模式2:迭代优化(多轮检索)
retrieved_docs = []
for i in range(max_iterations):
    docs = retriever.search(query + current_context)
    relevance_scores = evaluate_relevance(docs)
    retrieved_docs.extend(filter_high_relevance(docs, relevance_scores))
    if all_high_quality(relevance_scores):
        break  # 早停

# 模式3:基于生成的树解码
candidates = tree_decode(model, query, top_k=5)
best_answer = max(candidates, key=score_fn)
与传统Pipeline-RAG对比:
| 维度 | Pipeline-RAG | Self-RAG |
|---|---|---|
| 检索策略 | 固定检索k个文档 | 自适应,可0~N次检索 |
| 结果评估 | 通常不做二次过滤 | 逐段相关性评分 |
| 生成验证 | 无 | 逐句有据性验证 |
| 可控性 | 低(一旦入管道就无法干预) | 高(可调整各种token阈值) |
| 延迟 | 较低(固定链路) | 较高(条件分支+多次LLM调用) |
面试话术:
"Self-RAG的本质是让检索从'被动执行'变成'主动决策'。在工业界,我发现大约30-50%的用户查询根本不需要检索(自我介绍、闲聊等),强制检索反而浪费资源、增加幻觉风险。Self-RAG的反射token机制让模型学会判断'什么时候不检索就是最好的检索策略'。不过自部署难度较高,因为需要专门的数据标注和模型训练。"
Q21: RAG系统上线后怎么评估效果?RAGAS vs TruLens vs DeepEval 怎么选?
🧠 图解记忆: RAG不能只用一个"准确率"衡量——检索查准率、召回率、回答忠实度各看各的,缺一不可。
💡 答案要点
RAG的三个独立失败面:
- 检索质量:有没有把对的文档捞出来?
- 回答忠实度:生成的答案有没有脱离上下文瞎编?
- 答案相关性:回答到底有没有解决问题?
这四个RAGAS核心指标各有侧重,缺一不可:
| 指标 | 维度 | 定义 | 典型阈值 | 低了意味着什么 |
|---|---|---|---|---|
| Context Precision | 检索 | 被召回的文档中有多少是真正相关的 | >0.7 | 检索器引入噪声 |
| Context Recall | 检索 | 回答问题所需的信息是否都被召回了 | >0.6 | 检索范围不够 |
| Faithfulness | 生成 | 答案中的每句话是否都能追溯到上下文中 | >0.8 | 模型有幻觉 |
| Answer Relevancy | 生成 | 答案是否直接回答了原始问题 | >0.7 | 答案跑题 |
三大框架选型对比:
| 特性 | RAGAS | TruLens | DeepEval |
|---|---|---|---|
| 定位 | 纯评估指标库 | 评估+可观测性平台 | 测试框架+指标 |
| 实时追踪 | ❌ 离线批处理 | ✅ Live tracing | ⚠️ 有限支持 |
| 参考依赖 | 无需ground truth(faithfulness等) | 需要trace数据 | 推荐有参考 |
| Dashboard | ❌ | ✅ Web UI | ❌ |
| CI集成 | ✅ Python API | ✅ SDK | ✅ pytest插件 |
| 免费程度 | Apache 2.0全开源 | 开源+Pro版 | 核心开源+付费 |
| 最佳场景 | CI回归测试、批量评估 | 实时监控、线上诊断 | TDD-style测试 |
代码示例:RAGAS评估管线
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_precision, context_recall
import pandas as pd

# 构建评估数据集(需要question/context/ground_truth/answer四个字段)
data_sample = {
    "question": ["公司的现金流状况如何?", "主要竞争对手是谁?"],
    "ground_truth": ["2024年Q3现金流为负,主因是研发投入增加", "主要竞争对手是A公司和B公司"],
    "answer": [model.generate(q) for q in dataset["question"]],
}

dataset = Dataset.from_dict(data_sample)

result = evaluate(
    dataset=dataset,
    metrics=[faithfulness, answer_relevancy, context_precision, context_recall],
    llm=judge_llm,
    embeddings=embedding_model,
)
print(result.to_pandas())
面试话术:
"评价RAG效果我从来不只看一个准确率分数,而是拆成四层:检索查准率(context precision)、检索召回率(context recall)、回答忠实度(faithfulness)、答案相关性(answer relevancy)。CI里跑RAGAS做回归测试,线上用TruLens做实时监控。如果看到faithfulness掉了但precision没变,说明是Prompt或模型的问题,不是检索的问题——这种分层排查思路比拍脑袋改配置强太多了。"
Q22: RLHF和DPO有什么区别?2026年主流对齐方法还有哪些演进?
🧠 图解记忆: RLHF三件套(reward model/PPO/refine),DPO一步到位——不训reward model直接优化策略。
💡 答案要点
RLHF的标准流程(三层架构):
步骤1:收集人类偏好数据
  → 对同一prompt的不同回答排序 → 得到 (chosen, rejected) 偏好对

步骤2:训练 Reward Model (RM)
  → 给定prompt+response,输出一个标量得分
  → 目标:chosen得分 > rejected得分

步骤3:用PPO微调LLM
  → 以Reward Model给出的奖励作为信号
  → 约束:不要偏离预训练模型太远(KL惩罚)
DPO(Direct Preference Optimization)的革命性简化:
DPO的关键洞察:PPO优化等价于直接优化策略模型,绕过了reward model。
RLHF:  preference data → Train RM → PPO optimize policy (两阶段、不稳定)
DPO:   preference data → Directly optimize policy (单阶段、稳定)
DPO vs RLHF对比:
| 维度 | RLHF (PPO) | DPO |
|---|---|---|
| 训练阶段 | 两步(训RM + PPO) | 一步(直接优化policy) |
| 稳定性 | PPO超参敏感,常崩溃 | 训练稳定,类似SFT |
| 算力需求 | 高(需要额外存RM) | 低(不需要RM) |
| 实现复杂度 | 高(TRL + Ray) | 低(标准PyTorch即可) |
| 效果上限 | 理论上更高 | 接近RLHF但略低 |
| 工业落地 | OpenAI早期做法 | 多数现代模型的默认选择 |
2026年前沿对齐方法:
| 方法 | 全称 | 关键创新 | 代表 |
|---|---|---|---|
| GRPO | Group Relative Policy Optimization | 用group内相对排名替代绝对reward,无需RM | DeepSeek R1 |
| DAPO | Dynamic Augmented DPO | DPO基础上引入动态数据增强 | 阿里 |
| GSPO | Guidance-guided SPO | 用辅助指导信号引导策略优化 | Meta |
| IPO | Identity Regularized Preference Optimization | 理论推导的DPO正则化版本 | 学术 |
| KTO | Kahneman-Tversky Optimization | 不用成对偏好数据,只需要好坏标签 | Meta |
面试话术:
"2026年做模型对齐,DPO已经成为工业界的默认选择。RLHF虽然效果好,但PPO的训练不稳定性和RM训练成本太高。DeepSeek R1用的GRPO更进一步——连reward model都不需要,直接用组内相对比较来引导优化。面试时如果能说出'DPO把三件套简化为一件'这个类比,同时知道GRPO的相对排名思想,说明你对齐领域不仅会用还会思考。"
Q23: MoE(Mixture of Experts)如何在不增加推理成本的情况下扩大模型规模?
🧠 图解记忆: Dense模型每个token过全部参数,MoE只让top-k专家工作——总参暴涨、激活不变。
💡 答案要点
MoE的核心公式:激活参数 ≠ 总参数
在Dense Transformer中,每个token经过所有FFN层的参数。在MoE中:
Dense:    FLOPs ∝ N_total(所有参数都参与计算)
Sparse MOE: FLOPs ∝ N_active(只有top-k专家参与计算)
以Mixtral 8x7B为例:总参56B,但每token只激活2个专家×7B=14B。用4倍容量换来几乎相同的推理成本。
MoE三大核心组件:
| 组件 | 职责 | 关键技术点 |
|---|---|---|
| Router/Gate | 决定token分配给哪个专家 | Softmax vs Top-K路由,负载均衡loss |
| Experts | 实际的FFN子网络 | 独立参数矩阵,学习不同知识 |
| Load Balancing | 防止某些专家过载或空闲 | Auxiliary loss, Expert bias, Capacity factor |
DeepSeek-V3的MoE设计(2026面试最热话题):
普通MoE:     8 experts, token选Top-1
Fine-grained: 256 experts + 1 shared expert, token选Top-4
              总参: 671B, 激活参: 37B (比例 18x!)

Shared Expert: 给所有token提供通用知识基础
                ↓
Fine-grained:  细粒度专家处理特定领域的token
                ↓
Routing:       Expert Bias在线更新(不再用aux loss干扰梯度)
MoE的工程挑战:
- All-to-All通信:token分发和聚合需要跨GPU通信,成为瓶颈
- 负载均衡:需要专门的load balancing strategy,否则专家会两极分化
- Capacity Factor:限制每个GPU接收的token数,溢出token需要丢弃或重复发送
- Expert Parallelism:第4维并行方式,需要all-to-all NCCL通信
面试话术:
"MoE的本质是'用稀疏换容量'——总参数量可以很大,但每次推理只激活一小部分。2026年的主流大模型基本都用MoE了(DeepSeek R1、Mixtral、Qwen3),面试必问。关键是说清楚三点:1)为什么总参≠激活参;2)如何保证负载均衡(aux loss或expert bias);3)工程上all-to-all通信是最大瓶颈。能聊到DeepSeek-V3的fine-grained experts和shared experts,面试官会觉得你跟进得很深。"