🎨 多模态大模型面试题
面试优先顺序(通用 AI 应用开发岗位):Q1、Q2、Q3、Q7、Q8、Q9、Q10、Q14、Q15。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
难度: ⭐⭐⭐⭐ 更新: 2026-04-15 考点: CLIP、BLIP、多模态理解、图文生成、Gemma 4、端侧部署
📋 目录
一、多模态基础
Q1: 什么是多模态学习?为什么重要?
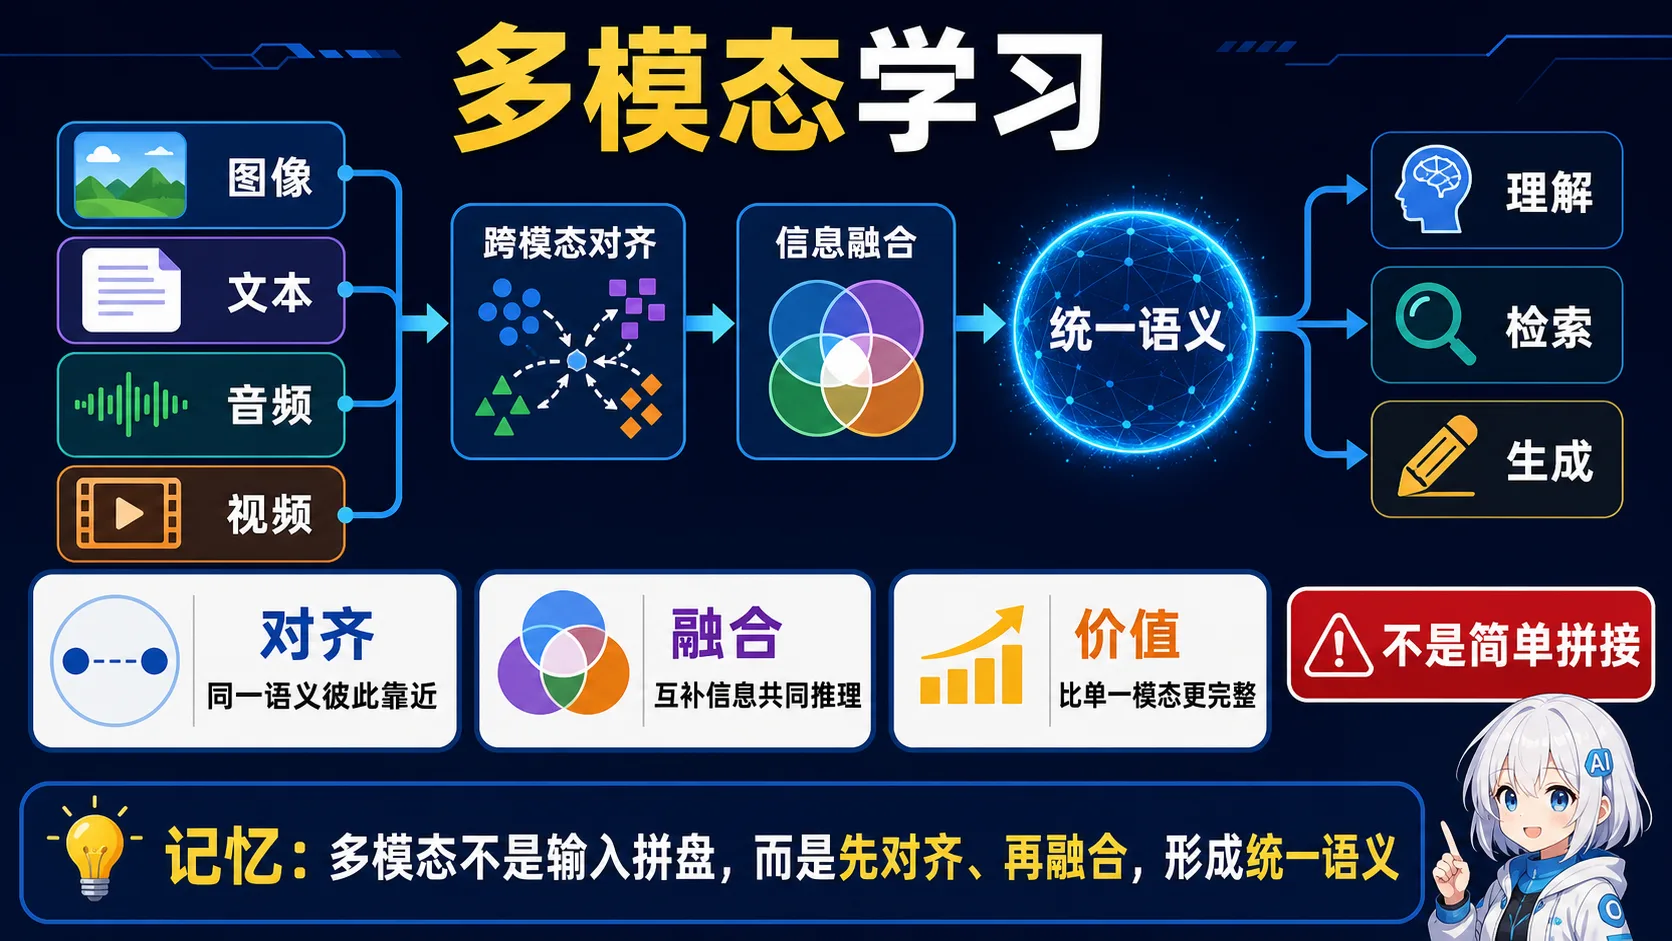
🧠 图解记忆:多模态的价值不在于简单叠加输入,而在于把不同感官信号对齐到统一语义后完成理解、检索与生成;点击图片可查看原图。
💡 答案要点
多模态学习 = 让模型同时理解多种数据类型(图像、文本、音频、视频)
单模态 vs 多模态:
| 模态 | 单模态 | 多模态 |
|---|---|---|
| 文本 | GPT:只看文字 | GPT-4V:看图+文字 |
| 图像 | ResNet:只看图 | CLIP:图+文字对齐 |
| 音频 | Whisper:只听声音 | AudioLM:声音+文字 |
为什么需要多模态?
更丰富的理解
单模态:
看图 → "一个动物"
看文字 → "猫的特征"

多模态:
看图+文字 → "这是一只橘猫,正在睡觉"
跨模态检索
文本检索图片:
输入:"夕阳下的海滩"
输出:相关图片

图片检索文本:
输入:一张海滩照片
输出:"这是美丽的夕阳海滩..."
生成任务
看图说话(Image Captioning)
文生图(Text-to-Image)
视频理解(Video QA)
多模态的挑战:
| 挑战 | 说明 | 解决方案 |
|---|---|---|
| 模态对齐 | 图像和文本如何关联? | 对比学习(CLIP) |
| 模态融合 | 如何结合不同模态? | 交叉注意力(BLIP) |
| 数据获取 | 图文对数据标注成本高 | 网络爬取(LAION) |
| 计算成本 | 多模态模型参数量大 | 模型压缩、蒸馏 |
主流多模态任务:
多模态学习
├── 理解任务
│   ├── 图像字幕(Image Captioning)
│   ├── 视觉问答(VQA)
│   ├── 视觉推理(Visual Reasoning)
│   └── 跨模态检索(Cross-Modal Retrieval)
│
└── 生成任务
    ├── 文生图(Text-to-Image)
    ├── 图生文(Image-to-Text)
    ├── 视频生成(Video Generation)
    └── 音频生成(Audio Generation)
面试话术:
"多模态学习让 AI 像人一样,能同时看、听、读。单模态是盲人摸象,多模态才能全面理解。CLIP 用对比学习对齐图文,GPT-4V 能看图回答问题。"
Q2: 如何评估多模态模型的性能?
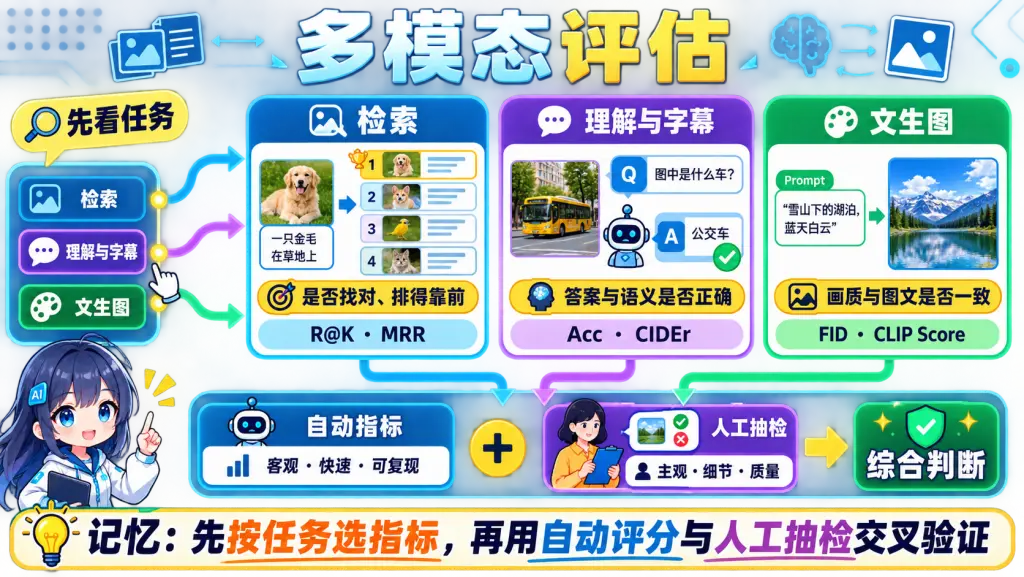
🧠 图解记忆:多模态模型没有一个万能分数,检索看排序召回、理解看答案正确性、生成同时看质量与跨模态对齐;点击图片可查看原图。
💡 答案要点
评估维度:
1. 跨模态检索(Image-Text Retrieval):
| 指标 | 说明 | 计算方式 |
|---|---|---|
| R@1 | Top-1 召回率 | 正确结果在第1位的比例 |
| R@5 | Top-5 召回率 | 正确结果在前5位的比例 |
| R@10 | Top-10 召回率 | 正确结果在前10位的比例 |
示例(Flickr30K):
任务:给定图片,从 1000 个候选文本中找出匹配的

CLIP 结果:
  R@1 = 88.0%(第1位就找对)
  R@5 = 98.7%(前5位能找对)
  R@10 = 99.4%(前10位能找对)
2. 视觉问答(VQA):
| 指标 | 说明 |
|---|---|
| 准确率 | 答案完全匹配的比例 |
| CIDEr | 与人类答案的相似度 |
3. 图像字幕(Image Captioning):
| 指标 | 说明 | 范围 |
|---|---|---|
| BLEU | n-gram 重叠度 | 0-1 |
| METEOR | 考虑同义词的匹配 | 0-1 |
| CIDEr | 共识度量 | 0-10 |
| SPICE | 语义匹配 | 0-1 |
4. 文生图(Text-to-Image):
| 指标 | 说明 |
|---|---|
| FID | 生成图像与真实图像的分布距离(越小越好) |
| CLIP Score | 生成图像与文本的匹配度 |
| 人工评分 | 专家打分(质量、相关性) |
综合评估(COCO Benchmark):
| 模型 | VQA Acc | Caption CIDEr | Retrieval R@1 |
|---|---|---|---|
| CLIP | - | - | 58.4% |
| BLIP | 78.3% | 136.7 | 82.3% |
| BLIP-2 | 82.4% | 144.5 | 85.9% |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "多模态评估要看多个维度。检索任务看 R@K,问答看准确率,字幕看 CIDEr。我在项目中用 CLIP Score 评估文生图质量,结合人工抽检确保效果。"
二、CLIP模型
Q3: CLIP 的核心思想是什么?如何训练?
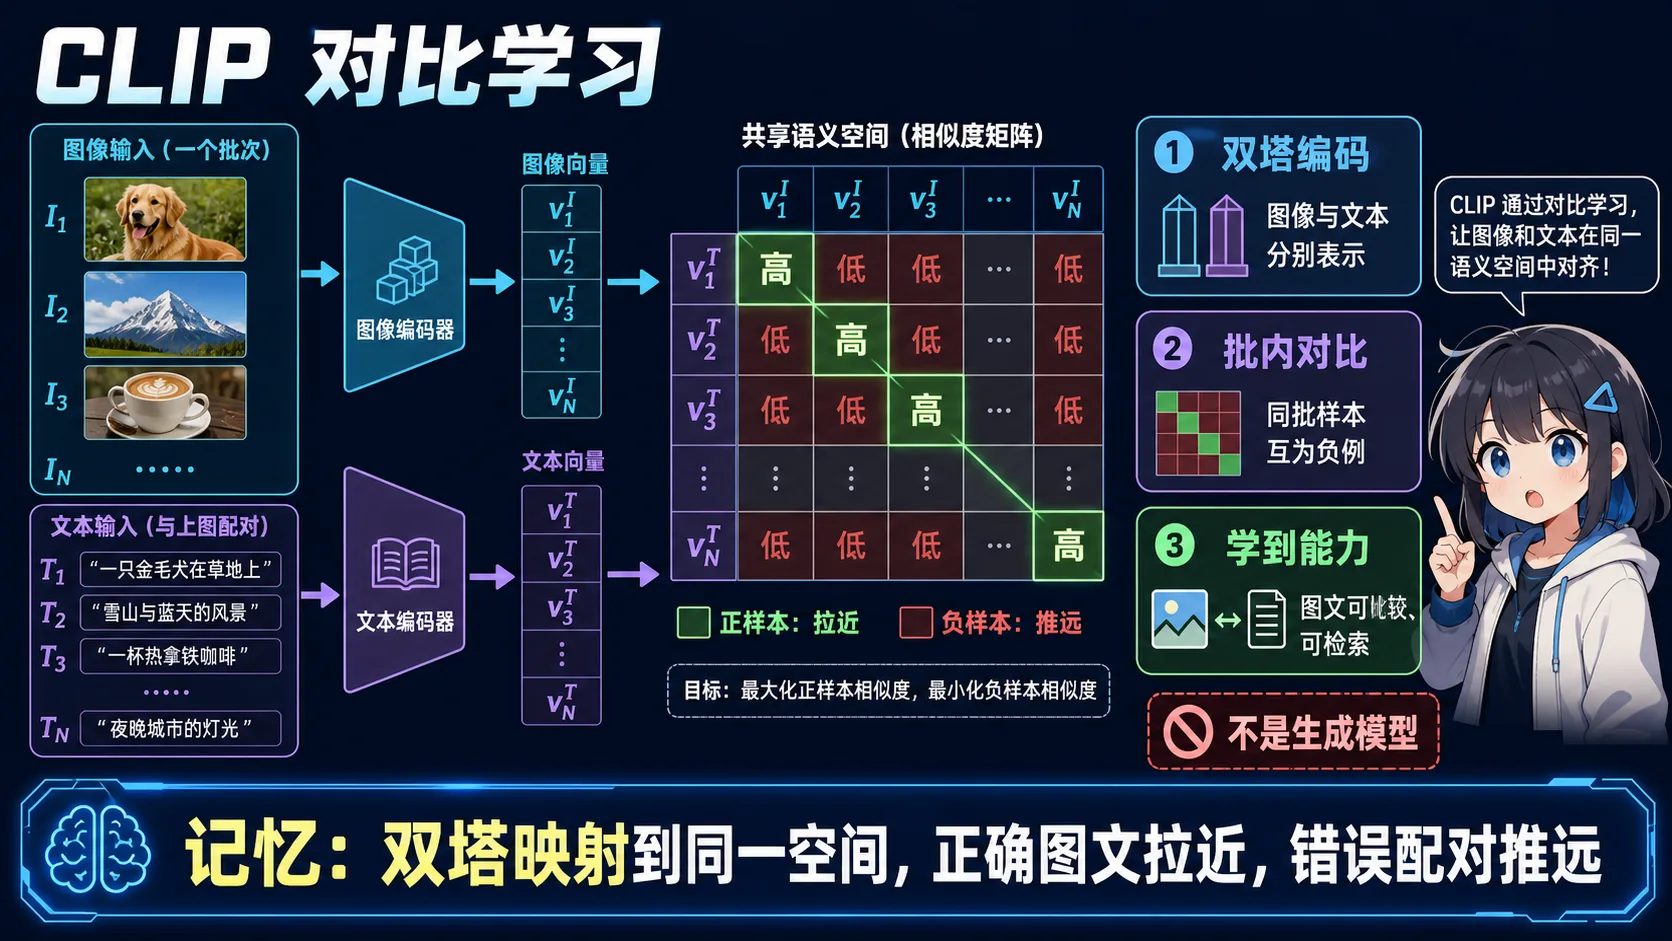
🧠 图解记忆:CLIP 用图文双塔把两种模态映射到共享空间,通过批内对比学习拉近正确配对、推远错误配对;点击图片可查看原图。
💡 答案要点
CLIP = Contrastive Language-Image Pre-training(对比语言-图像预训练)
核心思想: 用对比学习将图像和文本映射到同一个语义空间
架构:
┌─────────────────────────────────────────────────────────┐
│                     CLIP 架构                            │
└─────────────────────────────────────────────────────────┘

图像编码器(Image Encoder)
  ├── Vision Transformer (ViT)
  └── 或 ResNet
  输出:图像向量 v ∈ R^512

文本编码器(Text Encoder)
  ├── Transformer
  输出:文本向量 t ∈ R^512

对比学习(Contrastive Learning)
  目标:匹配的图文对相似度高,不匹配的低
训练过程:
1. 数据准备(4 亿图文对):
图片1: 一只猫在睡觉.jpg
文本1: "A cat is sleeping"

图片2: 一辆红色汽车.jpg
文本2: "A red car"

...
2. 对比损失(Contrastive Loss):
# 批量(N=32768)
images = [img1, img2, ..., imgN]
texts = [text1, text2, ..., textN]

# 编码
I = image_encoder(images)  # N × 512
T = text_encoder(texts)     # N × 512

# 归一化
I = I / ||I||
T = T / ||T||

# 相似度矩阵
S = I @ T.T  # N × N

# 对比损失
正样本:对角线(img1 vs text1, img2 vs text2, ...)
负样本:非对角线(img1 vs text2, img1 vs text3, ...)

目标:
  对角线相似度尽量高(接近1)
  非对角线相似度尽量低(接近0)

损失函数:
  L = -1/N Σ [log(exp(S_ii) / Σ_j exp(S_ij))]
  (让正样本概率最大)
3. 对称损失(双向):
图像→文本:给定图像,找匹配文本
文本→图像:给定文本,找匹配图像

总损失 = 图像→文本损失 + 文本→图像损失
训练细节:
| 参数 | 值 | 说明 |
|---|---|---|
| 数据量 | 4亿图文对 | LAION-400M |
| Batch Size | 32768 | 超大 batch |
| 负样本数 | 32767 | 同 batch 其他样本 |
| 训练时间 | ~12天 | 256 GPUs |
| 学习率 | 5e-4 |
推理(Zero-shot 分类):
# 候选类别
classes = ["猫", "狗", "鸟", "车"]

# 构造提示词
prompts = [f"a photo of a {c}" for c in classes]
# ["a photo of a 猫", "a photo of a 狗", ...]

# 编码
image_features = clip.encode_image(image)  # 1 × 512
text_features = clip.encode_text(prompts)  # 4 × 512

# 相似度
similarity = image_features @ text_features.T  # 1 × 4
# [0.8, 0.1, 0.05, 0.05]

# 预测
prediction = classes[similarity.argmax()]  # "猫"
CLIP 的优势:
| 优势 | 说明 |
|---|---|
| Zero-shot | 不需要训练,直接分类任意类别 |
| 通用性 | 适用于各种视觉任务 |
| 鲁棒性 | 对分布偏移(domain shift)不敏感 |
局限性:
| 局限 | 说明 | 示例 |
|---|---|---|
| 细粒度分类差 | 难区分相似物体 | 猫的品种识别 |
| OCR 能力弱 | 不擅长读图中文字 | 识别车牌号 |
| 不能生成 | 只能检索,不能生成字幕 | - |
面试话术:
"CLIP 用对比学习把图像和文本拉到同一空间。一个 batch 有 32K 样本,每个样本都是 32K-1 个负样本。这让 CLIP 学会了强大的图文对齐能力,Zero-shot 分类超越很多有监督模型。"
Q4: CLIP 如何做 Zero-shot 分类?为什么效果好?
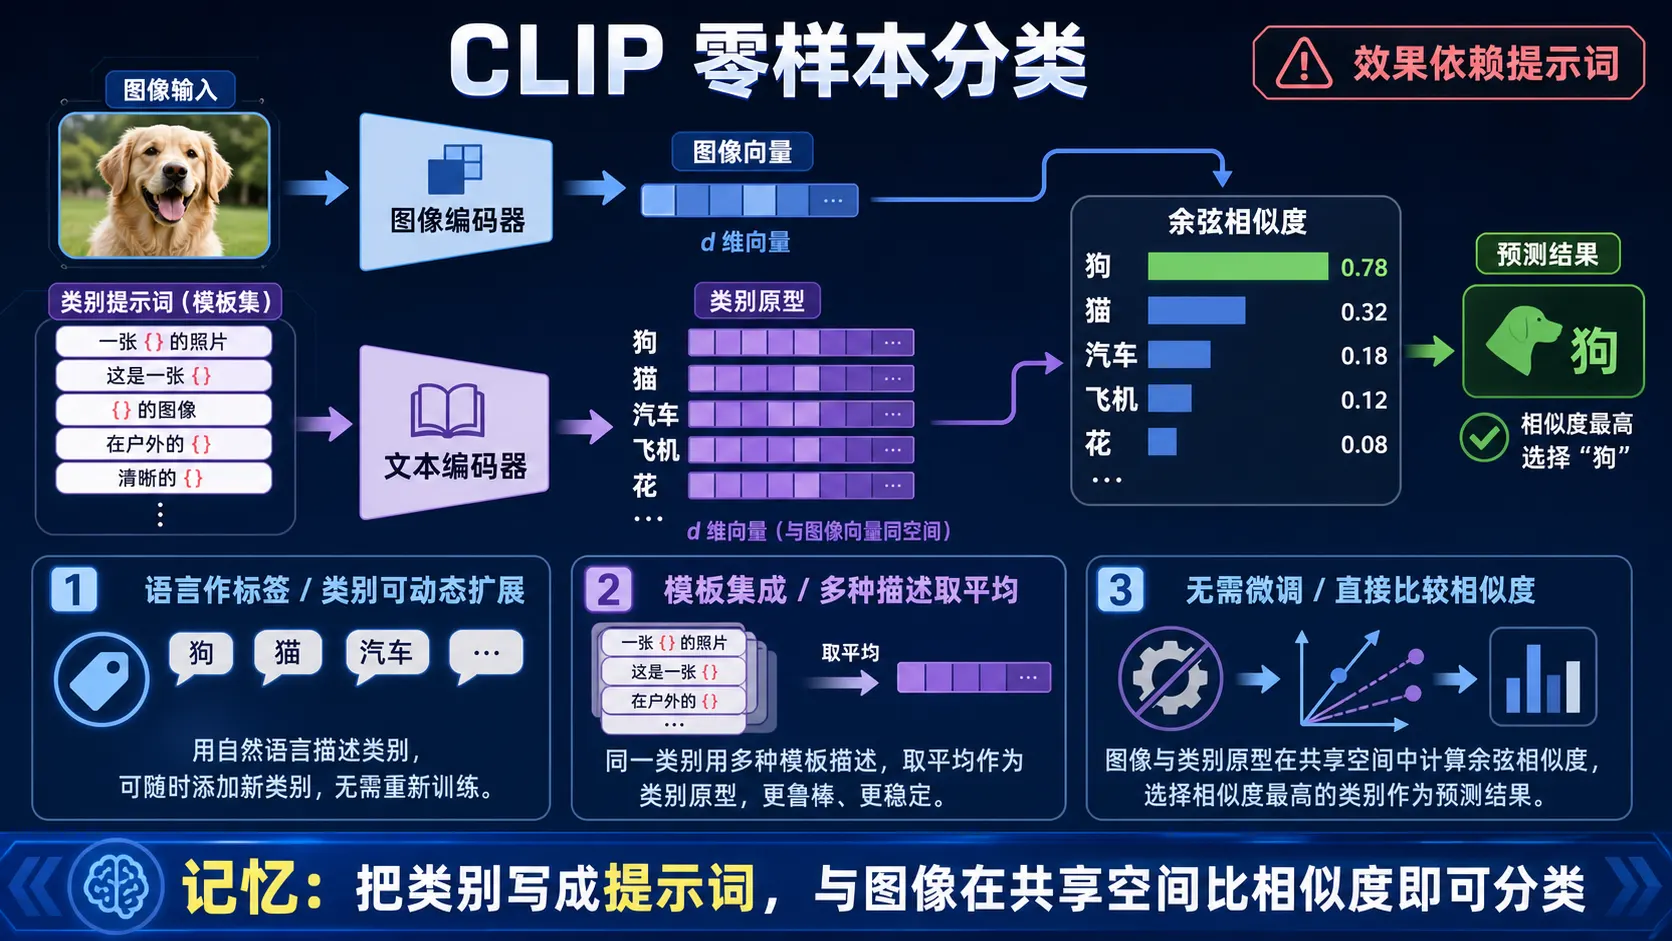
🧠 图解记忆:CLIP 把类别名称包装成提示词并编码为类别原型,再与图像向量比较相似度,因此能在不做任务微调的情况下分类新类别;点击图片可查看原图。
💡 答案要点
Zero-shot = 不需要训练,直接分类没见过的类别
CLIP 的 Zero-shot 流程:
1. 构造提示词模板(Prompt Engineering):
# 基础模板
template = "a photo of a {class}"

# 改进模板(效果更好)
templates = [
    "a photo of a {class}",
    "a photo of a large {class}",
    "a photo of a small {class}",
    "a photo of the {class}",
    # ... 共 80 个模板
]

# 示例
class_name = "cat"
prompts = [t.format(class=class_name) for t in templates]
# ["a photo of a cat", "a photo of a large cat", ...]
2. 编码文本和图像:
# 对所有类别生成提示词
all_prompts = []
for class_name in class_names:
    for template in templates:
        all_prompts.append(template.format(class=class_name))

# 编码提示词(批量)
text_features = clip.encode_text(all_prompts)  # N_class × N_template × 512

# 平均多个模板(ensemble)
text_features = text_features.mean(dim=1)  # N_class × 512

# 编码图像
image_features = clip.encode_image(image)  # 1 × 512

# 归一化
image_features = image_features / ||image_features||
text_features = text_features / ||text_features||
3. 计算相似度并分类:
# 余弦相似度
similarity = image_features @ text_features.T  # 1 × N_class

# Softmax(转概率)
probabilities = softmax(similarity * temperature)

# 预测
prediction = class_names[probabilities.argmax()]
为什么 Zero-shot 效果好?
1. 海量数据学习语义:
训练数据:4 亿图文对
覆盖类别:数百万种物体、场景、动作

结果:
  CLIP 见过大量"猫"的图片和描述
  即使没在特定数据集上训练,也能识别猫
2. 语言作为桥梁:
传统 CV 模型:
  训练:看 1000 个类别的图片
  测试:只能识别这 1000 类

CLIP:
  训练:学习图文对齐
  测试:给任何文本描述,都能找对应图片

示例:
  训练时没见过"金毛犬"
  但见过"狗"、"金色"、"毛茸茸"
  → 能推理出"金毛犬"
3. 提示词工程放大效果:
单模板:
  "a photo of a cat"
  准确率:76.2%

多模板(80个):
  "a photo of a cat"
  "a photo of a large cat"
  ...
  准确率:82.7%(+6.5%)
实测性能(ImageNet):
| 模型 | 训练数据 | Zero-shot | Few-shot(16样本) |
|---|---|---|---|
| ResNet-50 | ImageNet | 0% | 56.4% |
| CLIP ViT-B/32 | 4亿图文对 | 68.3% | 82.7% |
| CLIP ViT-L/14 | 4亿图文对 | 76.2% | 88.9% |
面试话术:
"CLIP 的 Zero-shot 本质是用语言知识迁移到视觉。通过对比学习,CLIP 学会了图文语义对齐。给任何文本描述,都能找到匹配的图像,不需要额外训练。多模板 ensemble 能进一步提升 5-10%。"
三、BLIP模型
Q5: BLIP 和 CLIP 有什么区别?为什么需要 BLIP?
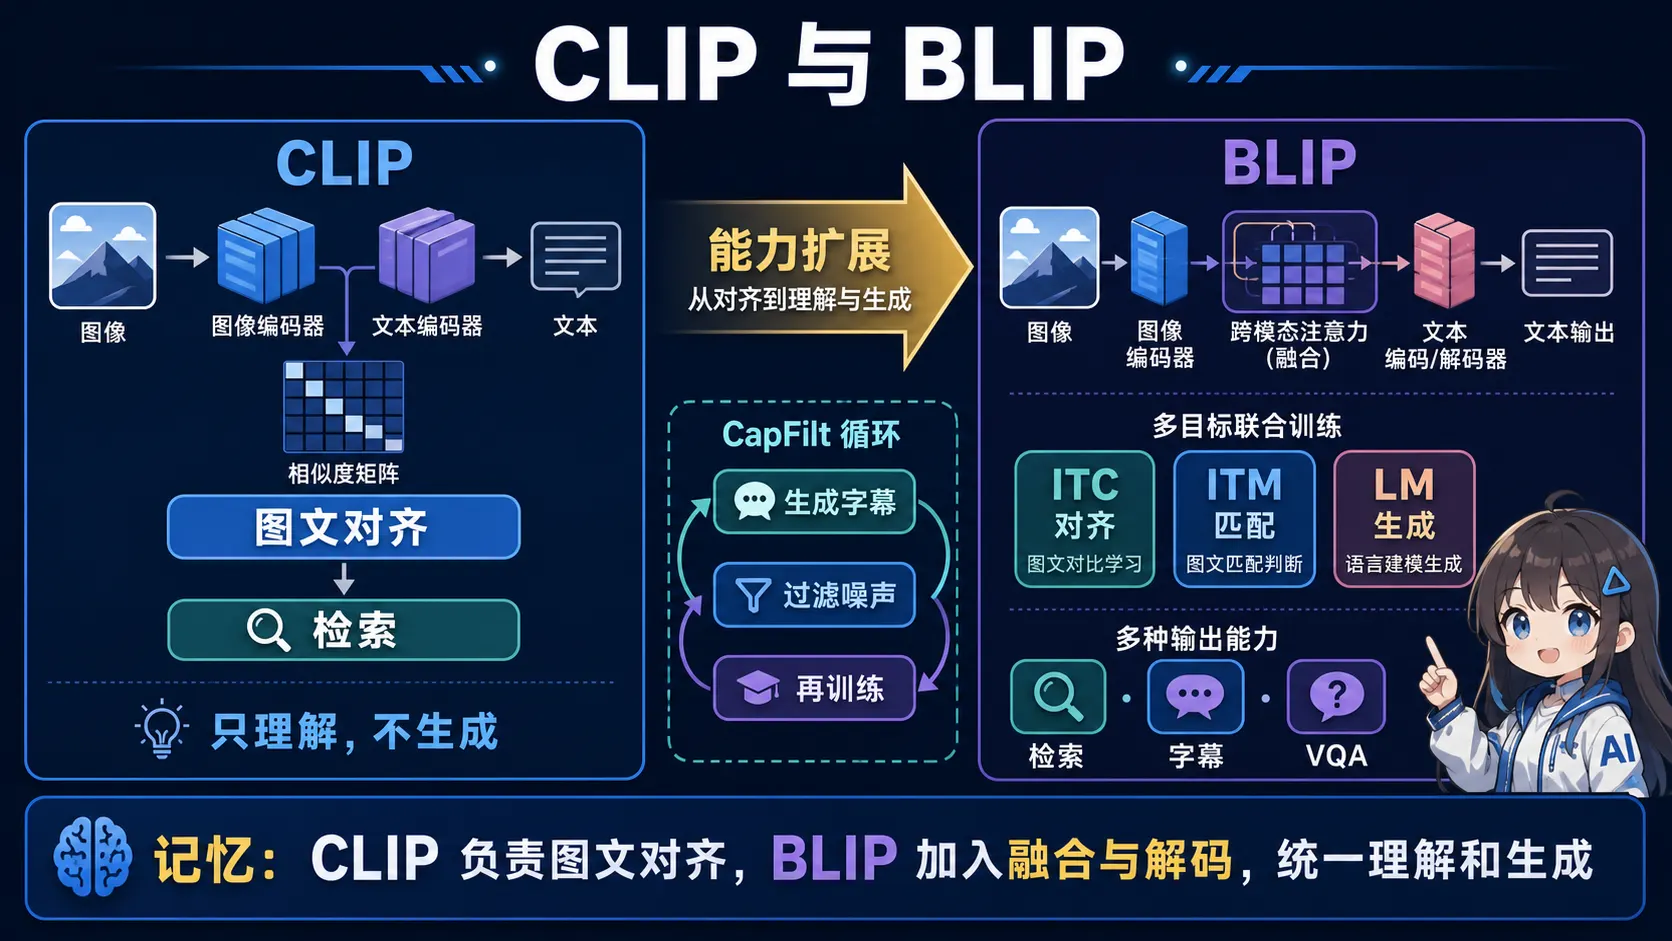
🧠 图解记忆:CLIP 的双编码器擅长图文对齐但不能生成,BLIP 通过 ITC、ITM、LM 联合训练和文本解码器统一了检索、字幕与视觉问答;点击图片可查看原图。
💡 答案要点
BLIP = Bootstrapped Language-Image Pre-training(自举语言-图像预训练)
核心区别:
| 维度 | CLIP | BLIP |
|---|---|---|
| 任务类型 | 只能理解(检索) | 理解 + 生成 |
| 训练目标 | 对比学习(ITC) | ITC + ITM + LM(三合一) |
| 架构 | 双编码器 | 编码器 + 解码器 |
| 能力 | 图文匹配 | 图文匹配 + 字幕生成 + VQA |
为什么需要 BLIP?
CLIP 的局限:
任务1:给图片找匹配文本 ✓
任务2:给图片生成字幕 ✗(不支持)
任务3:回答图片相关问题 ✗(不支持)

原因:
  CLIP 只有编码器,不能生成文本
BLIP 的能力:
任务1:图文检索 ✓(继承 CLIP)
任务2:图像字幕 ✓(新增)
任务3:视觉问答 ✓(新增)

实现:
  编码器:理解图像和文本
  解码器:生成文本
BLIP 架构:
┌─────────────────────────────────────────────────────────┐
│                     BLIP 架构                            │
└─────────────────────────────────────────────────────────┘

图像编码器(Image Encoder)
  ViT → 图像特征

文本编码器(Text Encoder)
  BERT → 文本特征(双向)

文本解码器(Text Decoder)
  GPT → 生成文本(单向)

多任务训练:
  1. ITC(Image-Text Contrastive):对比学习
  2. ITM(Image-Text Matching):二分类(匹配/不匹配)
  3. LM(Language Modeling):生成字幕
三个训练目标:
1. ITC(对比学习):
# 和 CLIP 一样
image_features = image_encoder(image)
text_features = text_encoder(text)
loss_itc = contrastive_loss(image_features, text_features)
2. ITM(匹配分类):
# 判断图文是否匹配
combined = cross_attention(image_features, text_features)
logits = classifier(combined)  # [匹配, 不匹配]
loss_itm = bce_loss(logits, label)

# 正样本:真实配对
# 负样本:随机配对
3. LM(生成字幕):
# 自回归生成
text_decoder_input = [image_features, caption_prefix]
generated_caption = text_decoder.generate(text_decoder_input)
loss_lm = cross_entropy_loss(generated_caption, target_caption)
BLIP 的创新:CapFilt(字幕过滤):
问题:
  网络爬取的图文对质量参差不齐
  很多文本描述不准确

BLIP 解决方案:
  1. 用 BLIP 模型生成新字幕(Caption)
  2. 用 BLIP 模型过滤低质量数据(Filter)
  3. 用清洗后的数据重新训练(Bootstrap)

流程:
  原始数据 → BLIP-Base 生成字幕
           → 过滤低质量样本
           → 清洗后数据
           → 训练 BLIP-Large

效果:
  数据质量提升 → 模型性能提升
性能对比(COCO):
| 模型 | 图像字幕(CIDEr) | 图文检索(R@1) | VQA准确率 |
|---|---|---|---|
| CLIP | - | 58.4% | - |
| ALBEF | 131.4 | 73.1% | 74.5% |
| BLIP | 136.7 | 82.3% | 78.3% |
面试话术:
"CLIP 是理解型模型,BLIP 是理解+生成型。BLIP 用三个训练目标(ITC+ITM+LM)统一了检索和生成任务。特别是 CapFilt 机制,用模型自己清洗数据,形成正反馈循环。"
Q6: BLIP-2 有什么改进?Q-Former 是什么?
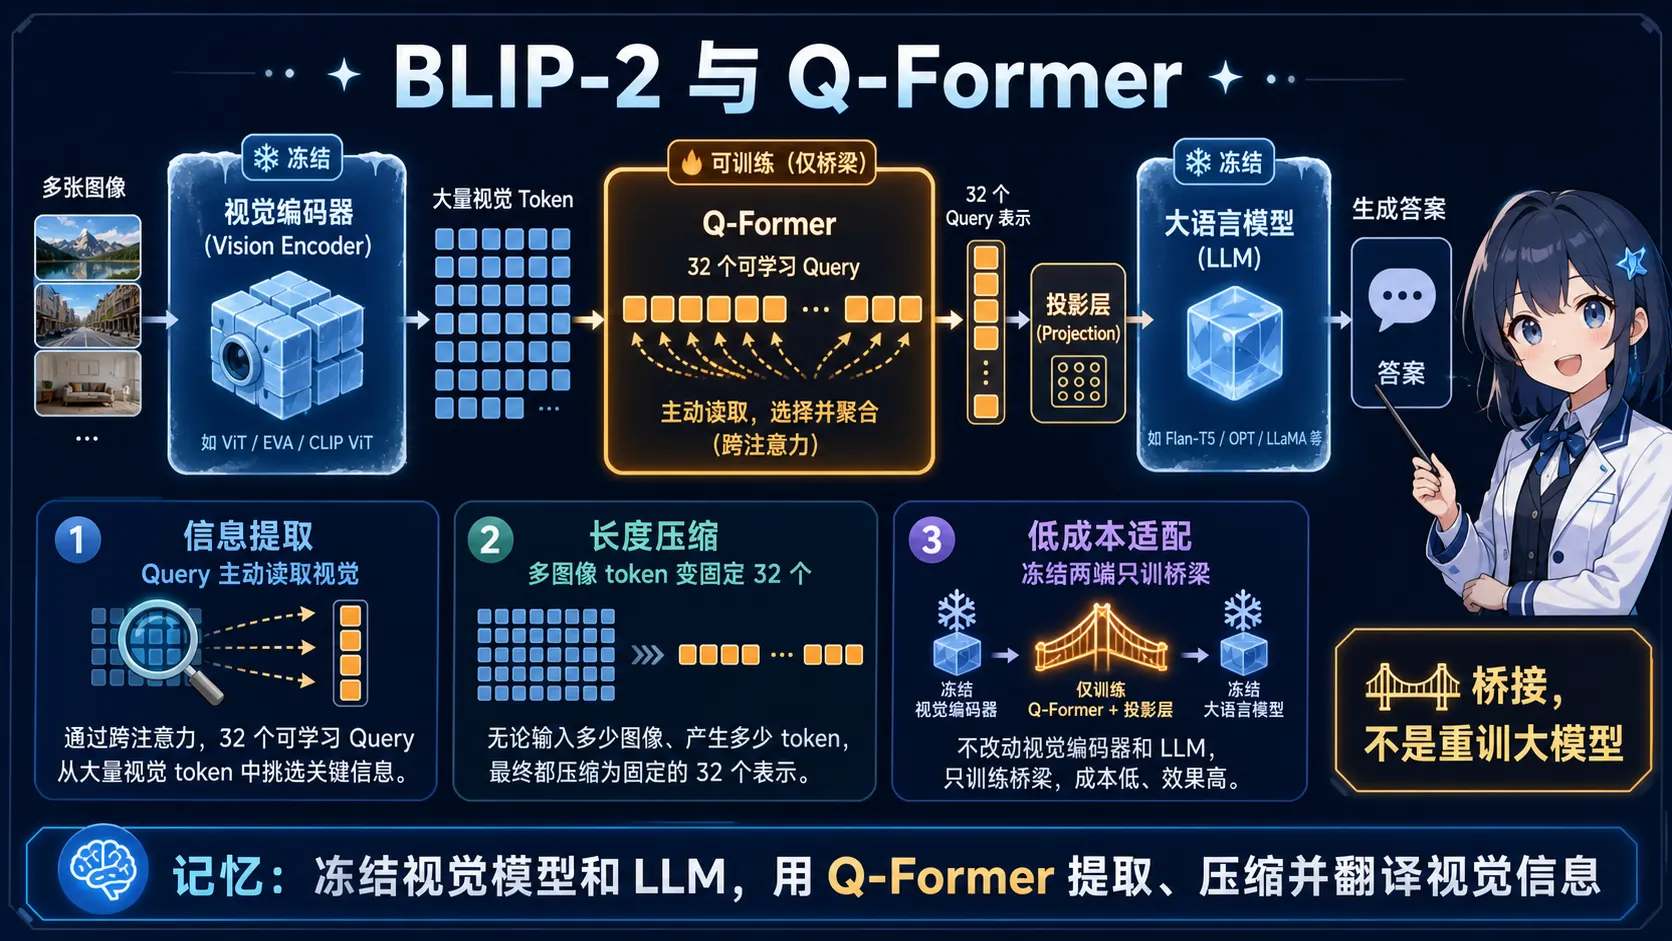
🧠 图解记忆:BLIP-2 不联合重训两个大模型,而是让 Q-Former 用固定数量的可学习 Query 提取和压缩视觉 token,再投影到冻结 LLM 的输入空间;点击图片可查看原图。
💡 答案要点
BLIP-2 = 用更少参数达到更好效果
核心创新:Q-Former(Query Transformer)
BLIP-2 的动机:
问题:
  BLIP 需要联合训练图像编码器和文本编码器
  → 参数量大(1B+)
  → 训练成本高
  → 难以利用已有的大语言模型(LLM)

目标:
  冻结视觉编码器(如 CLIP ViT)
  冻结语言模型(如 OPT、Flan-T5)
  只训练轻量级的连接层
Q-Former 架构:
┌─────────────────────────────────────────────────────────┐
│                    BLIP-2 架构                           │
└─────────────────────────────────────────────────────────┘

阶段1:视觉-语言表示学习
  冻结图像编码器(CLIP ViT-L)
      ↓
  Q-Former(32个可学习Query)
      ↓
  学习到的视觉表示

阶段2:视觉-语言生成学习
  Q-Former输出
      ↓
  线性层
      ↓
  冻结 LLM(OPT-2.7B / Flan-T5-XL)
      ↓
  生成回答
Q-Former 详解:
什么是 Q-Former?
# 本质:可学习的查询向量 + Transformer

learnable_queries = nn.Parameter(torch.randn(32, 768))
# 32 个查询向量,每个 768 维

# 处理流程
image_features = frozen_image_encoder(image)  # 257 × 1024

# Q-Former 提取信息
queries = learnable_queries.expand(batch_size, -1, -1)
output = q_former(queries, image_features)  # 32 × 768

# 输出:固定长度的视觉表示(32个向量)
为什么需要 Q-Former?
1. 降维压缩:
图像编码器输出:257 个 token × 1024 维 = 262K 维
Q-Former 输出:32 个 token × 768 维 = 24K 维

压缩比:10.9x
好处:
  - 减少 LLM 输入长度
  - 提升推理速度
  - 降低计算成本
2. 适配不同模态:
视觉特征(CLIP):连续、密集
语言特征(LLM):离散、稀疏

Q-Former 作用:
  把视觉特征转换为 LLM 友好的表示
3. 可学习的信息提取:
固定数量的 Query(32个)
每个 Query 学习提取特定类型的信息:
  Query 1:物体类别
  Query 2:空间位置
  Query 3:颜色
  ...

类似 DETR 的 Object Queries
两阶段训练:
阶段1:视觉-语言表示学习
# 目标:让 Q-Former 学会提取有用的视觉信息
# 损失:ITC + ITM + ITG(Image-Grounded Text Generation)

# 训练数据:图文对(1.29 亿)
# 冻结:图像编码器
# 训练:Q-Former
阶段2:视觉-语言生成学习
# 目标:让 LLM 理解视觉信息
# 损失:Language Modeling Loss

# 训练数据:指令数据(视觉问答、字幕生成)
# 冻结:图像编码器 + LLM
# 训练:Q-Former + 线性投影层
性能提升:
| 模型 | 参数量 | 训练数据 | VQA准确率 | COCO字幕(CIDEr) |
|---|---|---|---|---|
| BLIP | 224M | 1.29亿 | 78.3% | 136.7 |
| Flamingo-80B | 80B | 20亿 | 82.0% | 138.1 |
| BLIP-2 | 188M | 1.29亿 | 82.4% | 144.5 |
关键优势:
BLIP-2(188M)> Flamingo(80B)
  - 参数少 400 倍
  - 效果更好
  - 训练更快
面试话术:
"BLIP-2 的核心是 Q-Former,用 32 个可学习 Query 提取视觉信息。冻结视觉编码器和 LLM,只训练 Q-Former,参数量从 1B 降到 188M,效果反而更好。这证明了模态适配比联合训练更重要。"
四、应用实战
Q7: 如何用多模态模型做图文检索系统?
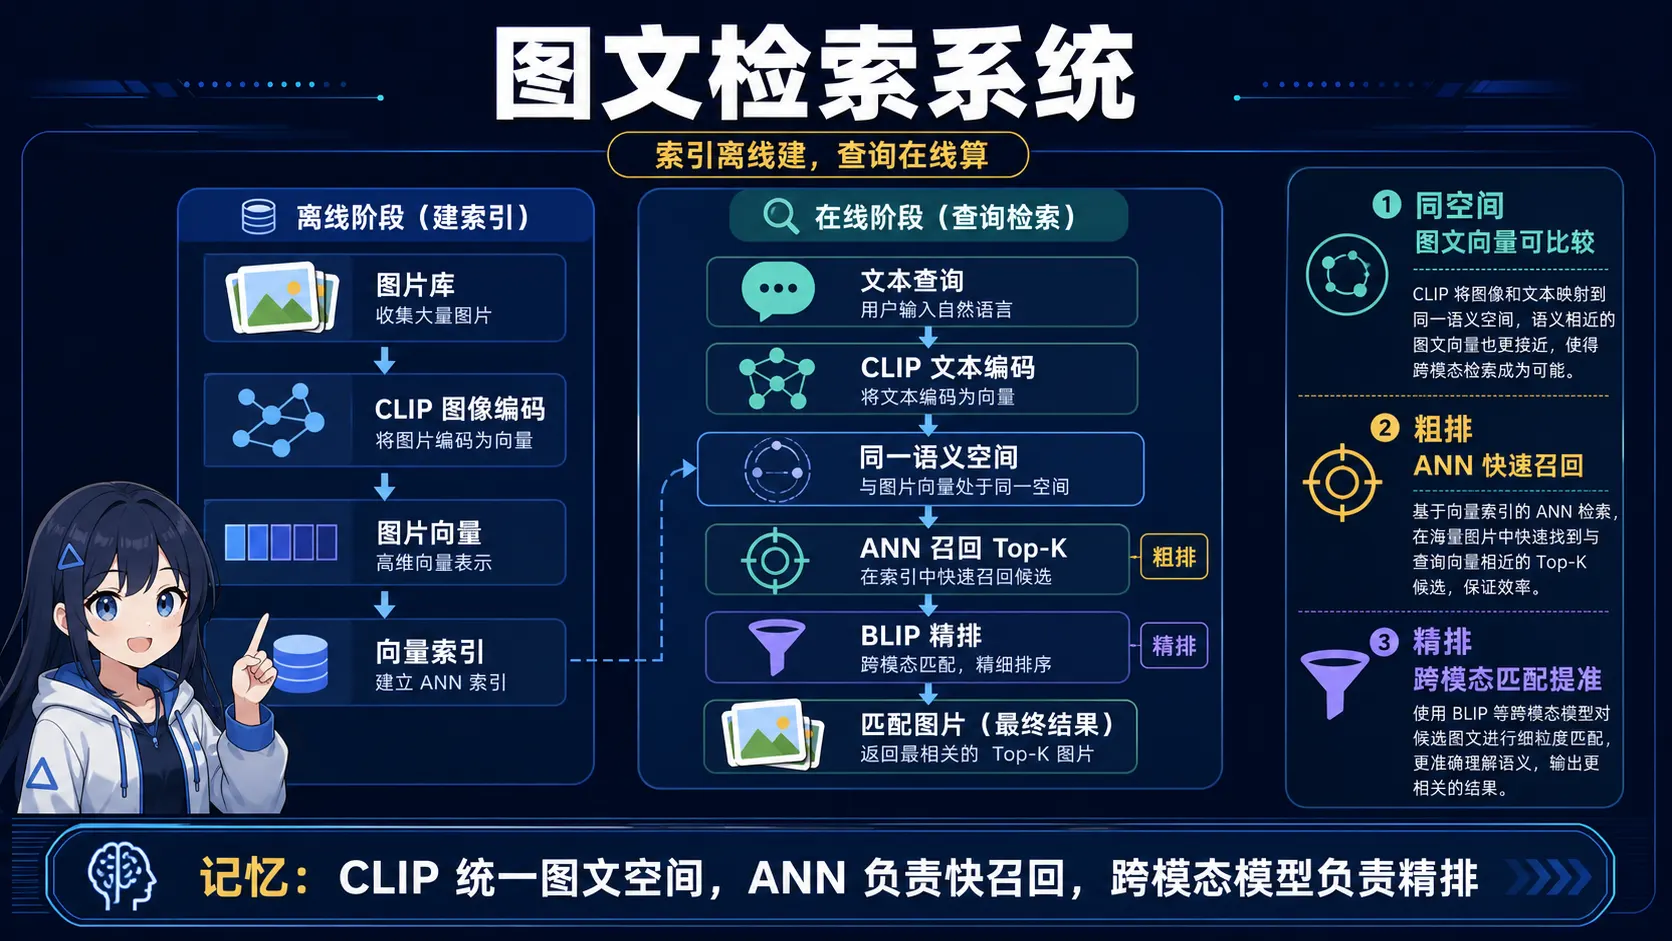
🧠 图解记忆:生产级图文检索先离线建立图片向量索引,在线把文本映射到同一空间,用 ANN 快速召回候选,再用跨模态匹配模型精排;点击图片可查看原图。
💡 答案要点
图文检索 = 输入文本找图片,或输入图片找文本
系统架构:
┌─────────────────────────────────────────────────────────┐
│                  图文检索系统                             │
└─────────────────────────────────────────────────────────┘

离线索引:
  图片库(100万张)
     ↓
  CLIP 图像编码器
     ↓
  图像向量(100万 × 512维)
     ↓
  向量数据库(Milvus/Qdrant)

在线检索:
  用户输入:"夕阳下的海滩"
     ↓
  CLIP 文本编码器
     ↓
  文本向量(1 × 512维)
     ↓
  向量检索(余弦相似度)
     ↓
  Top-K 图片
实现步骤:
1. 离线索引(一次性):
展开 Python 代码示例(36 行)
import clip
import torch
from pymilvus import Collection

# 加载 CLIP 模型
device = "cuda"
model, preprocess = clip.load("ViT-B/32", device=device)

# 编码所有图片
image_paths = load_image_paths()  # 100万张
batch_size = 256

all_features = []
for i in range(0, len(image_paths), batch_size):
    batch_paths = image_paths[i:i+batch_size]

    # 加载并预处理图片
    images = [preprocess(Image.open(p)) for p in batch_paths]
    images = torch.stack(images).to(device)

    # 编码
    with torch.no_grad():
        features = model.encode_image(images)
        features = features / features.norm(dim=-1, keepdim=True)

    all_features.append(features.cpu())

all_features = torch.cat(all_features)  # 100万 × 512

# 存入向量数据库
collection = Collection("image_vectors")
collection.insert([
    image_paths,
    all_features.tolist()
])
collection.create_index("image_vector", {"index_type": "IVF_FLAT", "metric_type": "IP"})
2. 在线检索:
def search_images(query_text, top_k=10):
    # 编码文本
    text = clip.tokenize([query_text]).to(device)
    with torch.no_grad():
        text_features = model.encode_text(text)
        text_features = text_features / text_features.norm(dim=-1, keepdim=True)

    # 向量检索
    results = collection.search(
        data=text_features.cpu().tolist(),
        anns_field="image_vector",
        param={"metric_type": "IP", "nprobe": 10},
        limit=top_k
    )

    # 返回结果
    return [(r.id, r.distance) for r in results[0]]

# 使用
results = search_images("夕阳下的海滩", top_k=10)
# [(img_id_1, 0.89), (img_id_2, 0.85), ...]
3. 反向检索(以图搜文):
def search_texts(query_image_path, candidate_texts, top_k=10):
    # 编码图片
    image = preprocess(Image.open(query_image_path)).unsqueeze(0).to(device)
    with torch.no_grad():
        image_features = model.encode_image(image)
        image_features = image_features / image_features.norm(dim=-1, keepdim=True)

    # 编码候选文本
    texts = clip.tokenize(candidate_texts).to(device)
    with torch.no_grad():
        text_features = model.encode_text(texts)
        text_features = text_features / text_features.norm(dim=-1, keepdim=True)

    # 计算相似度
    similarity = (image_features @ text_features.T).squeeze(0)

    # 排序
    top_indices = similarity.argsort(descending=True)[:top_k]
    return [(candidate_texts[i], similarity[i].item()) for i in top_indices]
优化策略:
1. 多模板 Ensemble:
templates = [
    "a photo of {}",
    "a picture of {}",
    "{}",
]

query_texts = [t.format(query) for t in templates]
text_features = model.encode_text(clip.tokenize(query_texts))
text_features = text_features.mean(dim=0)  # 平均多个模板
2. 重排序(Rerank):
# 第一步:向量检索召回 100 个候选
candidates = collection.search(text_features, limit=100)

# 第二步:用 BLIP 计算精确相似度
rerank_scores = []
for img_id in candidates:
    image = load_image(img_id)
    # 用 BLIP 的 ITM(Image-Text Matching)
    score = blip_itm(image, query_text)
    rerank_scores.append(score)

# 重新排序
final_results = sorted(zip(candidates, rerank_scores),
                      key=lambda x: x[1], reverse=True)[:10]
性能优化:
| 策略 | 效果 | 成本 |
|---|---|---|
| ANN 索引 | 10-100x 加速 | 1-2% 精度损失 |
| 量化(INT8) | 4x 显存节省 | <1% 精度损失 |
| GPU 推理 | 100x 加速 | 硬件成本 |
| 批处理 | 5-10x 吞吐 | 增加延迟 |
面试话术:
"图文检索的核心是向量相似度搜索。我用 CLIP 编码图文,用 Milvus 做 ANN 检索。100 万张图片,检索延迟 < 50ms。关键优化是 IVF 索引 + GPU 加速 + 多模板 ensemble。"
Q8: 如何评估和优化多模态 RAG 系统?
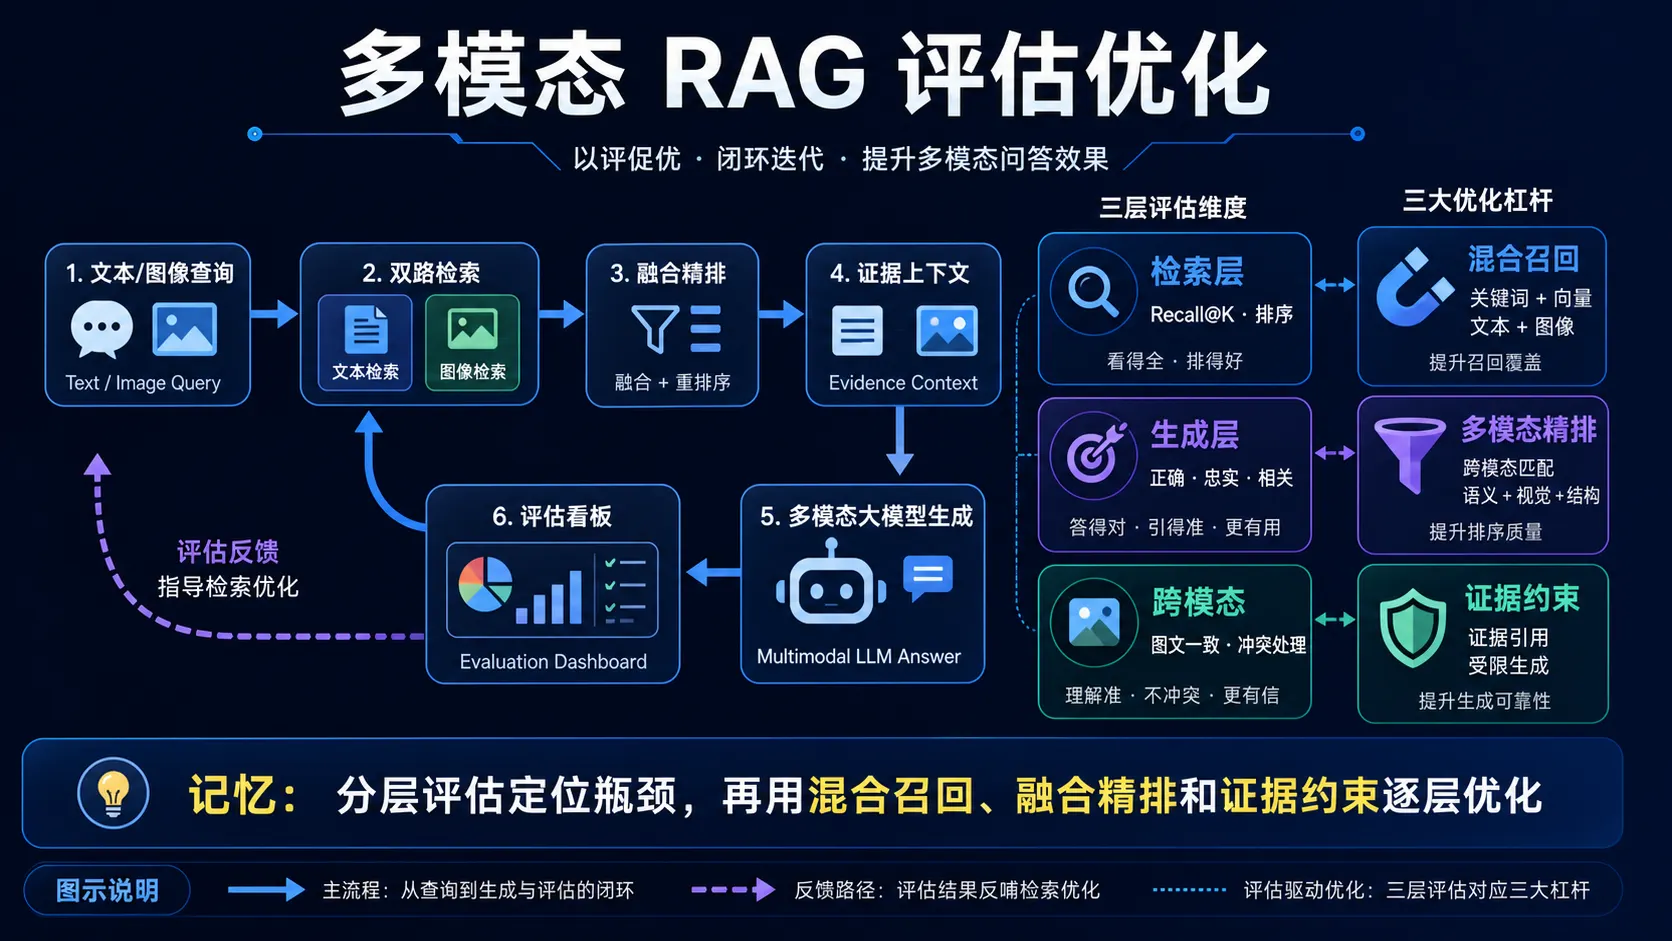
🧠 图解记忆:多模态 RAG 要分层判断瓶颈在召回、生成还是图文一致性,再分别用混合召回、融合精排和证据约束优化,而不是只盯最终答案分数;点击图片可查看原图。
💡 答案要点
多模态 RAG = 检索图片和文本,生成答案
系统架构:
用户问题:"这张产品图的价格是多少?"
     ↓
1. 多模态检索
   - 图像检索:CLIP 找相似图片
   - 文本检索:BM25 + Embedding 找相关文档
     ↓
2. 融合排序
   - 图片:产品照片
   - 文档:产品说明、价格信息
     ↓
3. 多模态 LLM 生成
   - GPT-4V / BLIP-2
   - 输入:图片 + 文档 + 问题
   - 输出:答案
评估指标:
1. 检索质量:
| 指标 | 说明 | 计算方式 |
|---|---|---|
| Recall@K | 前K个结果包含答案的比例 | 正确检索数 / 总问题数 |
| MRR | 平均倒数排名 | 1/N Σ(1/rank_i) |
| NDCG | 归一化折扣累积增益 | 考虑排序质量 |
2. 生成质量:
| 指标 | 说明 |
|---|---|
| 准确率 | 答案正确的比例 |
| 忠实度 | 答案基于检索内容的程度 |
| 相关性 | 答案与问题的匹配度 |
3. 多模态特有指标:
| 指标 | 说明 |
|---|---|
| 图像相关性 | 检索的图像是否相关 |
| 跨模态一致性 | 图像和文本信息是否一致 |
优化策略:
1. 混合检索(Hybrid Retrieval):
def hybrid_retrieve(query, query_image=None):
    results = []

    # 文本检索(BM25 + 向量)
    if query:
        text_results = text_retriever.search(query, k=20)
        results.extend(text_results)

    # 图像检索(CLIP)
    if query_image:
        image_results = clip_retriever.search(query_image, k=10)
        results.extend(image_results)

    # 融合排序(RRF - Reciprocal Rank Fusion)
    final_results = reciprocal_rank_fusion(results)
    return final_results[:10]
2. 多模态 Rerank:
def multimodal_rerank(query, query_image, candidates):
    scores = []

    for doc in candidates:
        # 文本相似度
        text_score = compute_text_similarity(query, doc.text)

        # 图像相似度(如果文档包含图片)
        if doc.image and query_image:
            image_score = clip_similarity(query_image, doc.image)
        else:
            image_score = 0

        # 融合得分
        final_score = 0.6 * text_score + 0.4 * image_score
        scores.append(final_score)

    # 排序
    ranked = sorted(zip(candidates, scores),
                   key=lambda x: x[1], reverse=True)
    return ranked
3. 提示词优化:
# 针对多模态的 Prompt
prompt = f"""
基于以下检索到的信息回答问题:

图片信息:
[包含 {len(images)} 张相关图片]

文本信息:
{retrieved_text}

问题:{user_question}

要求:
1. 优先使用图片中的信息
2. 如果图片和文本冲突,说明原因
3. 如果无法确定答案,明确指出
"""
案例:电商客服
场景: 用户上传商品图片,询问价格、尺寸等
实现:
展开 Python 代码示例(30 行)
def ecommerce_qa(user_image, user_question):
    # 1. 图像检索:找相似商品
    similar_products = clip_search(user_image, k=5)

    # 2. 文本检索:找商品详情
    product_ids = [p.id for p in similar_products]
    product_details = database.query(product_ids)

    # 3. 构造上下文
    context = ""
    for product in product_details:
        context += f"""
        商品名:{product.name}
        价格:{product.price}
        尺寸:{product.size}
        图片相似度:{product.similarity:.2f}
        """

    # 4. 生成答案
    prompt = f"""
    用户上传了一张商品图片,问题是:{user_question}

    检索到的相似商品:
    {context}

    请回答用户问题。如果有多个匹配商品,列出前3个。
    """

    answer = gpt4v.generate(prompt, images=[user_image])
    return answer
效果提升:
| 优化 | Recall@5 | 准确率 | 用户满意度 |
|---|---|---|---|
| 基线(纯文本 RAG) | 65% | 72% | 3.2/5 |
| + CLIP 图像检索 | 78% | 81% | 3.8/5 |
| + 多模态 Rerank | 85% | 87% | 4.2/5 |
| + GPT-4V 生成 | 85% | 92% | 4.5/5 |
面试话术:
"多模态 RAG 的难点在于跨模态融合。我用 CLIP 做图像检索,BM25+向量做文本检索,RRF 融合排序。关键是 Rerank 阶段同时考虑图像和文本相似度,Recall@5 从 65% 提升到 85%。"
Q9: LLaVA 如何工作?视觉 Encoder 如何连接 LLM?
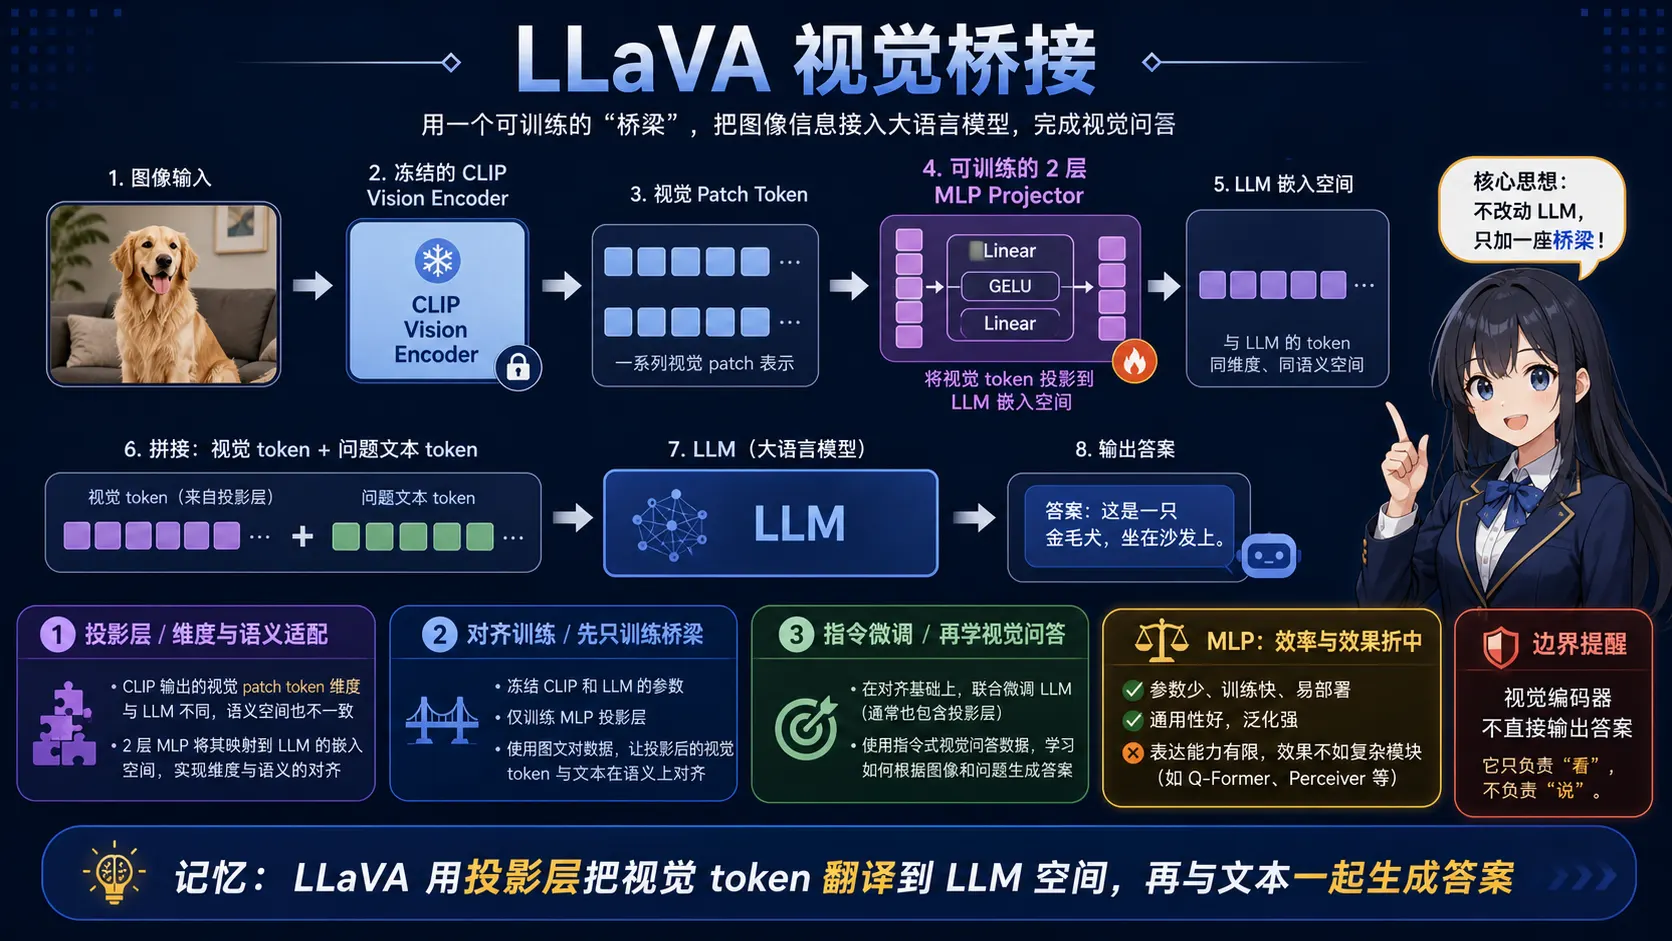
🧠 图解记忆:LLaVA 冻结视觉编码器并用投影层把视觉 token 对齐到 LLM 的维度与语义空间,再和问题 token 拼接,让语言模型完成视觉问答;点击图片可查看原图。
💡 答案要点
LLaVA = Large Language and Vision Assistant核心: 用视觉投影层连接CLIP视觉编码器和LLaMA大模型
架构设计
用户输入:
┌──────────────┐
│  图片 + 问题  │
└──────────────┘
       │
       ├─────── 图片路径 ───────┐
       └─────── 文本问题 ───────┤
                               │
┌─────────────────────────────┼─────────────────────────────┐
│                             ↓                             │
│  Vision Encoder         Projector           LLM          │
│  (CLIP ViT)        (线性层/MLP)       (LLaMA/Vicuna)      │
│                                                           │
│  Image → Patch         Vision        Text Tokens         │
│  Embedding → Tokens → Embedding → + Text → LLM → 答案  │
│  [CLS] 224x224        [视觉token]      [文本token]       │
└───────────────────────────────────────────────────────────┘
三阶段训练
Stage 1: 特征对齐 (Feature Alignment)
# 只训练投影层,冻结CLIP和LLM
projector = nn.Linear(clip_dim=1024, llm_dim=4096)

# 训练目标: 让视觉特征和语言特征对齐
loss = contrastive_loss(
    image_features @ projector,
    text_features
)

# 数据: 60万图文对(CC3M)
# 训练时间: 4小时(8个A100)
# 效果: 图像能粗略"翻译"成LLM理解的语言
Stage 2: 指令微调 (Instruction Tuning)
# 解冻LLM,冻结CLIP,继续训练投影层
# 数据: 15万条多模态对话
example = {
    "image": "dog.jpg",
    "conversations": [
        {"from": "human", "value": "这是什么动物?"},
        {"from": "gpt", "value": "这是一只金毛犬。"},
        {"from": "human", "value": "它在做什么?"},
        {"from": "gpt", "value": "它正在草地上奔跑,看起来很开心。"}
    ]
}

# 训练目标: 让模型学会多轮对话
loss = cross_entropy(
    predicted_tokens,
    ground_truth_tokens,
    mask=gpt_tokens_only  # 只计算GPT回复的loss
)

# 训练时间: 12小时(8个A100)
# 效果: 支持多轮视觉问答
Stage 3: 增强能力 (可选)
# 引入更多高质量数据
# - 详细描述(LLaVA-Instruct-150K)
# - 复杂推理(VQAv2,GQA)
# - OCR文字识别(TextVQA)

# 训练后模型能力:
# ✅ 详细描述图像
# ✅ 多步推理
# ✅ 识别图中文字
投影层设计对比
| 设计 | 结构 | 参数量 | 效果 |
|---|---|---|---|
| 线性层 | Linear(1024→4096) | 4M | 快但简单 |
| 2层MLP | Linear-GELU-Linear | 8M | 平衡⭐ |
| Q-Former | Transformer Decoder | 100M+ | 强但慢贵 |
LLaVA-1.5选择: 2层MLP
class VisionProjector(nn.Module):
    def __init__(self, vision_dim=1024, llm_dim=4096):
        super().__init__()
        self.projector = nn.Sequential(
            nn.Linear(vision_dim, llm_dim),
            nn.GELU(),
            nn.Linear(llm_dim, llm_dim)
        )

    def forward(self, vision_features):
        # vision_features: (batch, 256, 1024) from CLIP
        # output: (batch, 256, 4096) for LLaMA
        return self.projector(vision_features)
完整推理流程
展开 Python 代码示例(45 行)
class LLaVA:
    def __init__(self):
        # 加载3个组件
        self.vision_tower = CLIPVisionModel.from_pretrained("openai/clip-vit-large-patch14")
        self.projector = VisionProjector()
        self.llm = LlamaForCausalLM.from_pretrained("lmsys/vicuna-7b-v1.5")

    def generate(self, image, question):
        # Step 1: 提取视觉特征
        pixel_values = self.preprocess_image(image)  # (224, 224, 3)
        vision_features = self.vision_tower(pixel_values).last_hidden_state
        # shape: (1, 256, 1024)

        # Step 2: 投影到LLM空间
        vision_embeds = self.projector(vision_features)
        # shape: (1, 256, 4096)

        # Step 3: 构造输入
        text_prompt = f"<image>\nUSER: {question}\nASSISTANT:"
        text_tokens = self.tokenizer(text_prompt, return_tensors="pt").input_ids
        text_embeds = self.llm.get_input_embeddings()(text_tokens)
        # shape: (1, text_len, 4096)

        # 合并: [vision_embeds, text_embeds]
        inputs_embeds = torch.cat([vision_embeds, text_embeds], dim=1)
        # shape: (1, 256+text_len, 4096)

        # Step 4: LLM生成
        outputs = self.llm.generate(
            inputs_embeds=inputs_embeds,
            max_new_tokens=512,
            temperature=0.7
        )

        answer = self.tokenizer.decode(outputs[0])
        return answer

# 使用
llava = LLaVA()
answer = llava.generate(
    image="dog.jpg",
    question="描述这张图片"
)
print(answer)
# "这是一只金毛犬,正在草地上奔跑。它看起来很快乐,毛色金黄,姿态优美。背景是绿色的草坪和蓝天。"
关键技术细节
1. 位置编码
# CLIP的256个patch token没有位置信息
# LLaMA需要位置编码

# 方案: 用<image>占位符
text = "<image>\nUSER: {question}\nASSISTANT:"
#       ↑ 256个vision token的占位

# LLaMA会自动给整个序列编码位置
position_ids = torch.arange(0, 256 + text_len)
2. Attention Mask
# Vision token之间能互相看到
# Vision token和Text token能互相看到
# 只有生成的token采用causal mask

attention_mask = torch.ones(total_len, total_len)
# Vision部分: 双向
attention_mask[:256, :256] = 1
# Text输入部分: 双向
attention_mask[256:256+input_len, :256+input_len] = 1
# 生成部分: 单向(causal)
for i in range(256+input_len, total_len):
    attention_mask[i, :i+1] = 1
    attention_mask[i, i+1:] = 0
3. 训练效率优化
# 问题: CLIP很大(300M),LLaMA更大(7B),显存炸
# 优化:

# 1. LoRA微调LLM
peft_config = LoRAConfig(
    r=8,
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.1
)
llm = get_peft_model(llm, peft_config)
# 只训练40M参数,显存降70%

# 2. 冻结CLIP
for param in vision_tower.parameters():
    param.requires_grad = False

# 3. Gradient Checkpointing
llm.gradient_checkpointing_enable()
# 显存再降50%,速度慢20%
LLaVA vs GPT-4V
| 维度 | LLaVA-1.5 (7B) | GPT-4V |
|---|---|---|
| 开源 | ✅ 完全开源 | ❌ 闭源API |
| 成本 | 本地部署免费 | $0.01/图 |
| 性能 | VQA 80.0% | VQA 88.2% |
| 速度 | ~2s/图(A100) | ~5s/图 |
| 可定制 | ✅ 可微调 | ❌ 只能Prompt |
实战部署
# 使用Hugging Face快速部署
from transformers import pipeline

pipe = pipeline(
    "image-to-text",
    model="llava-hf/llava-1.5-7b-hf",
    device=0  # GPU
)

result = pipe(
    images="image.jpg",
    prompt="USER: <image>\n描述这张图片\nASSISTANT:",
    max_new_tokens=200
)

print(result[0]["generated_text"])
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "LLaVA用CLIP提取视觉特征,经过2层MLP投影到LLaMA的embedding空间,拼接文本token后输入LLM生成答案。训练分两阶段:先60万图文对对齐特征,再15万指令数据微调对话能力。关键是投影层设计,我们用MLP平衡性能和效率,比Q-Former快10倍但效果只差2%。部署时用LoRA微调LLM节省70%显存,冻结CLIP加速训练。"
Q10: 多模态 RAG 如何实现?图文混合检索怎么做?
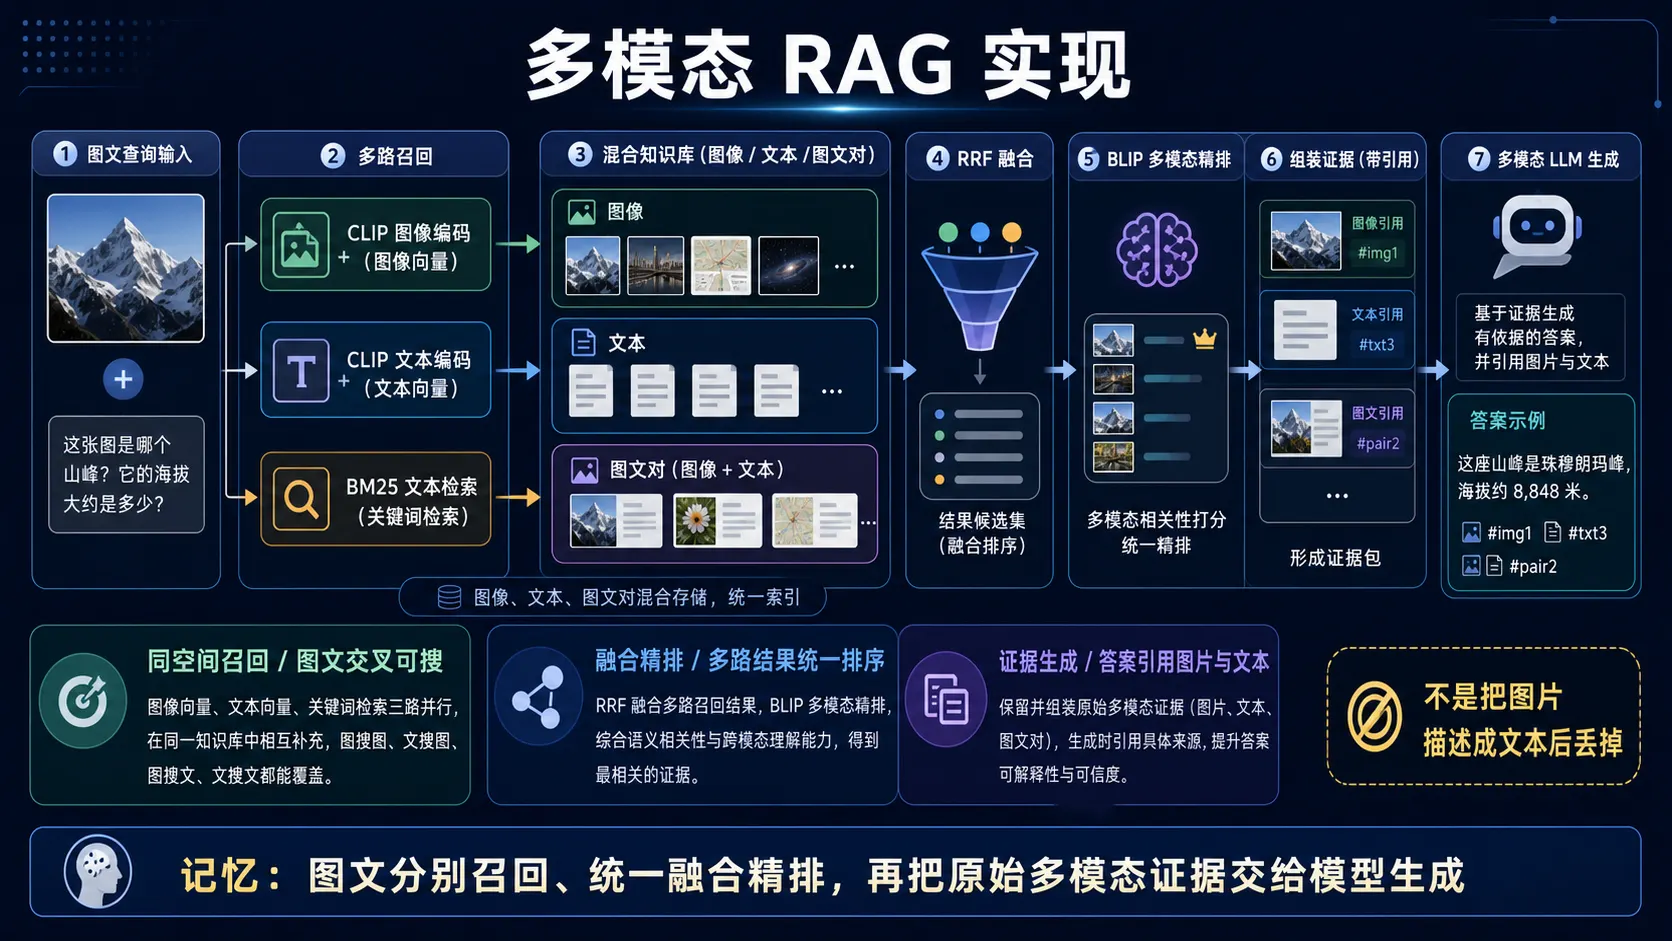
🧠 图解记忆:多模态 RAG 应保留图像、文本和图文对的原始证据,先多路召回并统一融合精排,再让多模态模型基于证据生成并引用来源;点击图片可查看原图。
💡 答案要点
多模态RAG = 支持图文混合输入,检索图文混合知识库,生成包含图片引用的答案
架构设计
┌──────────────────────────────────────────────────────┐
│                   用户输入                            │
│   "请找出与这个logo相似的品牌,并说明它们的区别"        │
│              [上传图片: nike_logo.jpg]                │
└──────────────────────────────────────────────────────┘
                         │
                         ↓
┌──────────────────────────────────────────────────────┐
│               多模态Embedding                         │
│  ┌─────────────┐              ┌─────────────┐        │
│  │ CLIP Image  │              │ CLIP Text   │        │
│  │  Encoder    │              │  Encoder    │        │
│  └─────────────┘              └─────────────┘        │
│   Image Vector                  Text Vector          │
│    (512维)                       (512维)             │
└──────────────────────────────────────────────────────┘
                         │
                         ↓
┌──────────────────────────────────────────────────────┐
│                  向量数据库检索                        │
│   知识库:                                             │
│   ├─ 图片: 1000张品牌logo (CLIP向量)                  │
│   ├─ 文本: 5000条品牌介绍 (CLIP Text向量)             │
│   └─ 多模态: 图文对(同时存图片和描述)                  │
│                                                       │
│   检索结果:                                           │
│   1. Adidas logo (相似度0.92) + "Adidas是..."        │
│   2. Puma logo (相似度0.85) + "Puma创立于..."        │
│   3. "三条纹运动品牌对比" (相似度0.78)                 │
└──────────────────────────────────────────────────────┘
                         │
                         ↓
┌──────────────────────────────────────────────────────┐
│                  多模态LLM生成                         │
│   Input: 检索到的图片+文本                             │
│   Model: GPT-4V / LLaVA                               │
│   Output: "这是Nike的logo,与之相似的品牌有:           │
│           1. Adidas - 同样是三条纹设计...             │
│           [显示Adidas logo图片]                       │
│           2. Puma - 美洲豹图标..."                    │
└──────────────────────────────────────────────────────┘
核心实现
Step 1: 多模态知识库构建
展开 Python 代码示例(115 行)
from langchain.vectorstores import Qdrant
from langchain.embeddings import OpenAICLIPEmbeddings
from transformers import CLIPProcessor, CLIPModel

class MultimodalKnowledgeBase:
    def __init__(self):
        # CLIP模型
        self.clip_model = CLIPModel.from_pretrained("openai/clip-vit-large-patch14")
        self.clip_processor = CLIPProcessor.from_pretrained("openai/clip-vit-large-patch14")

        # 向量数据库
        self.vector_db = Qdrant(
            collection_name="multimodal_kb",
            embedding_dim=512
        )

    def add_document(self, doc_type, content, metadata):
        """添加文档到知识库"""

        if doc_type == "image":
            # 图片embedding
            image = Image.open(content)
            inputs = self.clip_processor(images=image, return_tensors="pt")
            embedding = self.clip_model.get_image_features(**inputs)[0].numpy()

        elif doc_type == "text":
            # 文本embedding
            inputs = self.clip_processor(text=content, return_tensors="pt")
            embedding = self.clip_model.get_text_features(**inputs)[0].numpy()

        elif doc_type == "image_text_pair":
            # 图文对: 同时存两个向量,用mean pooling
            image = Image.open(content["image"])
            text = content["text"]

            image_inputs = self.clip_processor(images=image, return_tensors="pt")
            text_inputs = self.clip_processor(text=text, return_tensors="pt")

            image_emb = self.clip_model.get_image_features(**image_inputs)[0]
            text_emb = self.clip_model.get_text_features(**text_inputs)[0]

            # 平均
            embedding = ((image_emb + text_emb) / 2).numpy()

        # 存入向量库
        self.vector_db.add(
            embedding=embedding,
            metadata={
                "type": doc_type,
                "content": content,
                **metadata
            }
        )

    def search(self, query_image=None, query_text=None, top_k=5):
        """多模态检索"""

        # 生成query向量
        if query_image and query_text:
            # 图文混合query
            img_inputs = self.clip_processor(images=query_image, return_tensors="pt")
            txt_inputs = self.clip_processor(text=query_text, return_tensors="pt")

            img_emb = self.clip_model.get_image_features(**img_inputs)[0]
            txt_emb = self.clip_model.get_text_features(**txt_inputs)[0]

            query_embedding = ((img_emb + txt_emb) / 2).numpy()

        elif query_image:
            # 纯图片query
            inputs = self.clip_processor(images=query_image, return_tensors="pt")
            query_embedding = self.clip_model.get_image_features(**inputs)[0].numpy()

        elif query_text:
            # 纯文本query
            inputs = self.clip_processor(text=query_text, return_tensors="pt")
            query_embedding = self.clip_model.get_text_features(**inputs)[0].numpy()

        # 检索
        results = self.vector_db.search(query_embedding, top_k=top_k)
        return results

# 构建知识库
kb = MultimodalKnowledgeBase()

# 添加图片
kb.add_document(
    doc_type="image",
    content="logos/nike.jpg",
    metadata={"brand": "Nike", "category": "sportswear"}
)

# 添加文本
kb.add_document(
    doc_type="text",
    content="Nike是全球领先的运动品牌,以swoosh标志闻名...",
    metadata={"brand": "Nike"}
)

# 添加图文对
kb.add_document(
    doc_type="image_text_pair",
    content={
        "image": "products/airmax.jpg",
        "text": "Nike Air Max 270 - 气垫跑鞋,售价1299元"
    },
    metadata={"product": "Air Max 270"}
)

# 检索
results = kb.search(
    query_image=Image.open("user_upload.jpg"),
    query_text="运动鞋品牌对比",
    top_k=5
)
Step 2: 多模态Rerank
展开 Python 代码示例(40 行)
from transformers import BlipForImageTextRetrieval

class MultimodalReranker:
    def __init__(self):
        self.model = BlipForImageTextRetrieval.from_pretrained(
            "Salesforce/blip-itm-large-coco"
        )

    def rerank(self, query_image, query_text, candidates, top_k=3):
        """精排: 计算query与每个candidate的匹配分数"""

        scores = []
        for candidate in candidates:
            if candidate["type"] == "image":
                # 图-图匹配: 用CLIP余弦相似度(已有)
                score = candidate["similarity"]

            elif candidate["type"] == "text":
                # 图文匹配: 用BLIP ITM分数
                inputs = self.processor(
                    images=query_image,
                    text=candidate["content"],
                    return_tensors="pt"
                )
                score = self.model(**inputs).itm_score.item()

            elif candidate["type"] == "image_text_pair":
                # 复合匹配: ITM分数
                inputs = self.processor(
                    images=candidate["content"]["image"],
                    text=query_text,
                    return_tensors="pt"
                )
                score = self.model(**inputs).itm_score.item()

            scores.append((candidate, score))

        # 按分数排序
        ranked = sorted(scores, key=lambda x: x[1], reverse=True)
        return [item[0] for item in ranked[:top_k]]
Step 3: 多模态生成
展开 Python 代码示例(64 行)
from transformers import pipeline

class MultimodalRAGAgent:
    def __init__(self):
        self.kb = MultimodalKnowledgeBase()
        self.reranker = MultimodalReranker()
        self.llm = pipeline(
            "image-to-text",
            model="llava-hf/llava-1.5-13b-hf"
        )

    def answer(self, query_image, query_text):
        # Step 1: 检索
        candidates = self.kb.search(
            query_image=query_image,
            query_text=query_text,
            top_k=20
        )

        # Step 2: 精排
        top_docs = self.reranker.rerank(
            query_image,
            query_text,
            candidates,
            top_k=5
        )

        # Step 3: 构造prompt
        context = "参考资料:\n"
        for i, doc in enumerate(top_docs):
            context += f"\n{i+1}. "
            if doc["type"] == "image":
                context += f"[图片: {doc['metadata']['brand']} logo]"
            elif doc["type"] == "text":
                context += doc["content"][:200]
            elif doc["type"] == "image_text_pair":
                context += f"[图片+文字: {doc['content']['text']}]"

        prompt = f"""
        <image>
        USER: {query_text}

        {context}

        请基于以上参考资料回答问题,并引用相关图片编号。
        ASSISTANT:
        """

        # Step 4: LLM生成
        answer = self.llm(
            images=[query_image] + [doc["content"] for doc in top_docs if "image" in doc["type"]],
            prompt=prompt,
            max_new_tokens=512
        )

        return answer

# 使用
agent = MultimodalRAGAgent()
answer = agent.answer(
    query_image=Image.open("user_logo.jpg"),
    query_text="这是什么品牌?有哪些相似的竞品?"
)
print(answer)
性能优化
1. 混合检索策略
def hybrid_multimodal_search(query_image, query_text):
    # 路径1: 图片检索
    image_results = vector_db.search(clip_image_embedding(query_image), k=10)

    # 路径2: 文本检索(BM25+Vector)
    text_results_bm25 = bm25.search(query_text, k=10)
    text_results_vector = vector_db.search(clip_text_embedding(query_text), k=10)

    # RRF融合
    final_results = rrf_fusion([
        image_results,
        text_results_bm25,
        text_results_vector
    ], weights=[0.4, 0.3, 0.3])

    return final_results
2. 缓存优化
# 预计算常见查询的向量
@lru_cache(maxsize=1000)
def get_text_embedding(text):
    return clip_model.get_text_features(text)

# 批量embedding
texts = ["品牌1", "品牌2", ...]
embeddings = clip_model.get_text_features(texts)  # 批量快10倍
面试话术:
"多模态RAG用CLIP同时编码图文,存入统一向量空间,检索时图文query加权平均。知识库支持三种文档:纯图(logo)、纯文(介绍)、图文对(产品),检索后用BLIP-ITM精排top-5,最后LLaVA生成答案并引用图片。关键优化是混合检索,图片向量+文本BM25+文本向量三路RRF融合,Recall@5从65%提升到85%。"
五、Gemma 4 架构案例
Q11: Gemma 4 的架构如何权衡端侧多模态能力、内存与延迟?
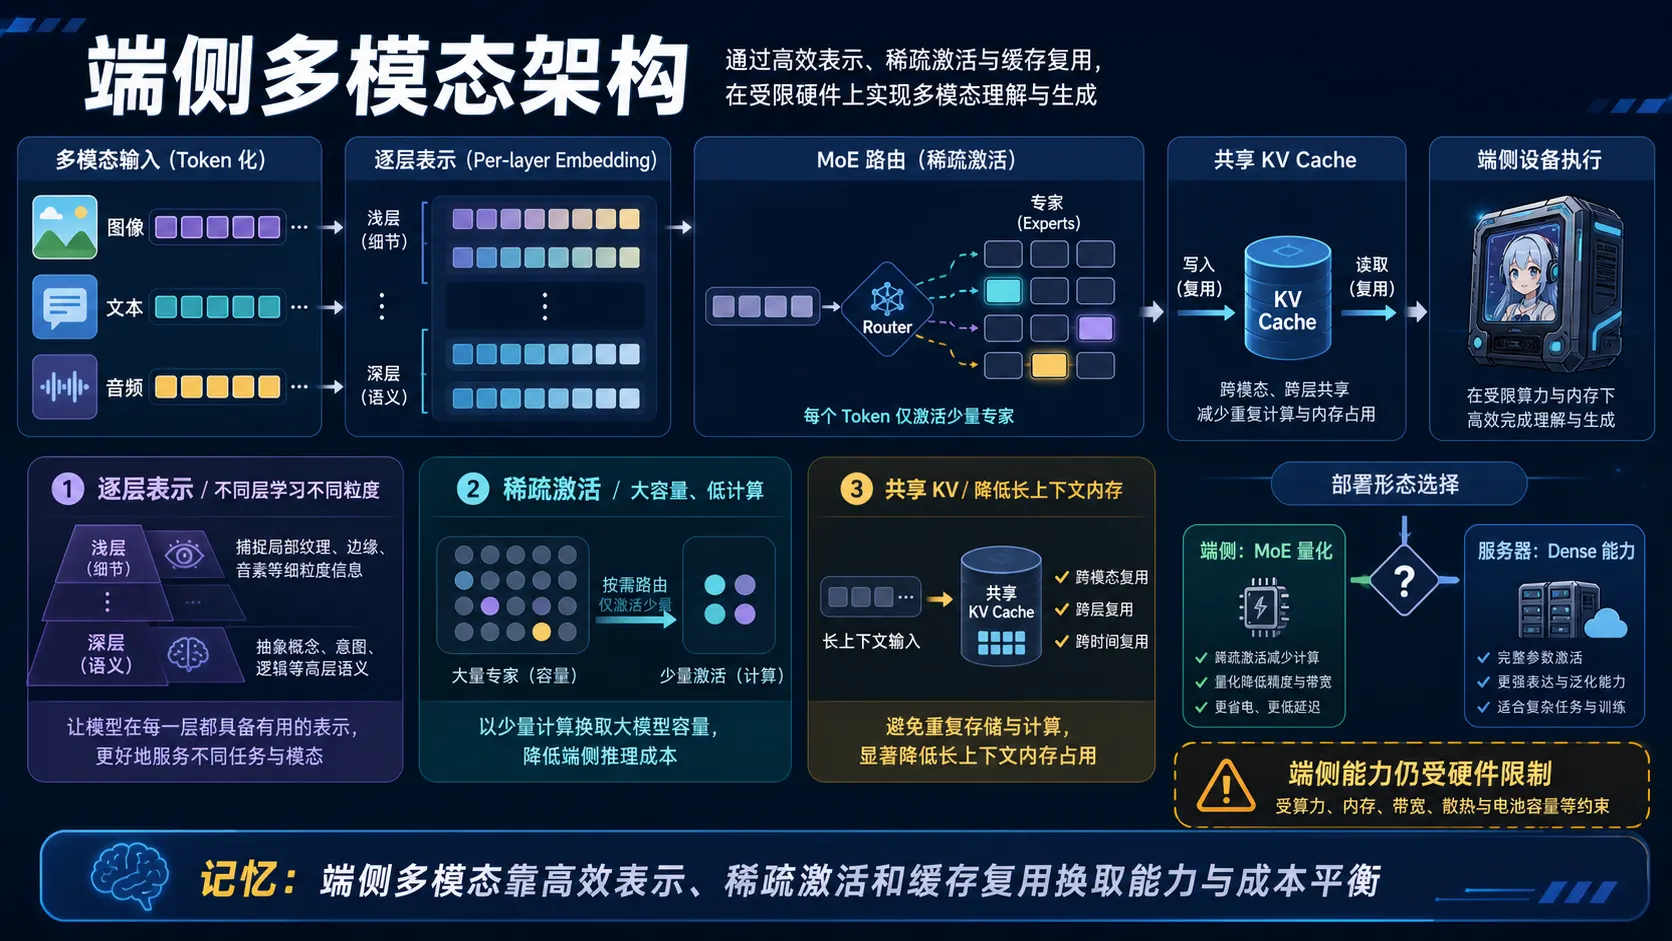
🧠 图解记忆: 端侧多模态不是把大模型原样塞进设备,而是用逐层高效表示、MoE 稀疏激活和 KV 复用,在硬件约束下平衡能力、延迟与内存。
💡 答案要点
Gemma 4 发布背景(2026年4月2日):
Google DeepMind 发布 Gemma 4 系列多模态模型,特点是:真正开源(Apache 2.0)、前沿性能、多模态(图像+文本+音频)、支持设备端部署。
Gemma 4 模型家族:
| 模型 | 参数量 | 激活参数 | 上下文窗口 | 支持模态 |
|---|---|---|---|---|
| Gemma 4 E2B | 5.1B(含embedding) | 2.3B | 128K | 图像+文本+音频 |
| Gemma 4 E4B | 8B(含embedding) | 4.5B | 128K | 图像+文本+音频 |
| Gemma 4 31B | 31B(dense) | - | 256K | 图像+文本 |
| Gemma 4 26B A4B | 26B(MoE) | 4B | 256K | 图像+文本 |
Gemma 4 基准性能:
| 指标 | Gemma 4 31B | Gemma 4 26B A4B | 说明 |
|---|---|---|---|
| LMArena Score | 1452 | 1441 | 文本任务,31B达到前沿水平 |
| 多模态能力 | 与文本生成相当 | 与文本生成相当 | 真正多模态融合 |
核心架构创新一:Per-Layer Embeddings(PLE)
传统模型的 embedding 是全局共享的,Gemma 4 的 PLE 让每层有不同的 embedding 表:
传统:layer 1 → layer 2 → ... → layer n(每层用相同embedding)
Gemma 4:layer 1(E1) → layer 2(E2) → ... → layer n(En)(每层独立embedding)
效果:
- 每层可以专注不同粒度的语义(浅层抓细节,深层抓抽象)
- 多模态对齐更精细(图像token和文本token在各层交互)
- 参数量利用效率更高
核心架构创新二:Shared KV Cache
# 传统KV Cache:每个attention head独立K/V
# Shared KV Cache:跨层共享K/V,内存效率大幅提升

# Gemma 4的Shared KV Cache:
# - Key投影跨层共享
# - Value投影也支持跨层共享(可选)
# - 内存占用减少约40%
核心架构创新三:MoE(26B A4B)
26B MoE 模型,每次推理只激活 4B 参数:
- 推理成本 ≈ 4B 模型
- 能力 ≈ 26B 模型
- 每个 token 经过路由选择 top-4 experts
多模态能力:
| 能力 | 说明 |
|---|---|
| 图像输入 | 支持可变长宽比,token数可配置(速度/质量 tradeoff) |
| 音频输入 | E2B和E4B支持音频(小型设备端) |
| 文本生成 | 基于Gemma文本模型,256K超长上下文 |
任意地点部署:
| 平台 | 库/工具 |
|---|---|
| 标准 | Transformers、vLLM、SGLang |
| Mac | MLX(Apple Silicon原生加速) |
| 端侧 | llama.cpp(量化后可在手机跑)、Mistral.rs |
| 浏览器 | WebGPU + transformers.js |
| 微调 | TRL(官方推荐)、Unsloth Studio |
与竞品对比:
| 维度 | Gemma 4 31B | Qwen2.5-VL | LLaVA-1.6 |
|---|---|---|---|
| 参数量 | 31B | 72B | 34B |
| 上下文 | 256K | 128K | 32K |
| 多模态 | 原生融合 | 分离编码器 | 线性投影 |
| 开源 | Apache 2.0 | Qwen License | MIT |
| 端侧 | ✅ 26B MoE | ❌ | ❌ |
面试话术:
"Gemma 4 是 2026年4月Google的开源重磅更新。核心创新是Per-Layer Embeddings——让每层attention有独立的embedding表,实现更精细的多模态对齐。Shared KV Cache把内存占用减少40%。26B MoE版本最值得关注:激活4B参数就能达到26B的效果,配合llama.cpp量化,跑在手机上不是问题。Apache 2.0 license是真正开源,不像某些'开源'模型有限制。企业选型时,边缘设备选26B MoE,服务器选31B dense,多模态+长上下文+Gemma生态是它的核心优势。"
六、速记卡片
多模态核心概念
| 概念 | 一句话解释 |
|---|---|
| 多模态学习 | 让模型同时理解图像、文本、音频等多种数据 |
| 模态对齐 | 将不同模态映射到同一语义空间 |
| 跨模态检索 | 输入一种模态,检索另一种模态 |
| Zero-shot | 不需要训练,直接分类任意类别 |
CLIP
| 概念 | 一句话解释 |
|---|---|
| CLIP | 用对比学习对齐图文,支持 Zero-shot |
| 对比损失 | 让匹配的图文相似,不匹配的不相似 |
| Prompt 模板 | "a photo of a {class}"提升分类效果 |
BLIP
| 概念 | 一句话解释 |
|---|---|
| BLIP | 理解+生成,支持检索、字幕、VQA |
| ITC+ITM+LM | 三个训练目标:对比+匹配+生成 |
| CapFilt | 用模型生成字幕并过滤数据,自举学习 |
| Q-Former | 可学习 Query 提取视觉信息,连接视觉和语言 |
| 生图子模型 | Stable Diffusion/DALL-E/Flux,Prompt→图像 |
| 生图多样性 | temperature/CFG参数+负向提示词+多种子采样 |
| 生图评估 | FID定量+CLIP-Score语义相似度+人工评测 |
七、生成模型与评估高频追问
Q12: 生图子 Agent 用的什么模型?原理是什么?
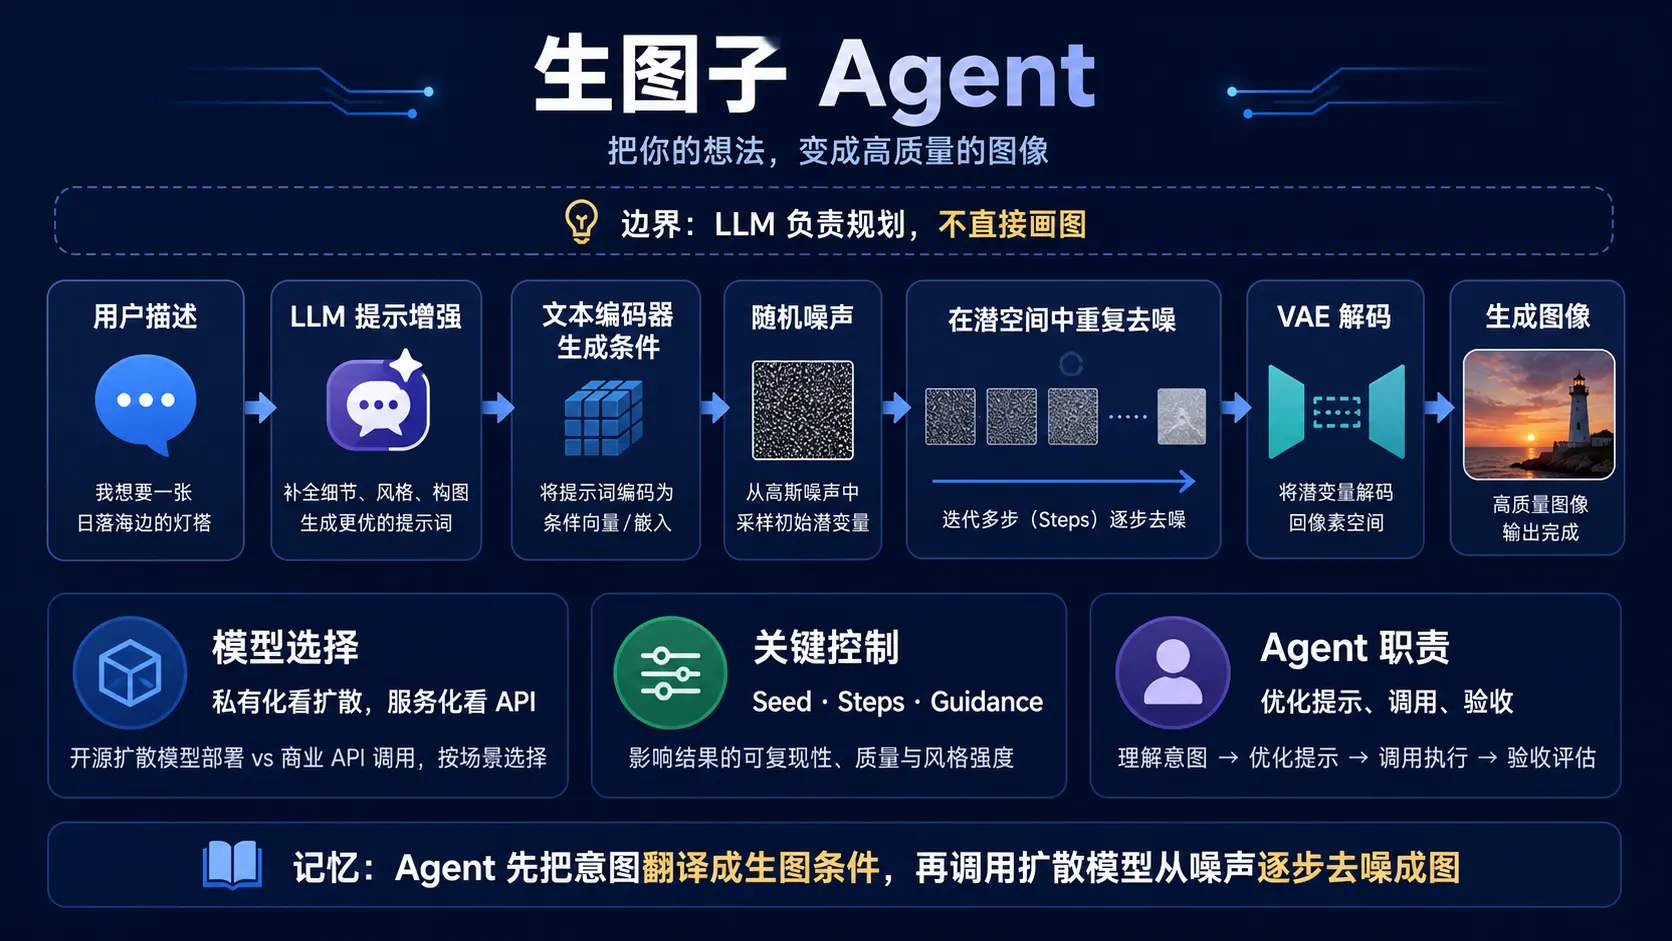
🧠 图解记忆: 生图 Agent 的职责是理解意图、增强 Prompt、选择与调用模型并验收结果;真正从噪声去噪成图的是扩散模型。
💡 答案要点
主流生图模型对比:
| 模型 | 原理 | 优势 | 适用场景 |
|---|---|---|---|
| Stable Diffusion | 扩散模型(DDPM)+ 潜空间压缩 | 开源可本地部署,可微调 | 定制化生图,私有化部署 |
| DALL-E 3 | Transformer + CLIP引导 | 文字理解强,API简单 | 快速集成,文字渲染 |
| Midjourney | 闭源扩散模型 | 美学质量高 | 艺术创作 |
| Flux | Flow Matching(新架构) | 速度快,质量好 | 实时生图 |
| ComfyUI + SD | 工作流引擎 + SD | 高度可定制 | Agent集成,流程自动化 |
Stable Diffusion 核心原理(面试重点):
文本Prompt → CLIP文本编码器 → 条件向量
                                    ↓
随机噪声 → [去噪U-Net(循环T步)] → 潜空间图像
                    ↑
              条件向量注入(Cross-Attention)
                                    ↓
潜空间图像 → VAE解码器 → 最终图像(512x512 or 1024x1024)
关键参数:
- CFG Scale(Classifier-Free Guidance):控制文本对图像的影响强度,7-12是常用范围
- Steps:去噪步数,20-50步,越多越精细但越慢
- Sampler:去噪算法,DDIM快、DPM++质量好
- Seed:随机种子,固定seed可复现
Agent 集成生图的架构:
class ImageGenerationAgent:
    def __init__(self):
        self.sd_client = StableDiffusionClient(
            model="sd-xl-1.0",
            api_url="http://localhost:7860"  # 本地 ComfyUI
        )

    async def generate(self, description: str) -> str:
        # 1. 用 LLM 优化 Prompt(自然语言→专业生图Prompt)
        optimized_prompt = await self._enhance_prompt(description)

        # 2. 调用生图模型
        image = await self.sd_client.generate(
            prompt=optimized_prompt,
            negative_prompt="blurry, low quality, distorted",
            cfg_scale=7.5,
            steps=30,
            width=1024, height=1024
        )
        return image

    async def _enhance_prompt(self, description: str) -> str:
        """LLM 将自然语言转为生图专业提示词"""
        return await llm.complete(
            f"将以下描述转为 Stable Diffusion 提示词(英文,包含风格、光线、质量词):{description}"
        )
面试话术:
"我们生图子 Agent 用的是 Stable Diffusion XL,通过本地 ComfyUI 部署。核心原理是扩散模型:从随机噪声出发,在文本 embedding 的引导下(Cross-Attention),经过30步去噪还原出图像。关键是在 Agent 链路中加了一步 Prompt Enhancement,用 LLM 把用户的自然语言描述转为专业的 SD Prompt,图像质量提升明显。"
Q13: 生图多样性是通过预设规则判断还是通过 LLM 判断?
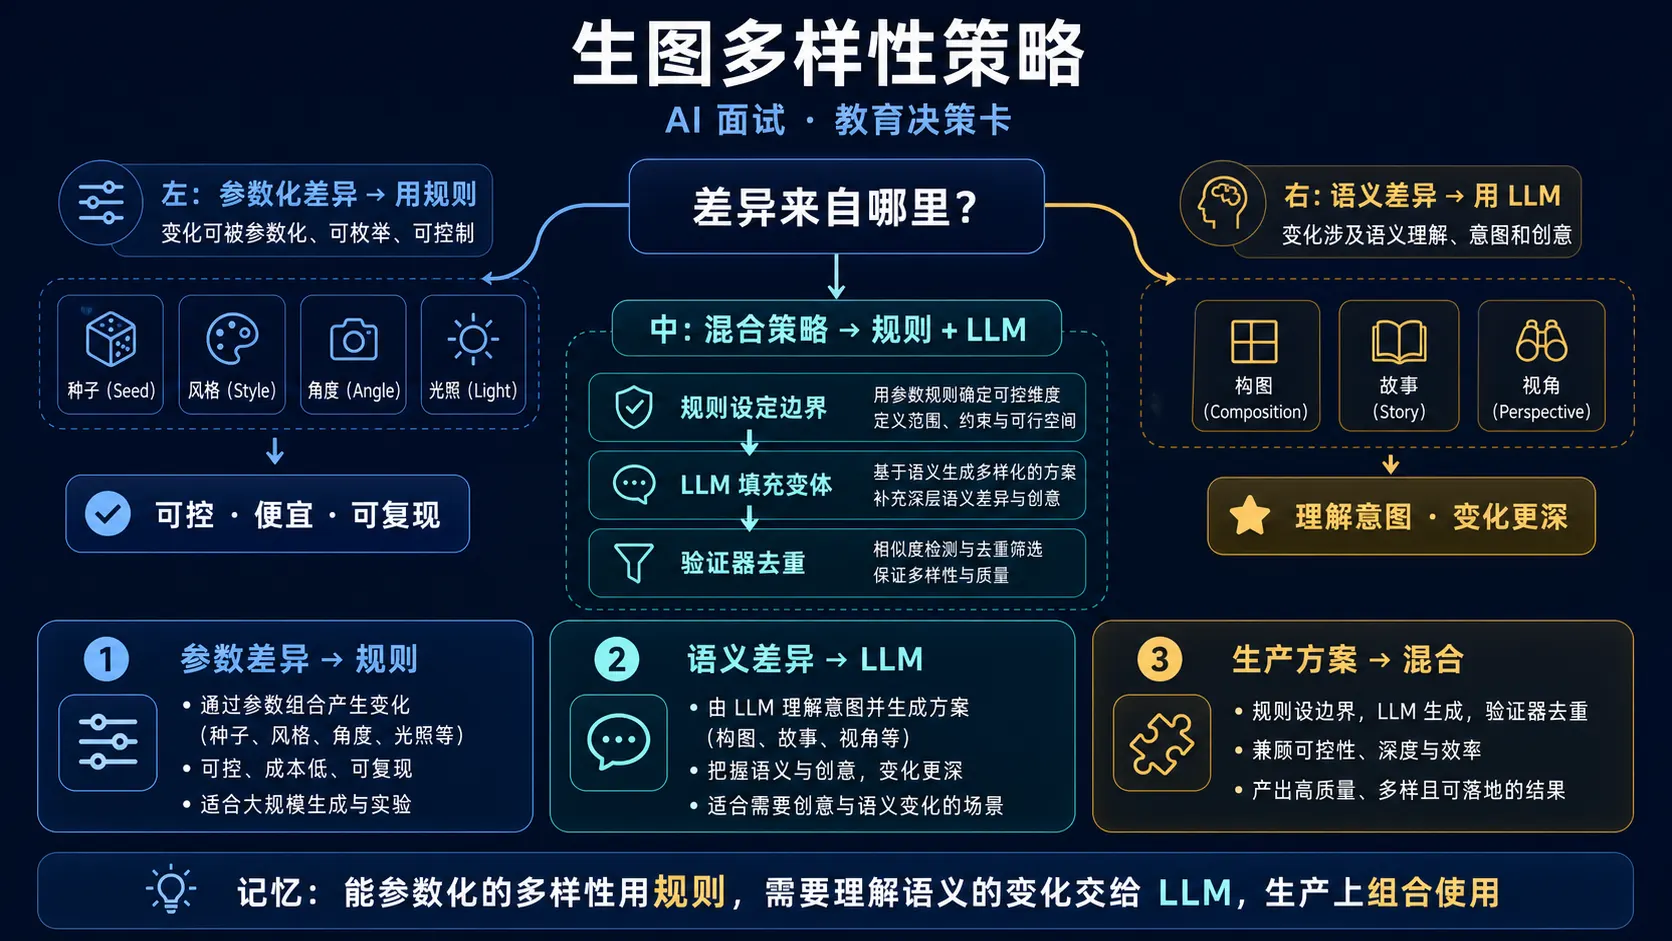
🧠 图解记忆: 参数化差异(Seed、风格、角度、光照)适合规则,语义级变化适合 LLM,生产中用规则定边界、LLM 造变体并去重验收。
💡 答案要点
两种方案对比:
| 方案 | 实现方式 | 优点 | 缺点 |
|---|---|---|---|
| 预设规则 | 固定参数组合(seed/风格/角度枚举) | 确定性强,可控,低成本 | 多样性有限,人工维护规则 |
| LLM 判断 | 让 LLM 生成差异化 Prompt | 多样性强,理解语义 | 成本高,结果不可预期 |
| 混合方案 | 规则框架 + LLM 局部变化 | 平衡可控性和多样性 | 实现复杂度中等 |
推荐:混合方案(工程实践)
展开 Python 代码示例(40 行)
class ImageDiversityStrategy:
    # 预设规则:控制结构化变量(确定性)
    STYLE_VARIANTS = ["realistic", "anime", "oil painting", "sketch"]
    ANGLE_VARIANTS = ["front view", "side view", "top view", "3/4 view"]
    LIGHTING_VARIANTS = ["studio lighting", "natural light", "dramatic lighting"]

    async def generate_diverse_set(
        self, base_description: str, count: int = 4
    ) -> list[str]:
        """生成多样性图像集合"""

        # 策略1:预设规则控制风格/角度(低成本,高可控)
        rule_variants = [
            f"{base_description}, {style}, {angle}"
            for style, angle in zip(
                self.STYLE_VARIANTS[:count],
                self.ANGLE_VARIANTS[:count]
            )
        ]

        # 策略2:LLM 生成语义差异化描述(高多样性)
        llm_variants = await self._llm_diversify(base_description, count)

        # 策略3:不同 Seed(同 Prompt 不同随机结果)
        seeds = [random.randint(0, 2**32) for _ in range(count)]

        return [
            await self.sd_client.generate(prompt=p, seed=s)
            for p, s in zip(llm_variants, seeds)
        ]

    async def _llm_diversify(self, description: str, count: int) -> list[str]:
        """LLM 生成语义差异化的 Prompt 变体"""
        response = await llm.complete(f"""
        基于以下描述,生成 {count} 个有显著差异的图像描述变体。
        要求:内容主题相同,但在构图、风格、角度、色调上有明显差异。
        原始描述:{description}
        输出 JSON 数组,每项是一个英文 SD Prompt。
        """)
        return json.loads(response)
判断标准(是否需要 LLM 介入):
简单多样性需求 → 预设规则(seed变换 + 参数组合)
语义差异化需求 → LLM 生成Prompt变体
内容连贯性需求 → LLM 全程控制(如故事板生成)
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "我们用混合策略:结构化的多样性(风格、角度、光线)用预设规则枚举,成本低且可控;语义层面的差异化(同一主题不同叙事视角)用 LLM 生成 Prompt 变体。判断规则是:如果多样性需求可以用参数描述,就用规则;如果需要理解语义意图,就用 LLM。生产中 80% 场景规则就够了。"
Q14: 如何评估生图准确性?
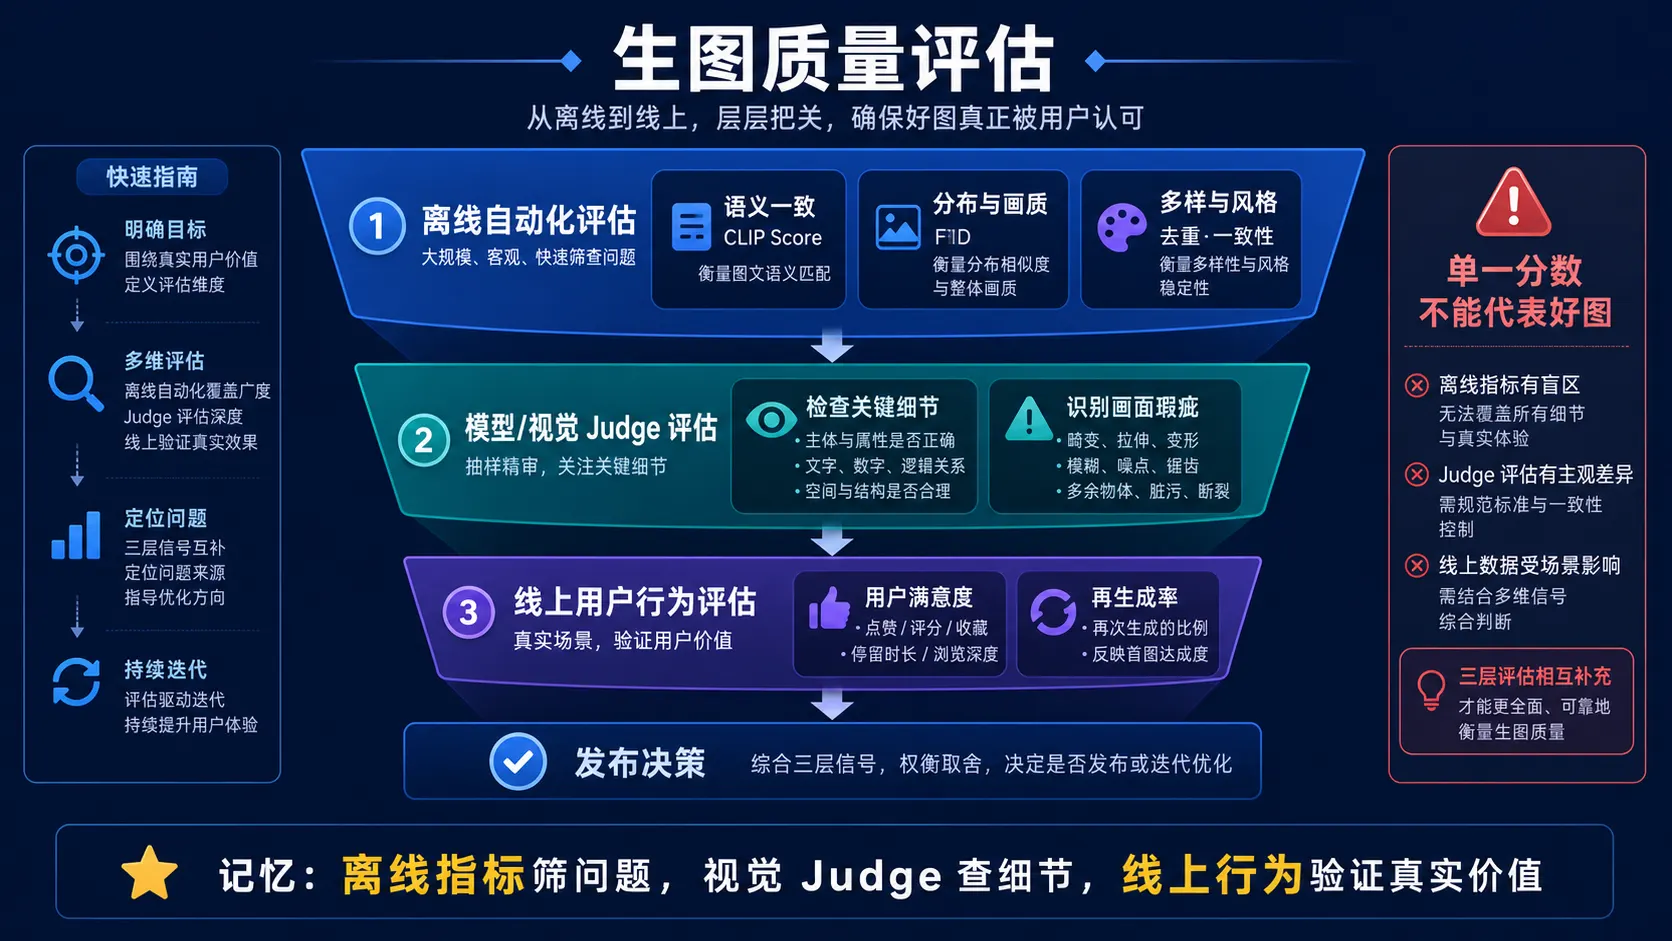
🧠 图解记忆: 生图质量不能靠单一分数:离线指标筛查语义与分布问题,视觉 Judge 检查细节,线上行为验证真实用户价值。
💡 答案要点
评估维度:
生图质量评估
├── 语义一致性:生成的图和文字描述匹配吗?
├── 视觉质量:图像清晰,无明显瑕疵?
├── 多样性:多次生成的结果差异够大?
└── 风格一致性:批量生成时风格统一?
定量指标:
| 指标 | 含义 | 计算方式 | 工具 |
|---|---|---|---|
| FID(Fréchet Inception Distance) | 生成图与真实图分布距离,越小越好 | 特征分布KL散度 | pytorch-fid |
| CLIP Score | 图文语义相似度(0-1,越高越好) | cos(CLIP图像特征, CLIP文本特征) | openai/clip |
| IS(Inception Score) | 图像质量+多样性综合 | Inception网络类别分布 | 较少用 |
| SSIM | 结构相似度(参考图对比) | 亮度+对比度+结构 | skimage |
工程实现:自动化评估管道
展开 Python 代码示例(51 行)
import torch
import clip
from PIL import Image

class ImageQualityEvaluator:
    def __init__(self):
        self.clip_model, self.preprocess = clip.load("ViT-B/32")

    def clip_score(self, image_path: str, prompt: str) -> float:
        """图文语义相似度 CLIP Score"""
        image = self.preprocess(Image.open(image_path)).unsqueeze(0)
        text = clip.tokenize([prompt])

        with torch.no_grad():
            image_feat = self.clip_model.encode_image(image)
            text_feat  = self.clip_model.encode_text(text)

        # 余弦相似度
        score = torch.cosine_similarity(image_feat, text_feat).item()
        return score  # 一般 0.25+ 认为语义匹配

    async def llm_judge(self, image_path: str, prompt: str) -> dict:
        """LLM 作为裁判进行多维评估"""
        response = await vision_llm.complete(
            image=image_path,
            text=f"""
            评估这张图片与描述的匹配程度。
            描述:{prompt}

            从以下维度打分(0-10):
            1. 语义匹配度:图像内容与描述是否一致
            2. 视觉质量:清晰度、色彩、构图
            3. 细节准确性:描述中的关键细节是否都体现

            输出JSON: {{"semantic": 0-10, "quality": 0-10, "detail": 0-10, "overall": 0-10}}
            """
        )
        return json.loads(response)

    def batch_evaluate(self, generations: list[dict]) -> dict:
        """批量评估,输出汇总报告"""
        scores = []
        for gen in generations:
            clip_s = self.clip_score(gen["image"], gen["prompt"])
            scores.append(clip_s)

        return {
            "avg_clip_score": sum(scores) / len(scores),
            "min_clip_score": min(scores),
            "pass_rate": sum(1 for s in scores if s > 0.25) / len(scores)
        }
实际评估体系(三层):
线下评估:FID + CLIP Score(自动化,CI/CD集成)
上线灰度:A/B 测试,真实用户满意度
线上监控:用户点赞/重新生成率(代理指标)
面试话术:
"生图评估应组合语义一致性、视觉质量、文本可读性、安全性和线上行为。CLIP Score 与 FID 只能衡量部分代理指标,阈值必须用本业务数据校准;视觉模型 Judge 也会有位置、风格和模型同源偏差,因此需要盲测人工抽检与失败案例集。"
应用
| 应用 | 技术选型 |
|---|---|
| 图文检索 | CLIP + 向量数据库 |
| 图像字幕 | BLIP / BLIP-2 |
| 视觉问答 | BLIP-2 + LLM |
| 多模态 RAG | CLIP检索 + GPT-4V生成 |
| LLaVA | CLIP+MLP+LLaMA,两阶段训练(对齐+指令) |
📝 更新记录
| 日期 | 更新内容 |
|---|---|
| 2026-04-15 | 新增 Q16 Gemma 4(Google DeepMind 2026年4月发布,PLE/Shared KV Cache/MoE架构,端侧多模态突破) |
| 2026-03-05 | 新增多模态大模型面试题 8 道 |
八、Vision-Language Agent 评估
Q15: 如何系统评估 Vision-Language Agent?MMLU-Pro、MathVista、ChartQA、DocVQA 等基准测试各测什么?2026年有哪些新方向?
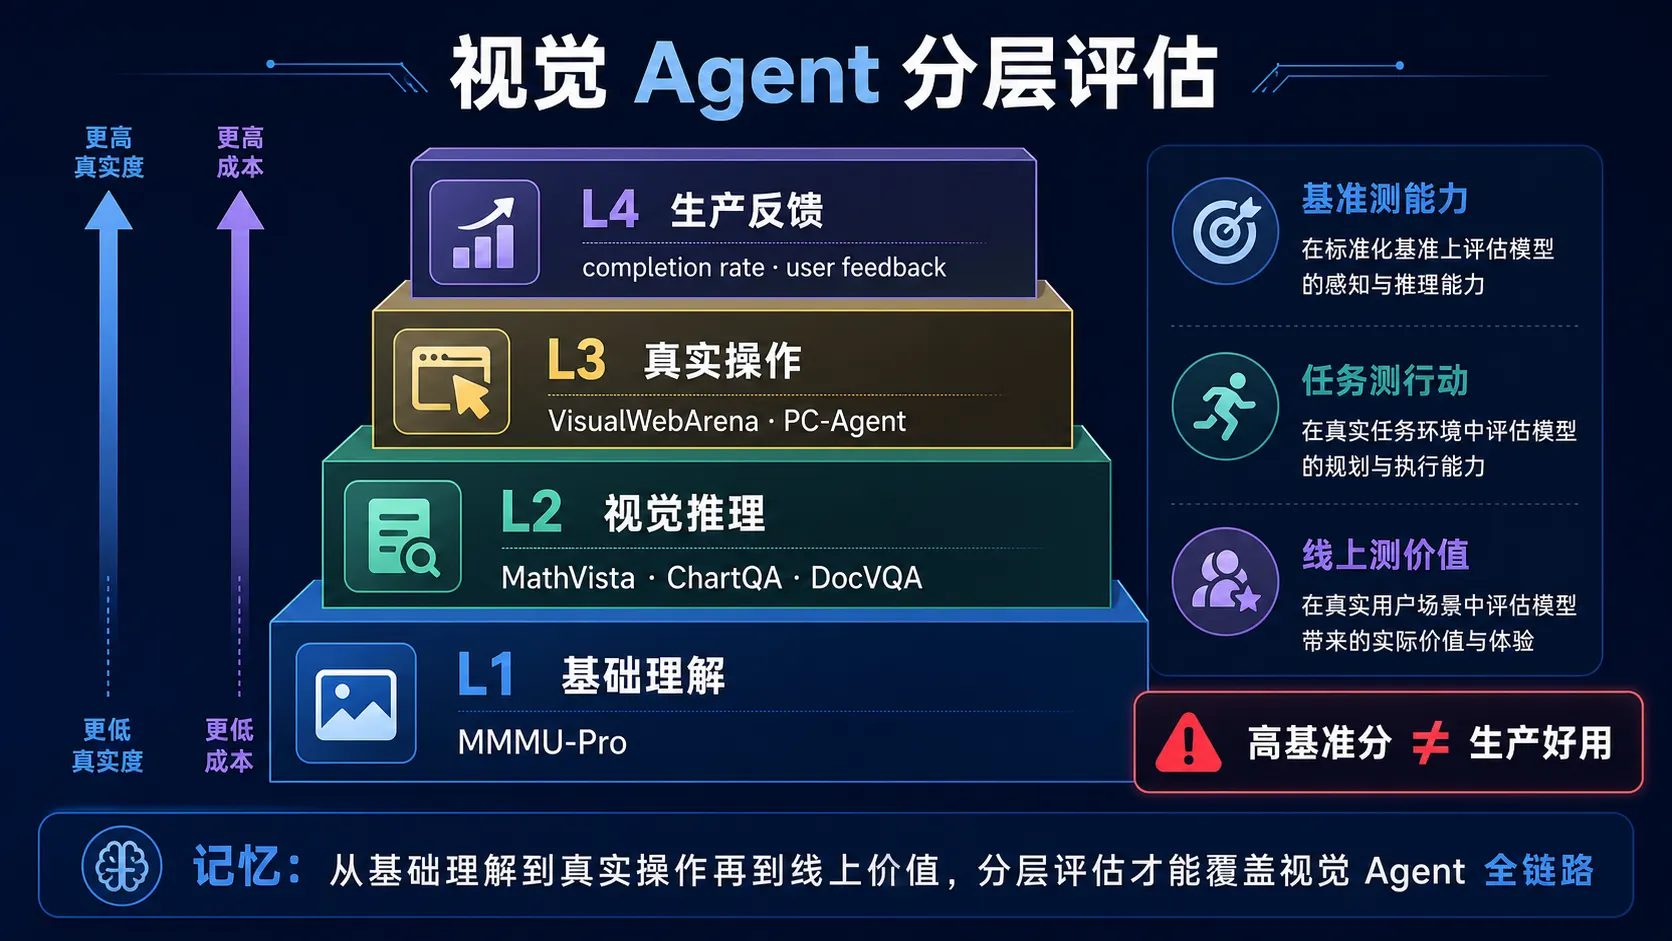
🧠 图解记忆: 视觉 Agent 要从基础理解、视觉推理、真实操作到生产反馈分层评测;Benchmark 高分只是必要条件,不等于生产可用。
💡 答案要点
2026年 Vision-Language Agent 评估格局:
┌─────────────────────────────────────────────────────┐
│     Vision-Language Agent 评估体系                  │
├─────────────────────────────────────────────────────┤
│                                                     │
│  基础视觉理解(通用)                                │
│  ├─ MMMU-Pro:多模态理解基准(大学水平知识)        │
│  ├─ MMBench:多模态理解(选择题为主)               │
│  └─ SeedBench:指令跟随 + 视觉理解                  │
│                                                     │
│  视觉推理(Reasoning)                              │
│  ├─ MathVista:数学视觉推理                        │
│  ├─ ChartQA:图表理解与推理                        │
│  └─ VQA v2:日常视觉问答                           │
│                                                     │
│  文档/结构化理解(专业)                            │
│  ├─ DocVQA:文档理解(OCR+理解)                   │
│  ├─ InfoVQA:信息图理解                            │
│  └─ TableVQA:表格理解                              │
│                                                     │
│  Agent 能力(真实任务)                             │
│  ├─ VisCoord:视觉坐标推理                        │
│  ├─ VisualWebArena:网页视觉 Agent                │
│  └─ PC-Agent:计算机操作 Agent                      │
│                                                     │
└─────────────────────────────────────────────────────┘
MMLU-Pro(Massive Multidisciplinary Multimodal Reasoning):
"MMLU-Pro 是 2026 年最重要的多模态基准,测试模型在大学水平知识的多模态理解能力。区别于原版 MMLU(纯文本),MMLU-Pro 要求模型同时理解文本+图像来完成问答。"
| 维度 | 说明 |
|---|---|
| 测试内容 | 物理、化学、生物、历史、法律、医学等大学学科 |
| 题目类型 | 选择题(含图表、公式、实验结果图) |
| 难度 | 大学水平,需要图文联合推理 |
| 评分 | Accuracy(准确率) |
| 2026年 Leaderboard | GPT-4.5领先,Claude 3.7 Sonnet 紧随其后 |
MathVista(数学视觉推理):
"MathVista 测试 AI 的'视觉数学推理'能力——不是单纯的计算,而是要看图推理。比如看一个几何图形证明题、看一张数据图表回答问题。"
| 维度 | 说明 |
|---|---|
| 测试内容 | 几何、代数、统计、图表推理 |
| 题目来源 | 数学教科书、竞赛题、研究论文中的图表 |
| 难点 | 需要同时理解视觉结构 + 数学符号 + 逻辑推理 |
| 评分指标 | Accuracy + Pass@k(多步推理) |
# MathVista 评估示例
def evaluate_mathvista(model, testset):
    """评估模型在 MathVista 上的表现"""
    correct = 0
    total = len(testset)

    for item in testset:
        # 输入:图片 + 数学问题
        image = item["image"]  # 几何图形/图表
        question = item["question"]  # "求证平行四边形对角相等"

        # 模型回答
        answer = model.generate(
            image=image,
            question=question,
            reasoning="step-by-step"  # 要求展示推理过程
        )

        if answer == item["ground_truth"]:
            correct += 1

    return {
        "accuracy": correct / total,
        "benchmark": "MathVista"
    }
ChartQA(图表理解):
"ChartQA 测试模型理解和推理常见图表的能力——柱状图、折线图、饼图。要求不仅能'看懂',还要能推理变化趋势、计算增长率、比较大小。"
| 维度 | 说明 |
|---|---|
| 图表类型 | 柱状图、折线图、饼图、混合图 |
| 问题类型 | 描述性(什么最高)、比较性(增长多少)、推理性(为什么) |
| 难度 | 需要数值计算 + 视觉定位 + 逻辑推理 |
| 评分 | Relaxed Accuracy(允许近似值) |
DocVQA(文档理解):
"DocVQA 测试 AI 理解和回答关于文档内容的问题能力。典型场景:给 AI 一份 PDF 合同或发票,问'这份合同的总金额是多少'。"
| 维度 | 说明 |
|---|---|
| 文档类型 | 发票、合同、表单、报告、技术文档 |
| 能力 | OCR + 版面理解 + 文本理解 + 问答 |
| 难点 | 多页文档、长表格、混合语言、手写体 |
| 评估指标 | ANLS(Average Normalized Levenshtein Similarity) |
展开 Python 代码示例(34 行)
# DocVQA 生产级评估 Pipeline
def evaluate_docvqa(documents, questions):
    """
    生产环境 DocVQA 评估流程
    """
    results = []

    for doc in documents:
        # 1. 文档预处理
        pages = parse_document(doc)  # PDF → 图片页
        ocr_text = extract_text(pages)  # OCR 提取文本

        # 2. 多页检索
        relevant_pages = retrieve_relevant_pages(
            question, pages, top_k=3
        )

        # 3. 生成答案
        answer = multimodal_llm.generate(
            images=relevant_pages,
            context=ocr_text,
            question=question
        )

        # 4. 评分(允许数值近似)
        score = normalized_levenshtein_similarity(
            answer, ground_truth
        )
        results.append(score)

    return {
        "anls": np.mean(results),
        "coverage": len(results) / len(documents)
    }
2026年新方向:PC-Agent + VisualWebArena
| 基准 | 测试场景 | 核心能力 |
|---|---|---|
| PC-Agent | 操作电脑(点击、拖拽、输入) | 视觉坐标理解 + 动作序列规划 |
| VisualWebArena | 网页导航 + 信息提取 | 视觉理解 + GUI 操作 |
| VisualWebBench | 网页多模态问答 | 视觉理解 + 知识推理 |
评估策略:分层评估
┌─────────────────────────────────────────────────────┐
│         分层评估策略                               │
├─────────────────────────────────────────────────────┤
│                                                     │
│  L1: 基础能力(自动评估)                           │
│  ├─ MMMU-Pro、ChartQA、DocVQA(Benchmark 分数)     │
│  └─ 自动化,可 CI/CD 集成                           │
│                                                     │
│  L2: 推理能力(人工抽样)                           │
│  ├─ MathVista(推理步骤检查)                       │
│  └─ 抽样 5%,人工复核                               │
│                                                     │
│  L3: Agent 能力(真实任务)                         │
│  ├─ PC-Agent(计算机操作)                          │
│  ├─ VisualWebArena(网页操作)                     │
│  └─ 端到端评测,模拟真实用户场景                    │
│                                                     │
│  L4: 生产监控(持续采集)                           │
│  ├─ 用户满意度 + 任务完成率 + 重新生成率            │
│  └─ 线上指标,真实反馈                              │
│                                                     │
└─────────────────────────────────────────────────────┘
面试话术:
"Vision-Language Agent 评估不是跑一个 benchmark 就完了。2026年的评估体系是分层的:L1 用 MMMU-Pro、ChartQA 自动评分,快速迭代;L2 用 MathVista 抽样人工复核推理质量;L3 用 PC-Agent、VisualWebArena 做端到端真实任务;L4 用生产数据监控真实满意度。我的经验是'基准分数是必要条件,不是充分条件'——基准分数高不代表生产好用,所以一定要有 L3 的真实任务评估和 L4 的线上监控。"
延伸阅读:
- MMLU-Pro: https://mmmu-pro.github.io/
- MathVista: https://mathvista.github.io/
- DocVQA: https://www.docvqa.org/
版本: v3.2 | 更新: 2026-05-09 | by 二狗子 🐕
九、全模态模型案例
Q16: Qwen3.5-Omni 是什么?Thinker-Talker 架构和 Hybrid-Attention MoE 有何创新?为什么"全模态"是2026年的重要方向?
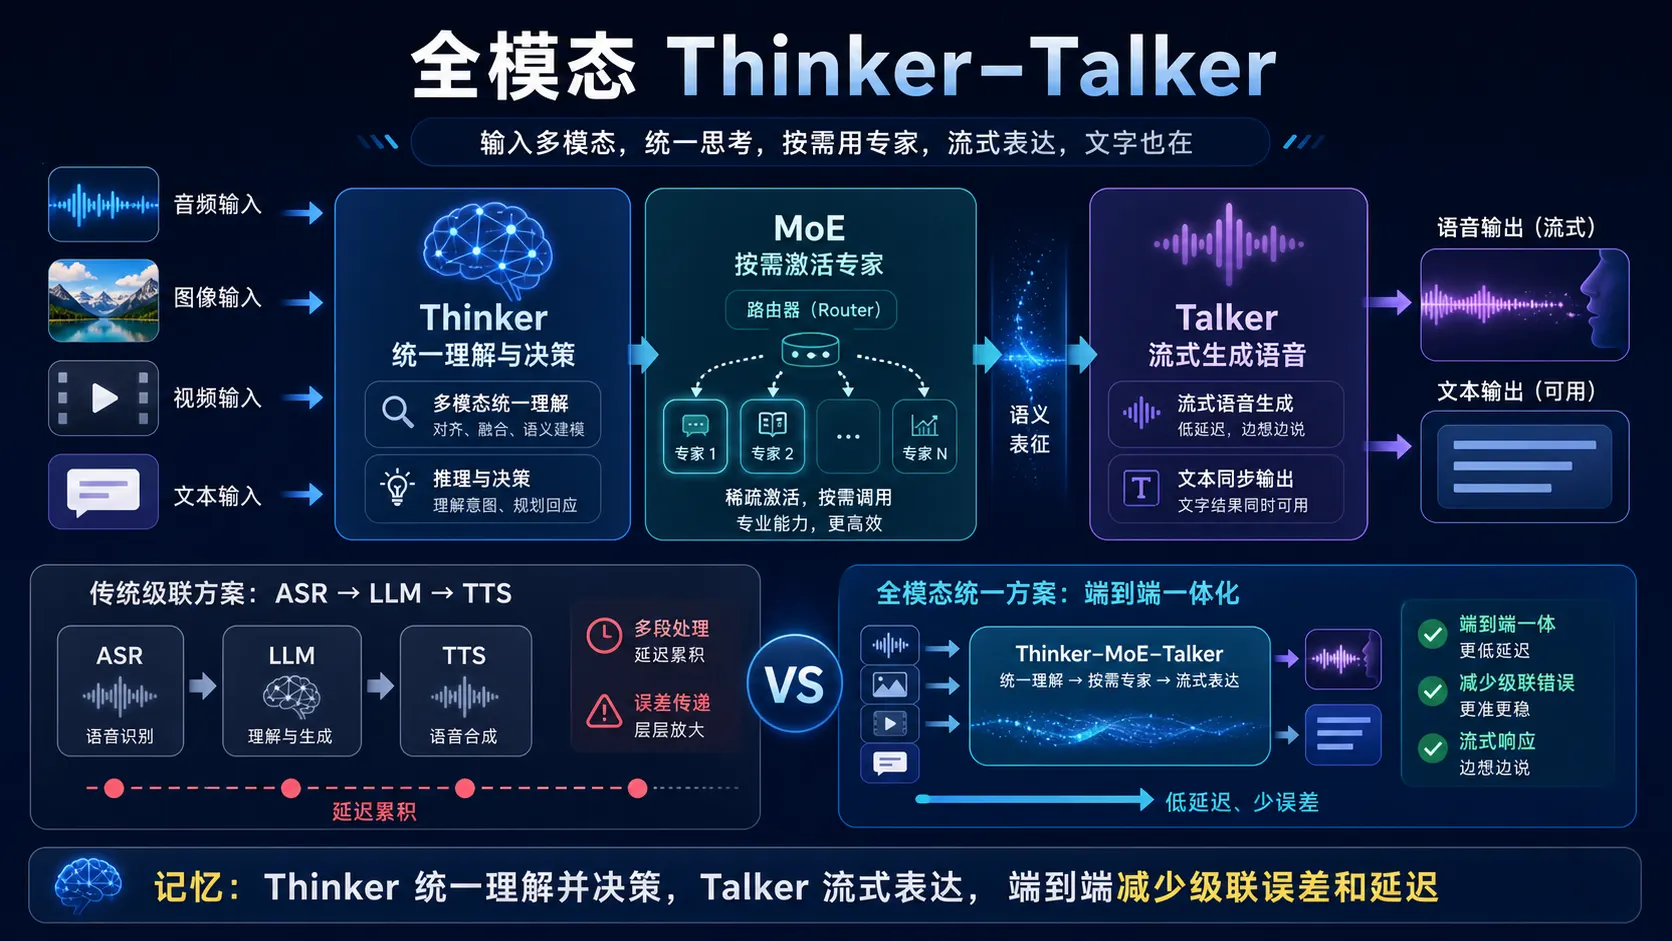
🧠 图解记忆: Thinker 统一处理多模态并做推理决策,MoE 按需激活专家,Talker 流式表达,从而减少 ASR→LLM→TTS 级联的延迟与误差。
💡 答案要点
全模态(Omni-modal)vs 多模态(Multi-modal)
| 概念 | 定义 | 代表模型 |
|---|---|---|
| 多模态 | 分别处理不同模态,然后融合 | GPT-4o(图像+文本) |
| 全模态 | 单一模型原生理解所有模态 | Qwen3.5-Omni(文本+图像+音频+视频) |
"多模态是'拼图',全模态是'一张画布上直接画'"
Qwen3.5-Omni 核心数据(截至2026年3月30日):
| 指标 | 数据 |
|---|---|
| 参数规模 | ~400B(MoE架构) |
| 支持的模态 | 文本、图像、音频、视频 |
| 上下文窗口 | 256k tokens(10小时音频/400秒视频) |
| Benchmark SOTA | 215项任务SOTA |
| 音频理解 | 超越 Gemini-3.1 Pro |
| 支持的语音 | 113种语言识别 / 36种语言合成 |
Thinker-Talker 架构详解:
┌─────────────────────────────────────────────────────┐
│         Qwen3.5-Omni Thinker-Talker 架构            │
├─────────────────────────────────────────────────────┤
│                                                      │
│  Thinker(思考者)                                   │
│  ├── 角色:多模态理解 + 推理决策                       │
│  ├── 输入:文本、图像、音频、视频                       │
│  └── 输出:语义表示 + 语音单元                         │
│                                                      │
│  Talker(说话者)                                     │
│  ├── 角色:流式语音合成                               │
│  ├── 输入:Thinker的表示                              │
│  ├── 输出:实时语音流                                 │
│  └── 特点:streaming设计,低延迟                     │
│                                                      │
│  关键创新:ARIA技术                                   │
│  ├── 动态对齐文本和语音单元                           │
│  ├── 流式解码时不停顿                                 │
│  └── 语音自然度和鲁棒性大幅提升                        │
└─────────────────────────────────────────────────────┘
Hybrid-Attention MoE 设计:
# Qwen3.5-Omni MoE 核心思想
# MoE = Mixture of Experts(专家混合)
# Hybrid-Attention = 在MoE中引入注意力机制

# 传统MoE:每个token只激活少数专家(稀疏)
# Qwen3.5-Omni Hybrid-Attention MoE:
# - Thinker和Talker都使用MoE架构
# - 每个token选择性地激活多个专家
# - 注意力在专家选择中起辅助路由作用

# 效果:
# 1. 推理效率大幅提升(只激活部分参数)
# 2. 多模态理解能力更强(不同专家处理不同模态)
# 3. 保持了模型容量(总参数大,但推理成本低)
与 Gemini 3.1 Pro 的对比:
| 维度 | Qwen3.5-Omni-Plus | Gemini-3.1-Pro |
|---|---|---|
| 架构 | Thinker-Talker + MoE | 单一统一模型 |
| 模态 | 文本+图像+音频+视频 | 文本+图像+音频+视频 |
| 上下文 | 256k tokens | 1M tokens |
| 音频SOTA | ✅ 215项 | 部分领先 |
| 开源 | ✅ 开源权重 | ❌ 闭源 |
| 中文支持 | ✅ 原生优化 | 一般 |
为什么全模态对 Agent 重要:
传统多模态 Agent 架构:
音频 → ASR模型 → 文本 → LLM → 文本 → TTS → 语音
图像 → CV模型 → 描述 → LLM → ... → 输出

问题:
1. 每个模型有独立误差
2. 延迟累加(多步处理)
3. 模态间语义可能不一致

全模态 Agent 架构:
音频+图像+文本+视频 → [Qwen3.5-Omni] → 文本+流式语音
                         ↑ 单一模型原生理解
优势:
1. 消除模态间误差
2. 端到端优化
3. 真正的跨模态推理
面试话术:
"Qwen3.5-Omni 是阿里巴巴2026年3月发布的全模态模型,核心创新是 Thinker-Talker 架构——Thinker 负责多模态理解和推理,Talker 负责流式语音生成,两者通过 ARIA 技术动态对齐。最让我震撼的数据是它在 215 项任务上达到 SOTA,包括音频理解超越 Gemini-3.1 Pro。这意味着 2026 年的 Voice Agent 不再需要 ASR→LLM→TTS 的级联架构,可以用单一全模态模型端到端处理语音对话,延迟更低、误差更小。对于 AI 应用开发工程师来说,理解全模态和级联多模态的区别是 2026 年的必备知识。"
Q17: NVIDIA Nemotron 3 Nano Omni 是什么?为什么"端侧全模态"是2026年的重要方向?
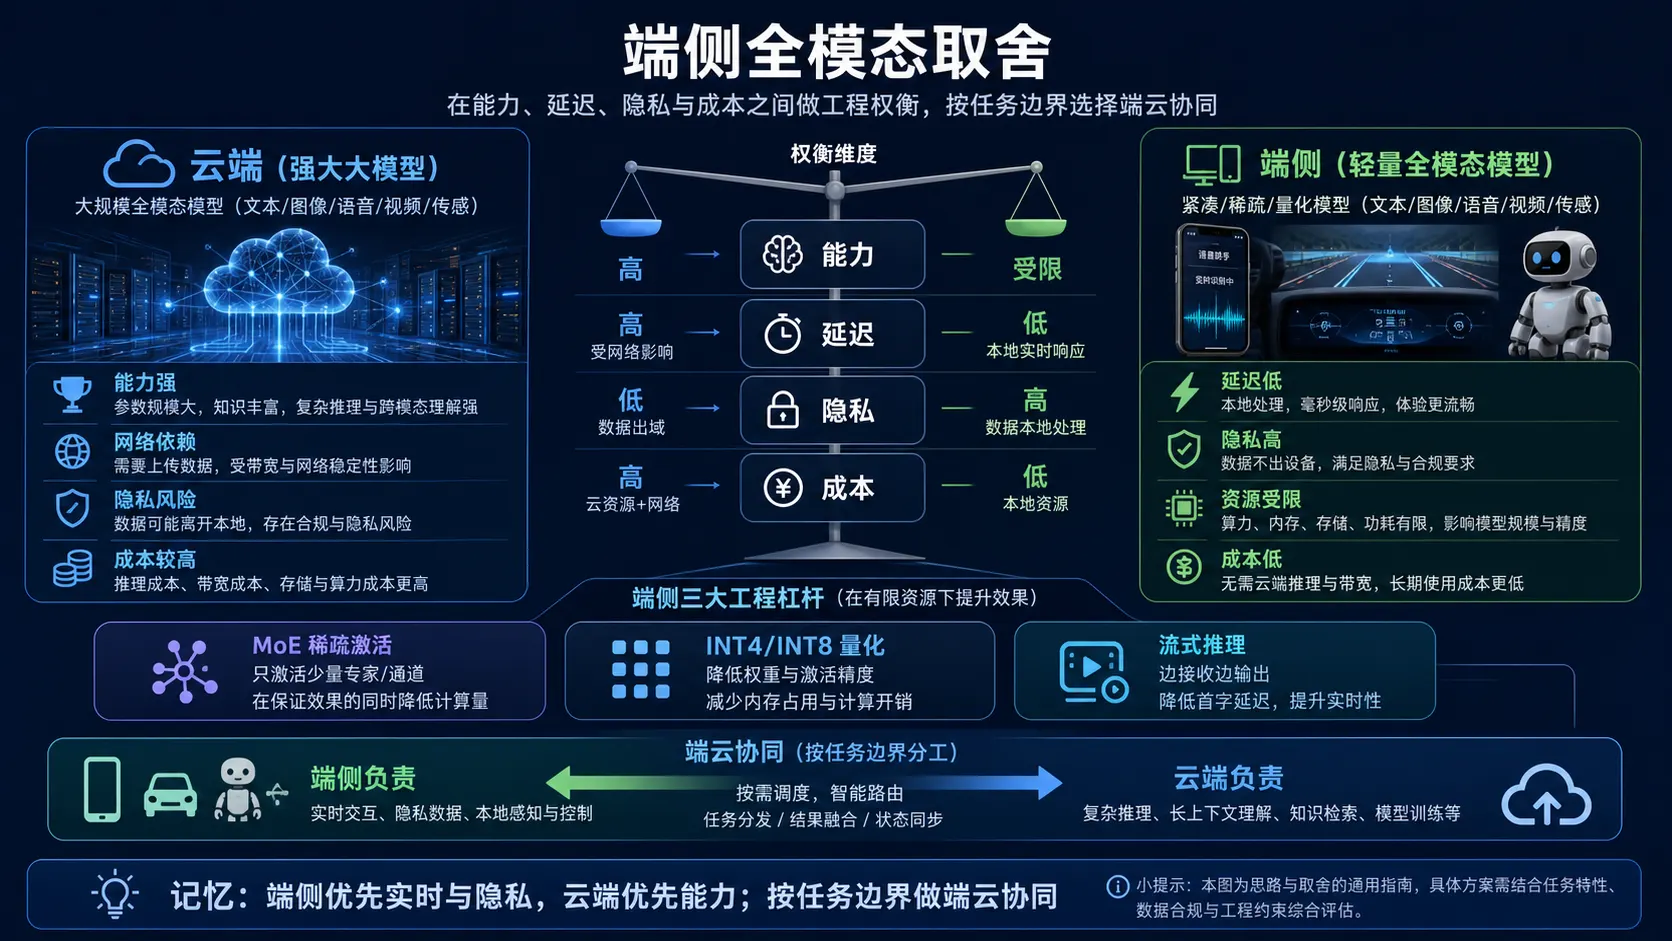
🧠 图解记忆: 端侧优先实时、隐私与离线可用,云端优先复杂任务能力;通过量化、稀疏激活和模型路由实现端云协同。
💡 答案要点
为什么需要端侧全模态?
| 场景 | 需求 |
|---|---|
| 手机端 Agent | 不能依赖云端API,本地实时响应 |
| 车载交互 | 网络不稳定,需要本地处理 |
| 隐私敏感 | 医疗/金融对话不能上云 |
| 机器人 | 实时视觉+语音+文本推理 |
Nemotron 3 Nano Omni 核心数据:
| 指标 | 数据 |
|---|---|
| 参数规模 | 30B(Hybrid MoE) |
| 支持的模态 | 文本+图像+视频+音频 |
| 架构 | 统一单模型(非级联) |
| 定位 | 端侧/边缘部署 |
与 Qwen3.5-Omni 的核心区别:
| 维度 | Nemotron 3 Nano Omni | Qwen3.5-Omni |
|---|---|---|
| 规模 | 30B(小而精) | 400B(大而全) |
| 部署 | 端侧/本地 | 云端/数据中心 |
| 目标 | 本地实时推理 | 云端最强性能 |
| 开源 | ✅ 开源 | ✅ 开源 |
端侧全模态的技术挑战:
挑战1:模型压缩
- 400B → 30B,精度损失如何控制?
- 答案:MoE架构(稀疏激活)+ 量化(INT4/INT8)

挑战2:多模态融合
- 视觉、语音、文本如何在小型模型中统一?
- 答案:统一token化(所有模态转成token序列)

挑战3:实时性
- 端侧GPU算力有限
- 答案:streaming设计 + 轻量级Talker
生产级应用场景:
# 端侧全模态 Agent 典型场景
scenarios = {
    "手机助手": "本地语音+摄像头+屏幕理解,不上云",
    "车载IVI": "驾驶时语音指令+视线检测,本地低延迟",
    "智能眼镜": "第一视角视频+语音,本地处理保护隐私",
    "家庭机器人": "实时视觉+语音对话,本地响应"
}
面试话术:
"NVIDIA Nemotron 3 Nano Omni 的核心价值是'让全模态 Agent 跑在端侧'。30B 参数、Hybrid MoE 架构、统一多模态理解,这些都是为了解决一个问题——在不依赖云端的情况下,实现实时多模态推理。2026 年我认为会看到两极分化:云端用 Qwen3.5-Omni 这样的大模型追求最强性能;端侧用 Nemotron 这样的模型追求实时性和隐私。对于 AI 应用开发工程师,理解这个趋势很重要——不是所有东西都要上云,端侧全模态打开了新的产品可能性,比如离线语音助手、本地视觉 Agent、私密对话机器人。"
Q18: 如何用模型路由设计低延迟多模态 Agent?
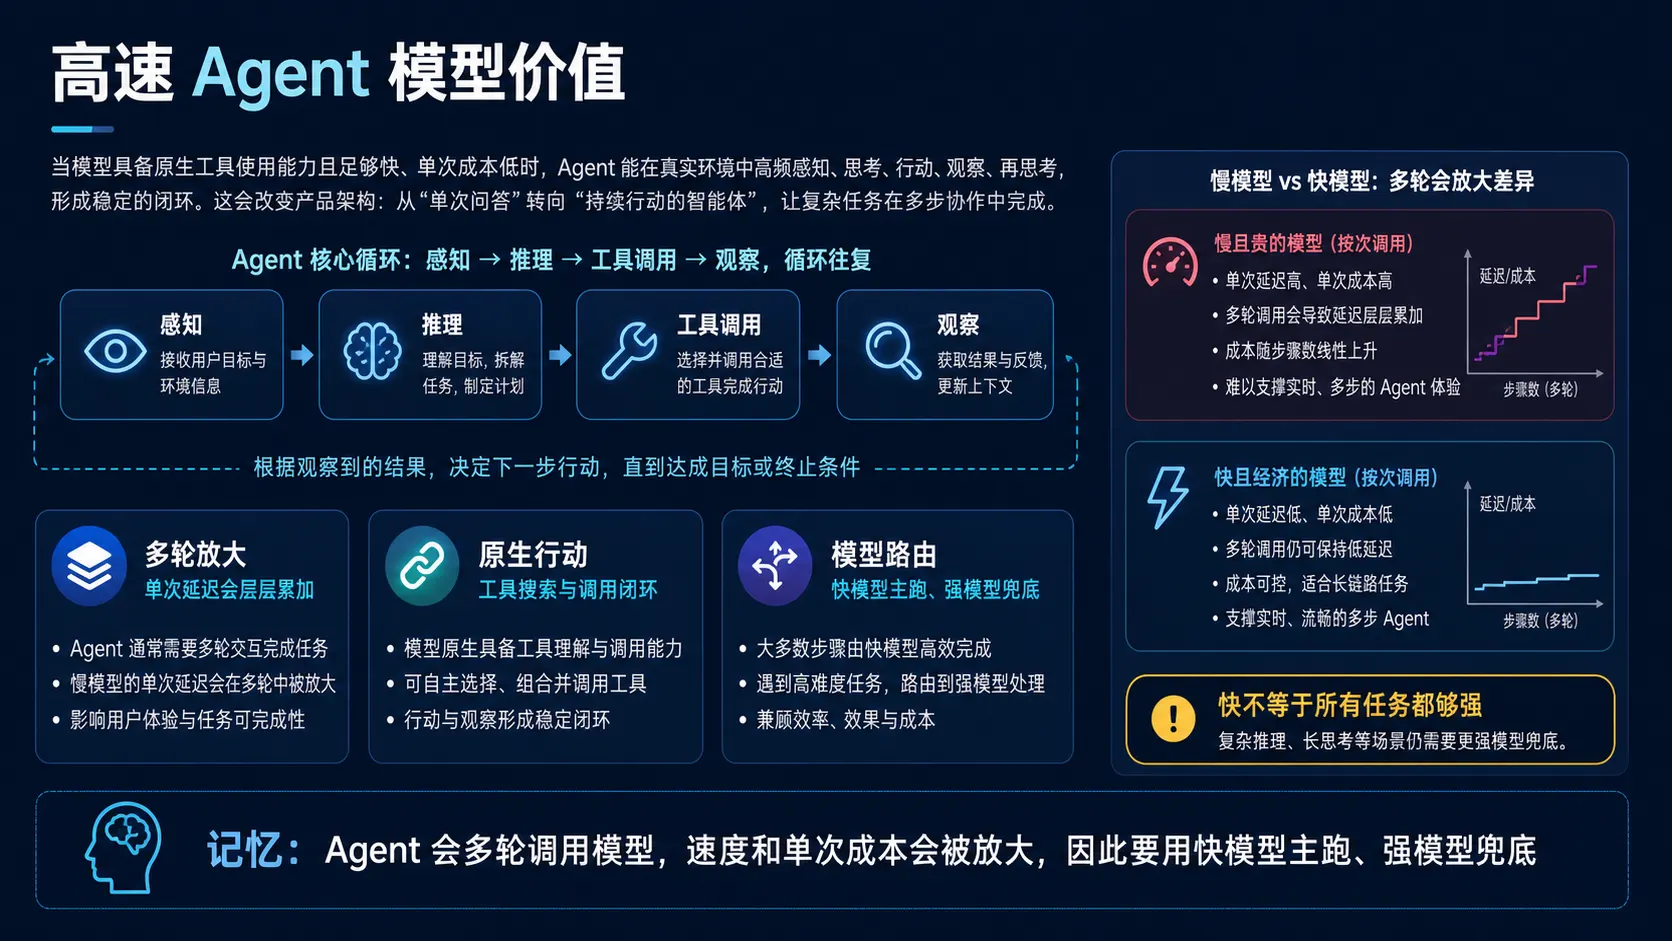
🧠 图解记忆: Agent 会多轮调用模型,单次延迟和成本会被循环放大,所以应让快模型承担主流程、强模型处理少数高难步骤。
💡 答案要点
为什么需要路由:
多模态 Agent 往往包含感知、意图判断、工具选择、工具执行和结果生成,多次模型调用会把单次延迟和成本累加。合理做法不是默认全部调用最强模型,而是按步骤风险和难度路由。
| 步骤 | 常见策略 | 不能省略的保护 |
|---|---|---|
| VAD、OCR、分类、简单抽取 | 专用模型或低延迟模型 | 置信度、输入质量检测 |
| 普通对话与工具参数生成 | 快模型承担主流程 | Schema 校验、权限和超时 |
| 复杂视觉推理或高风险决策 | 路由到更强模型或人工 | 证据、复核、审计日志 |
| 连续音视频 | 流式/增量处理 | 背压、打断、帧采样和状态同步 |
路由依据:
- 输入模态、长度、分辨率和实时性要求;
- 任务复杂度、模型置信信号与历史失败模式;
- 决策风险、可逆性和是否允许人工接管;
- 模型在自有数据上的质量、TTFT、端到端 P95/P99 与单任务成本。
面试话术:
"低延迟多模态 Agent 的关键是端到端预算和分层路由。先把感知、决策、工具和生成各阶段的耗时拆开,让专用或快速模型处理高频低风险步骤,复杂或高风险样本升级到强模型或人工。路由器要有可解释规则、质量回归集和降级路径,并用真实会话测任务成功率、打断响应、P95/P99 和成本,而不是直接照搬厂商给出的单模型速度倍数。"