📝 简历与面试技巧
面试优先顺序(通用 AI 应用开发岗位):Q1、Q2、Q3、Q4、Q7、Q9、Q10、Q13、Q14。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
真实性优先: 文中的数字是格式示例,不是建议照抄的“漂亮结果”。简历只填写本人能说明数据来源、基线、样本量、评测方法和职责边界的成果;没有正式项目时可以写可复现的个人项目或设计练习,但必须如实标注。
难度: ⭐⭐⭐ 考点: 简历撰写、面试准备、谈薪技巧、职业规划
📋 目录
📋 简历撰写技巧
Q1: AI 应用工程师简历应该突出什么?
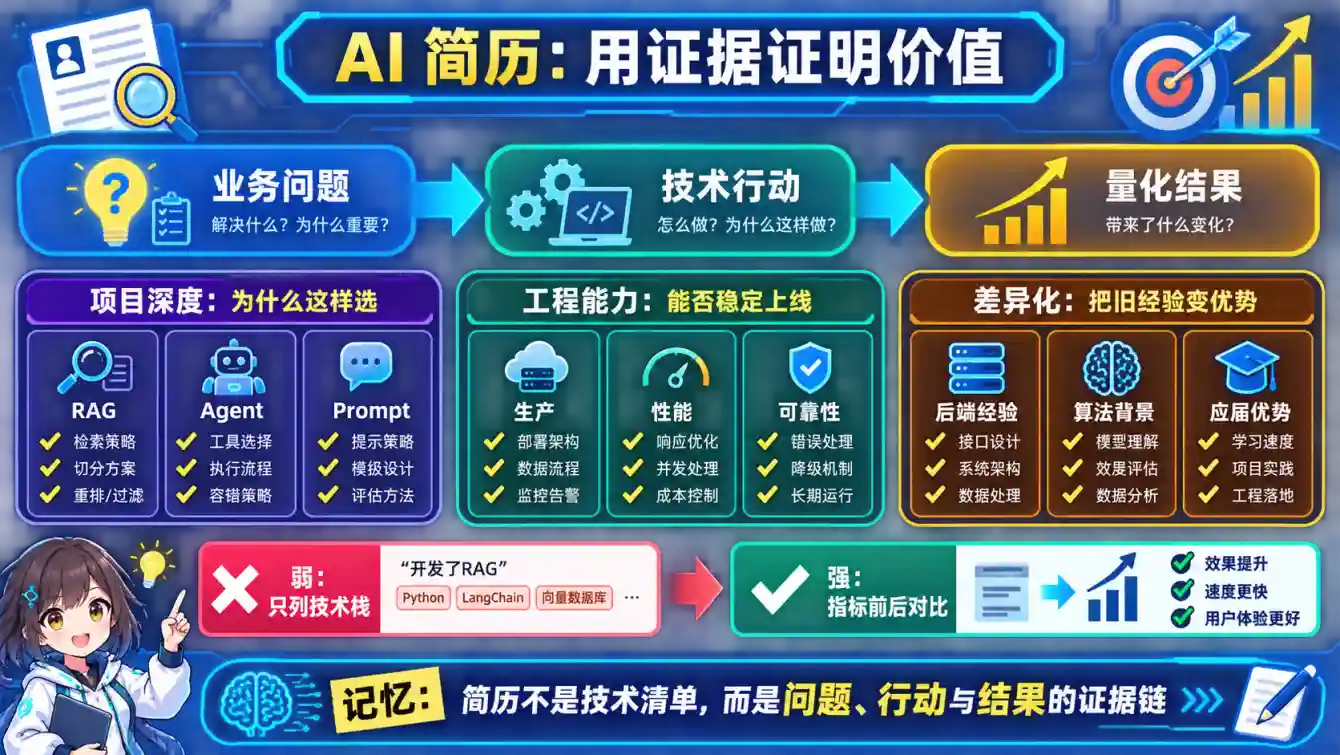
🧠 图解记忆: 简历不是技术栈清单,要用业务问题、关键行动和量化结果证明项目深度与工程能力。
💡 答案要点
核心原则:量化成果 + 技术深度
必备模块:
项目经验(最重要)
- RAG 系统:检索准确率、响应时间、用户满意度
- Agent 应用:任务完成率、工具调用准确率
- Prompt 工程:优化前后的效果对比
技术栈
- LLM:GPT-4、Claude、国产大模型经验
- 框架:LangChain、LlamaIndex、Dify
- 向量库:Milvus、Chroma、pgvector
- 编程语言:Python、Go、Java
量化指标
❌ 差:开发了一个 RAG 系统
✅ 好:构建 RAG 系统,检索准确率 85%→92%,响应时间 2s→500ms

❌ 差:优化了 Prompt
✅ 好:设计 CoT Prompt,任务完成率从 60% 提升到 85%
差异化优势
- 传统开发转 AI:强调工程能力、系统设计、性能优化
- 算法转 AI 应用:强调落地能力、产品思维、用户需求理解
- 应届生:强调学习能力、项目经验、技术热情
Q2: 如何描述 AI 项目经验?
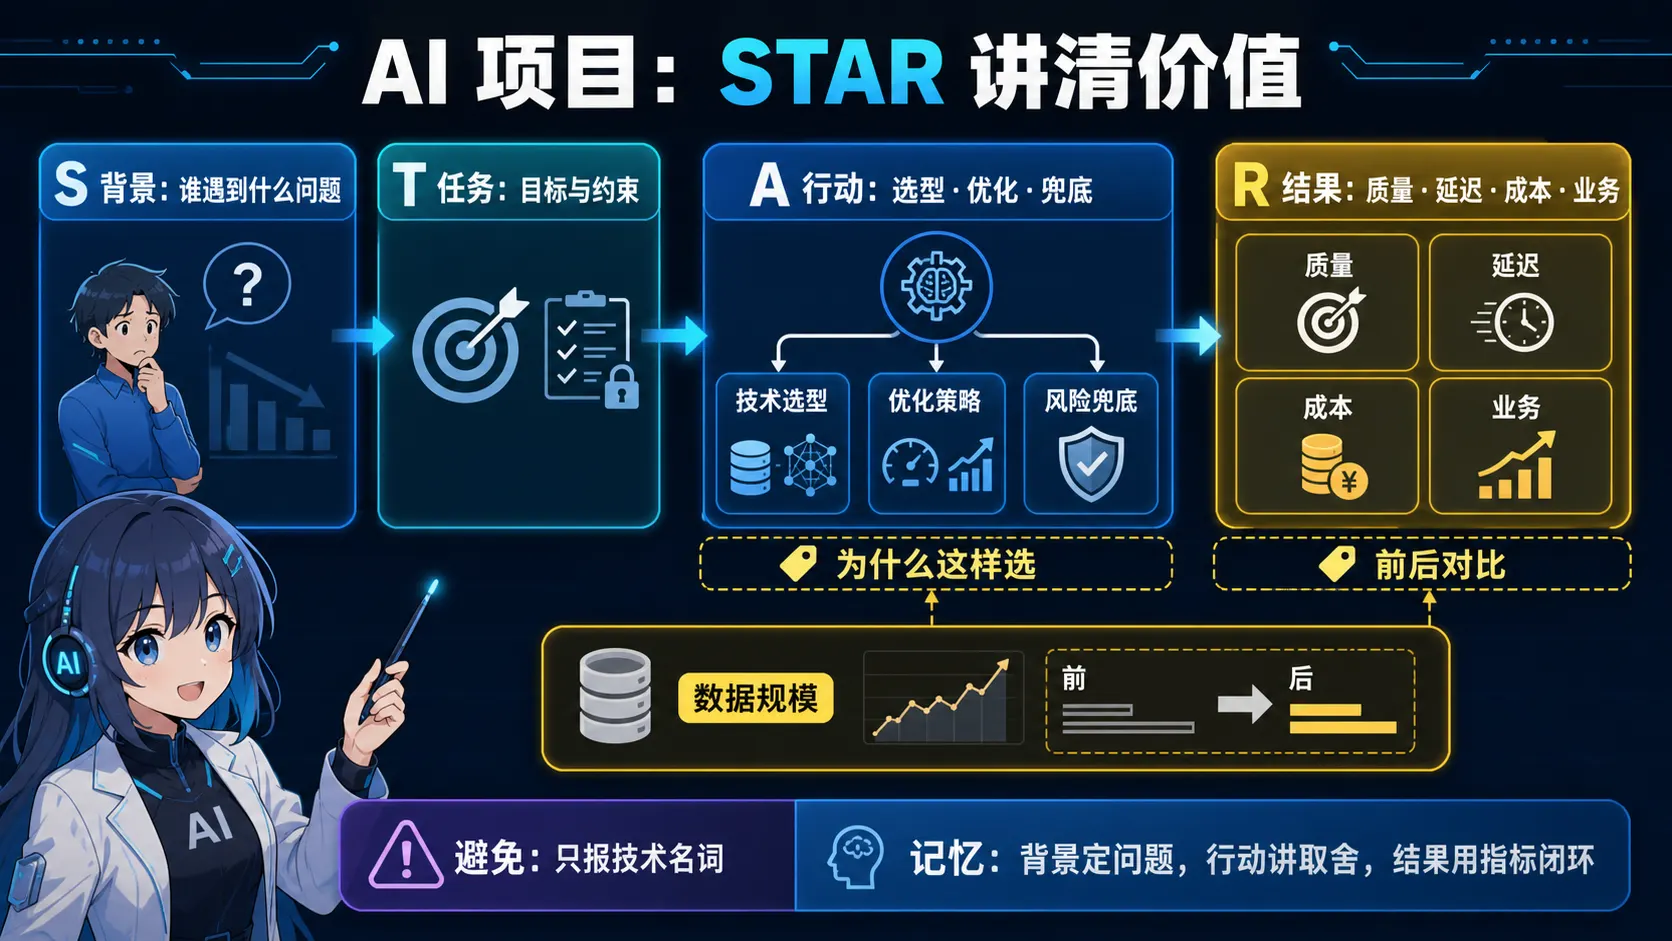
🧠 图解记忆: 用背景和任务定义问题,在行动中讲清选型、优化与兜底,再用质量、延迟、成本和业务指标闭环。
💡 答案要点
STAR 法则:Situation - Task - Action - Result
示例 1:RAG 系统
【背景】公司知识库有 10w+ 文档,员工查询效率低
【任务】构建 RAG 系统,提升知识检索效率
【行动】
- 使用 BGE-M3 模型生成向量,存储到 Milvus
- 实现混合检索:BM25 + 向量检索,rerank 优化
- 设计上下文压缩策略,减少 token 消耗 40%
【结果】检索准确率 92%,响应时间 500ms,用户满意度 4.5/5
示例 2:Agent 系统
【背景】客服团队每天处理 5000+ 重复性咨询
【任务】构建 AI 客服 Agent,减少人工成本
【行动】
- 设计 ReAct 框架,集成知识库、订单查询、退款等工具
- 实现多轮对话管理,上下文记忆机制
- 设计人工介入策略,复杂问题自动转人工
【结果】自动解决率 70%,客服成本降低 60%,用户满意度持平
关键点:
- 数据量级(10w 文档、5000 咨询)
- 技术选型(BGE-M3、ReAct、Milvus)
- 优化策略(混合检索、上下文压缩、人工介入)
- 量化结果(92% 准确率、70% 自动解决率)
🎯 面试准备策略
Q3: AI 应用工程师面试一般考什么?
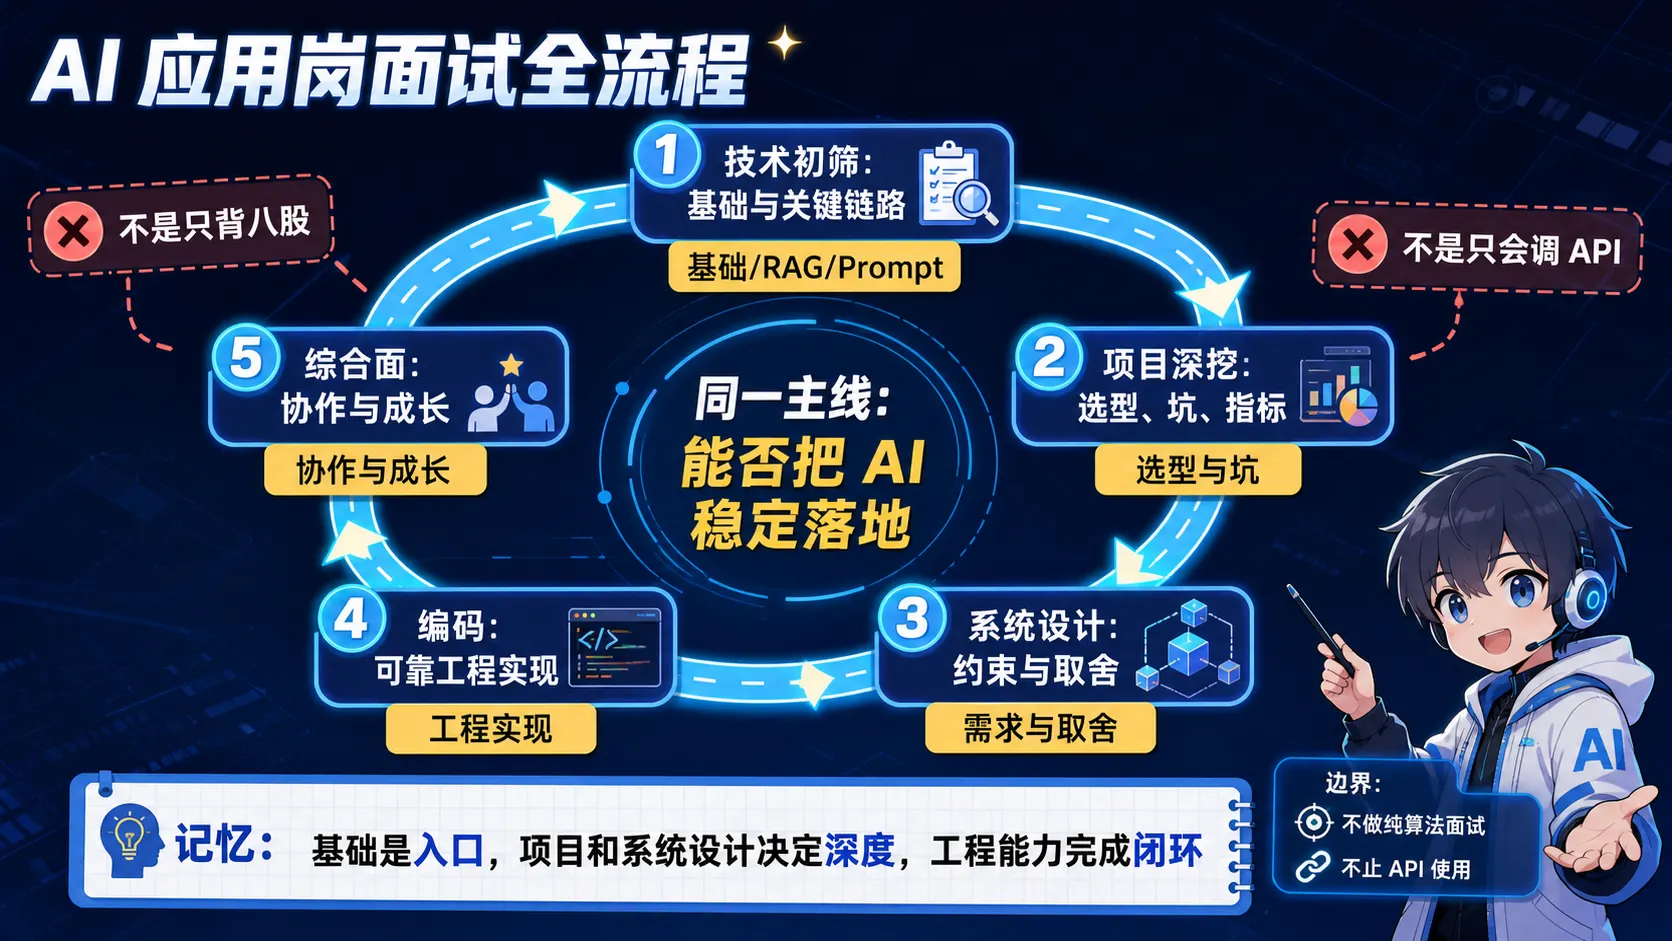
🧠 图解记忆: 基础知识是入口,项目深挖和系统设计决定深度,可靠编码与综合能力完成闭环。
💡 答案要点
面试环节:
技术初筛(30 分钟)
- LLM 基础概念:Transformer、Attention、Token 化
- RAG 系统设计:向量检索、混合检索、rerank
- Prompt 工程:CoT、Few-shot、参数调优
项目深挖(45 分钟)
- 项目背景和目标
- 技术选型依据
- 遇到的坑和解决方案
- 量化成果和业务价值
系统设计(60 分钟)
- 设计一个智能客服系统
- 设计一个代码助手
- 设计一个文档问答系统
算法题(可选)
- 中等难度算法题
- 数据结构基础
- 代码质量和工程能力
综合面试(30 分钟)
- 职业规划
- 学习能力
- 团队协作
- 抗压能力
Q4: 如何准备系统设计题?
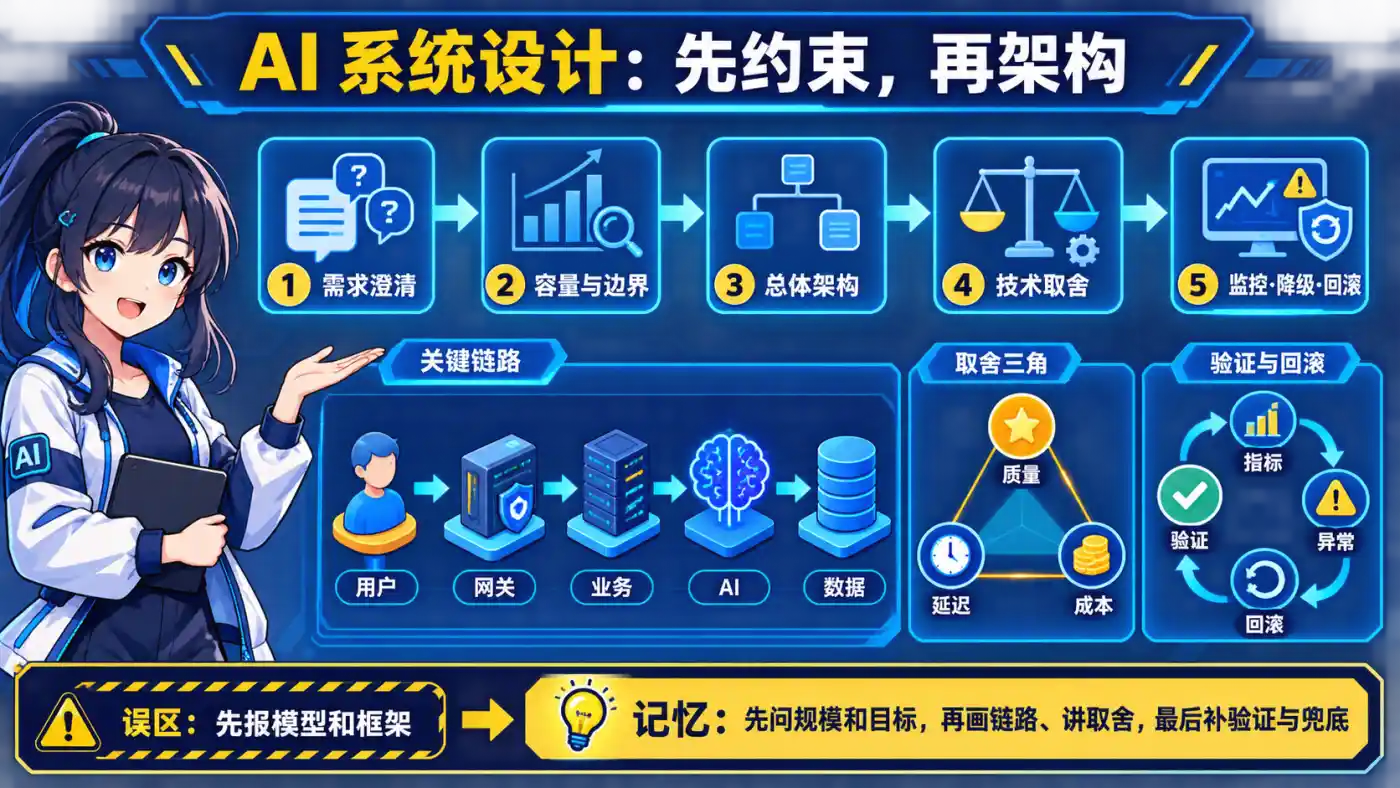
🧠 图解记忆: 先澄清规模、目标和边界,再画关键链路并权衡质量、延迟与成本,最后补验证和兜底。
💡 答案要点
通用设计模板:
需求澄清(5 分钟)
- 用户规模:日活、并发量
- 功能边界:核心功能 vs 扩展功能
- 性能要求:响应时间、准确率
- 成本约束:算力、存储、API 调用
架构设计(15 分钟)
用户请求 → API 网关 → 业务层 → AI 层 → 数据层

- 业务层:鉴权、限流、日志
- AI 层:LLM、向量检索、Agent 编排
- 数据层:向量库、关系型数据库、缓存
技术选型(10 分钟)
- LLM:GPT-4(高质量)vs DeepSeek(成本低)
- 向量库:Milvus(大规模)vs Chroma(轻量级)
- 框架:LangChain(生态)vs 自研(灵活)
性能优化(10 分钟)
- 缓存:相似问题缓存,减少 LLM 调用
- 批处理:批量向量化,提升吞吐
- 流式输出:降低首字延迟
- 异步处理:长任务异步化
监控运维(5 分钟)
- 日志:请求日志、错误日志、慢查询
- 指标:QPS、延迟、准确率、成本
- 告警:错误率、延迟、API 配额
示例题:设计一个智能客服系统
1. 需求:
   - 10w DAU,峰值 QPS 100
   - 支持多轮对话、知识库检索、订单查询
   - 响应时间 < 2s,准确率 > 85%

2. 架构:
   用户 → API 网关 → 对话管理 → Agent 编排 → 工具调用
                                    ↓
                            [LLM] [知识库] [订单系统]

3. 技术栈:
   - LLM:GPT-4o-mini(成本与质量平衡)
   - 向量库:Milvus(知识库 50w 文档)
   - 框架:LangChain(快速开发)
   - 缓存:Redis(高频问题缓存)

4. 优化:
   - 相似问题缓存(命中率 30%,节省 API 成本)
   - 混合检索(BM25 + 向量,召回率 95%)
   - 人工介入(置信度 < 0.7 转人工)
💰 谈薪技巧
Q5: AI 应用工程师薪资水平?
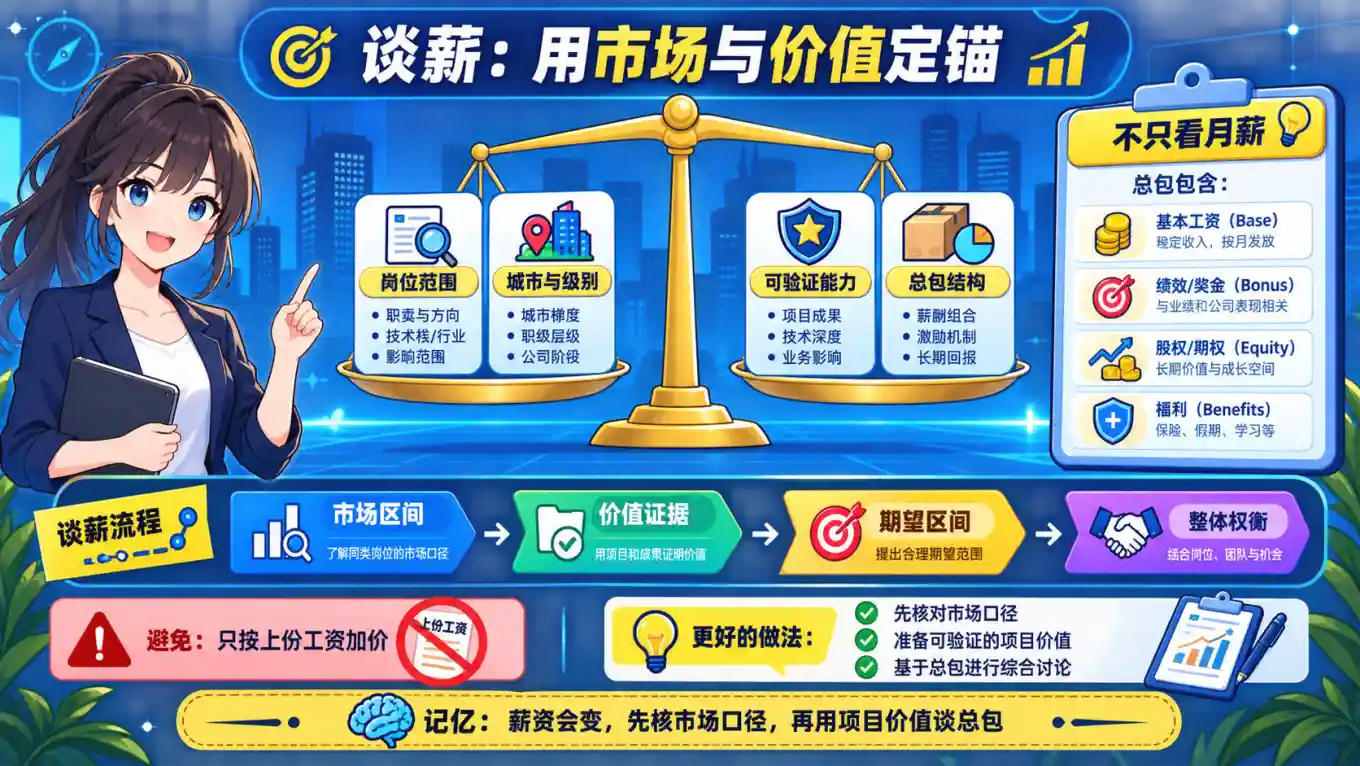
🧠 图解记忆: 薪资会随城市、级别和市场变化,先核对同类岗位口径,再用可验证项目价值讨论整体总包。
💡 答案要点
2026 年市场行情(北京/上海/深圳):
| 经验 | 薪资范围(月薪 * 14-16) | 要求 |
|---|---|---|
| 应届生 | 15-25k | 有 AI 项目经验,熟悉 RAG/Agent |
| 1-3 年 | 25-40k | 独立完成 RAG 系统,有生产环境经验 |
| 3-5 年 | 40-60k | 主导 AI 项目,有架构设计能力 |
| 5+ 年 | 60-100k | AI 架构师,有团队管理经验 |
加分项:
- ✅ 有大厂 AI 项目经验(+20%)
- ✅ 有从 0 到 1 构建 AI 产品经验(+15%)
- ✅ 有开源项目或技术博客(+10%)
- ✅ 有算法背景或 NLP 经验(+10%)
谈薪话术:
❌ 差:我上一份工作是 30k,希望涨到 35k
✅ 好:我在上一家公司主导了 RAG 系统,检索准确率 92%,为公司节省客服成本 60%。
      根据市场行情和我的能力,期望薪资是 35-40k,具体可以根据团队情况协商。
🚀 职业规划
Q6: AI 应用工程师的职业发展路径?
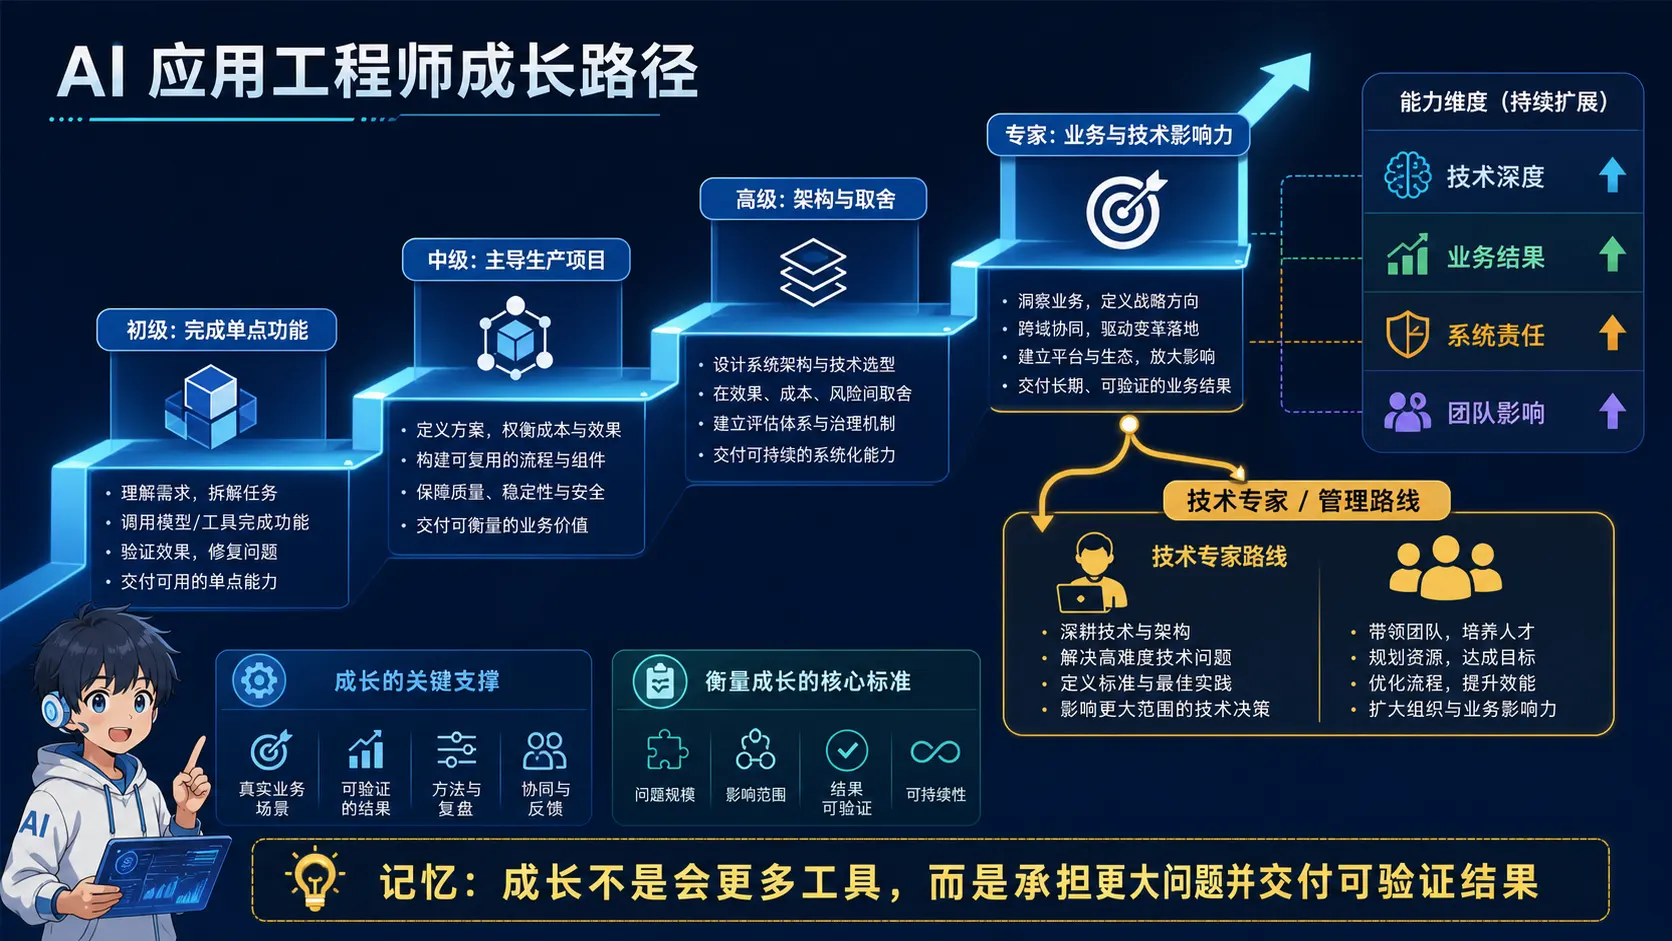
🧠 图解记忆: 职业成长不是会更多工具,而是持续扩大问题规模、系统责任和影响范围,并交付可验证结果。
💡 答案要点
技术路线:
初级 AI 工程师(0-1 年)
  ↓ 熟练使用 LangChain/LlamaIndex,独立完成 RAG 系统
中级 AI 工程师(1-3 年)
  ↓ 主导 AI 项目,设计 Agent 系统,优化性能
高级 AI 工程师(3-5 年)
  ↓ 架构设计,技术选型,团队管理
AI 架构师 / 技术专家(5+ 年)
管理路线:
AI 工程师 → AI Team Lead → AI 技术经理 → CTO能力模型:
| 阶段 | 技术能力 | 业务能力 | 软技能 |
|---|---|---|---|
| 初级 | 熟悉 LLM API,能实现基础 RAG | 理解业务需求 | 沟通、协作 |
| 中级 | 系统设计,性能优化,Agent 编排 | 量化业务价值 | 项目管理 |
| 高级 | 架构设计,技术选型,成本优化 | 产品规划,ROI 分析 | 团队管理 |
学习路径:
基础阶段(3 个月)
- LLM 原理、Prompt 工程、RAG 基础
- 完成 2-3 个小项目
进阶阶段(6 个月)
- Agent 系统、向量检索优化、多模态
- 参与生产级项目
深化阶段(持续)
- 模型微调、强化学习、多 Agent 协作
- 技术博客、开源贡献
📝 面试常见问题
Q7: 你为什么要转 AI?
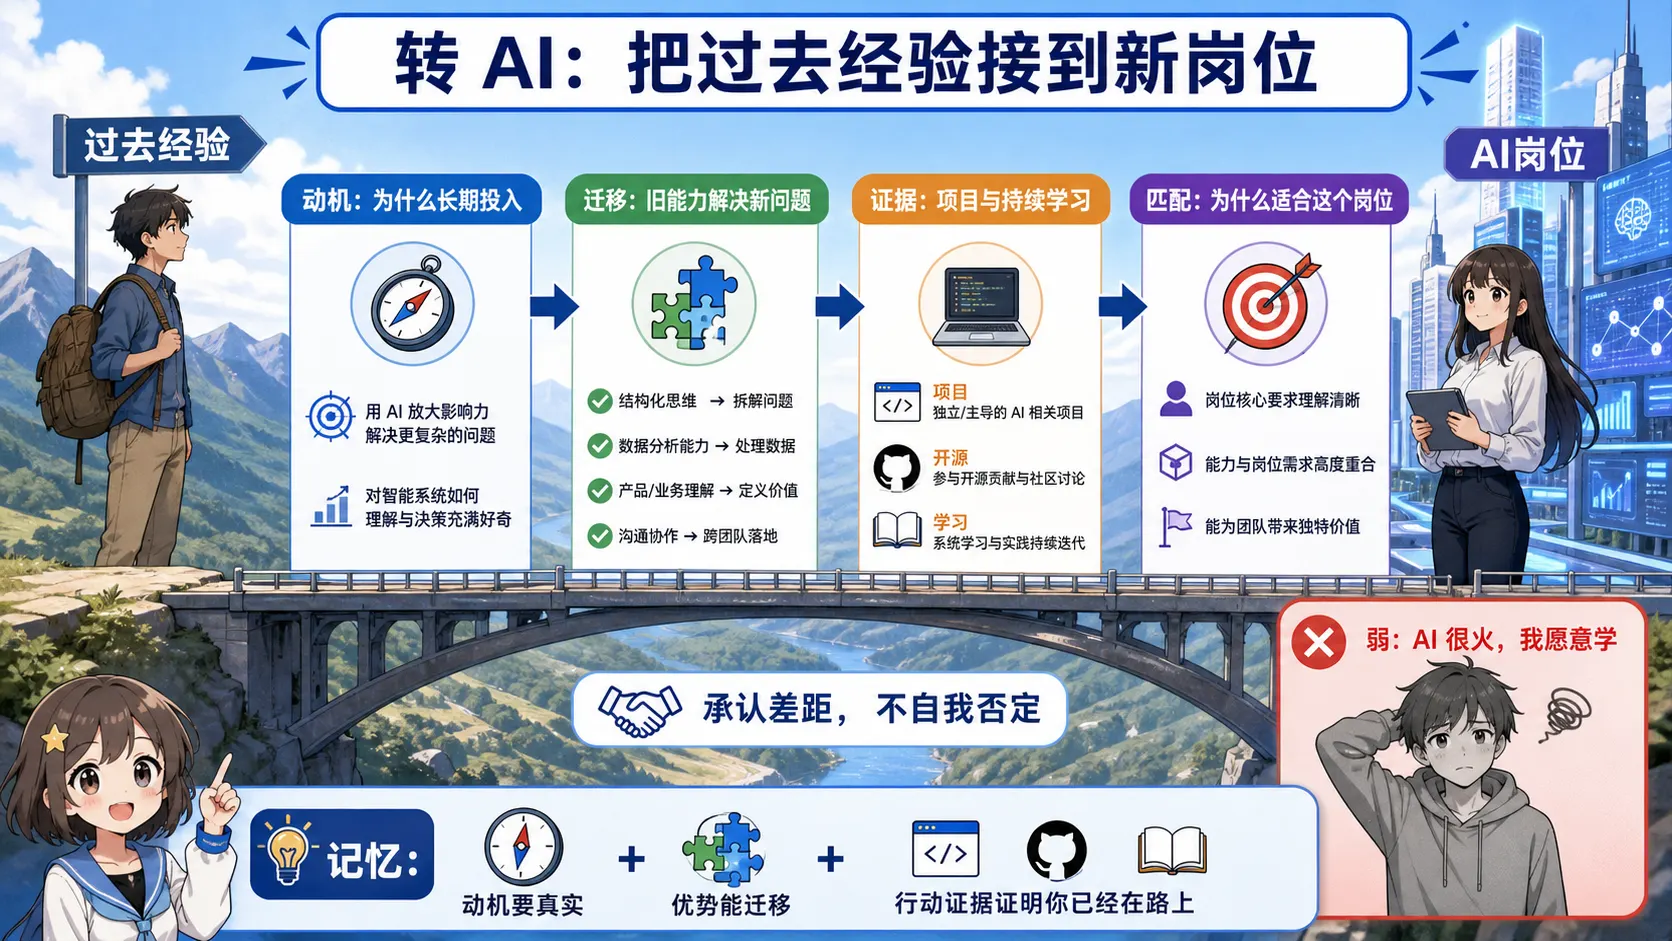
🧠 图解记忆: 先说明长期动机,再把旧经验映射到新问题,用项目和学习证据证明自己已经开始行动。
💡 答案要点
回答框架:兴趣 + 能力 + 机会
示例 1(传统开发转 AI):
我在后端开发领域积累了 5 年经验,但我发现 AI 正在重塑整个软件行业。
我的优势是:
1. 有扎实的工程能力,理解生产环境的挑战
2. 有系统设计经验,能把 AI 技术落地到业务
3. 有快速学习能力,已完成 3 个 AI 项目

AI 应用开发不是纯算法,更多是工程落地。我的后端背景是优势,不是劣势。
示例 2(应届生):
我在大学期间就对 AI 很感兴趣,完成了 NLP、CV 等课程。
但我发现算法研究门槛高,而 AI 应用开发是一个更容易切入的方向。

我的优势是:
1. 有扎实的编程基础(Python、数据结构、算法)
2. 有 AI 项目经验(RAG 系统、Agent 应用)
3. 有快速学习能力,能快速适应新技术

AI 应用开发是 AI 技术落地的关键,我希望在这个方向深耕。
Q8: 你对 AI 发展有什么看法?
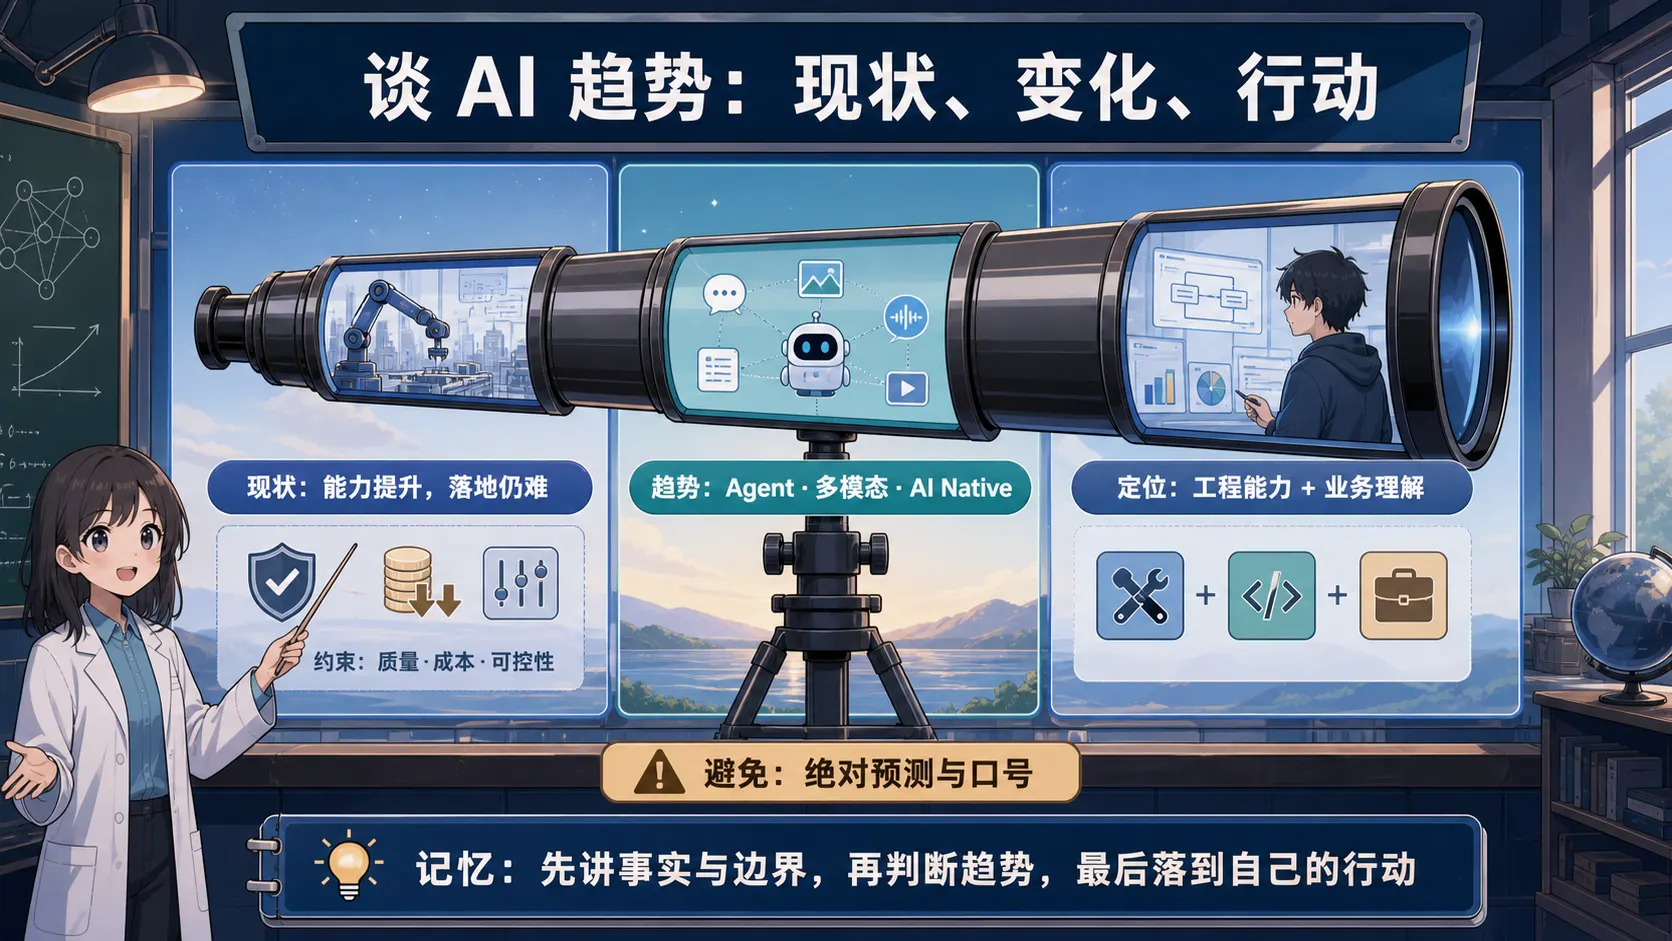
🧠 图解记忆: 先讲可核验的现状和落地边界,再判断 Agent、多模态等趋势,最后落到自己的能力建设与行动。
💡 答案要点
回答框架:现状 + 趋势 + 个人定位
参考答案:
我认为 AI 正处于"iPhone 时刻"——技术已成熟,但应用才刚开始。

当前现状:
- LLM 能力已达到生产级(GPT-4、Claude、DeepSeek)
- AI 应用从 demo 到产品化的挑战依然很大
- 成本、准确率、可控性是三大核心问题

未来趋势:
- AI Native 应用会爆发(不是把 AI 加到现有产品,而是重新设计产品)
- Agent 会成为主流(从单次问答到自主任务执行)
- 多模态会普及(文本、图像、语音、视频融合)

我的定位:
- 不做算法研究(门槛太高),专注 AI 应用落地
- 深耕某个垂直领域(教育、医疗、客服)
- 积累工程能力 + 产品思维
Q9: 如何用 STAR 法则量化描述 RAG 系统项目?(含模板)
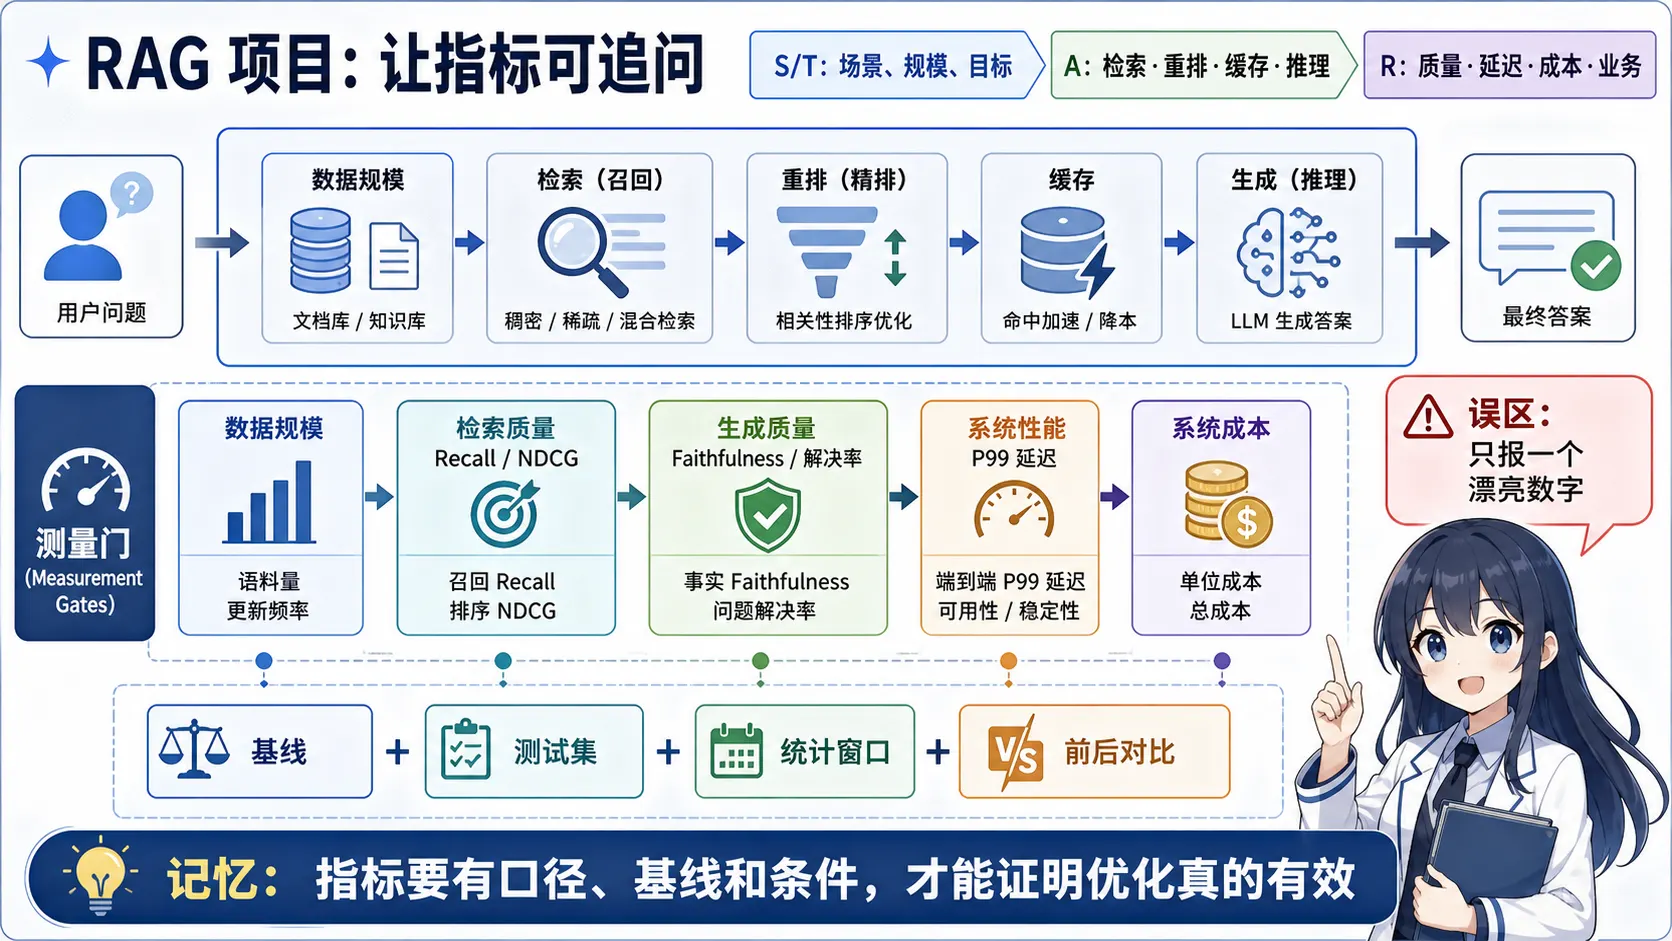
🧠 图解记忆: 项目数字必须同时说明指标口径、基线、测试集和统计条件,才经得住面试官继续追问。
💡 答案要点
STAR 法则:Situation / Task / Action / Result
核心原则:量化!量化!量化!
模板(直接可背)
【Situation】项目背景
我负责设计并落地公司知识库问答系统的 RAG 架构,支持 500 万注册用户,日均请求 80 万次。

【Task】核心技术挑战
当时面临三大挑战:① 历史文档超 10 万篇,跨部门检索准确率仅 45%;② 复杂问题(如"对比竞品A和竞品B的技术方案")需要多跳推理;③ 用户期望秒级响应,但当时的 P99 超过 5 秒。

【Action】具体技术方案
我主导了以下技术优化:
- 引入混合检索(向量 + BM25),召回率从 45% → 78%
- 设计两阶段 Rerank(向量初筛 → Cross-Encoder 重排),准确率提升 35%
- 实现语义缓存层,相同问题命中缓存直接返回,延迟从 800ms → 120ms
- 部署 SGLang + TensorRT-LLM 推理优化,吞吐提升 4 倍

【Result】量化成果
最终系统:检索准确率 91%(+46%),P99 延迟 280ms(-64%),日均承载 80 万次请求,年度为公司节省 API 成本 120 万元。
量化指标速查表
| 维度 | 指标 | 差 → 好 |
|---|---|---|
| 检索 | Recall@5 / MRR | 45% → 78% |
| 准确率 | HitRate / NDCG@10 | 55% → 91% |
| 延迟 | P50 / P99 | 800ms → 120ms |
| 吞吐 | QPS / 并发用户数 | 200 → 2000 |
| 成本 | 单次请求成本 / 月度账单 | ↓60% |
| 业务 | 用户满意度 / 解决率 | 65% → 88% |
AI Agent 项目的 STAR 模板
【Situation】
公司的客服场景需要 AI Agent 自动处理用户问题,高峰期排队 1000+ 人,人工成本高。

【Task】
设计一个多 Agent 协作系统,实现:问题分类 → 意图识别 → 工具调用 → 答案生成全流程自动化。

【Action】
- 设计 ReAct Agent 架构,每轮推理包含 Thought/Action/Observation
- 引入 Tool Agent 专门处理 API 调用(日历/订单/库存)
- 实现 Human-in-the-Loop:置信度 < 0.7 自动转人工
- 引入 Conversation Memory Agent,长期记忆用户偏好

【Result】
AI Agent 独立解决率 73%,人工介入率从 85% → 27%,客服团队人效提升 3 倍,用户满意度从 3.2 → 4.6(5分制)。
面试话术:
"我习惯用 STAR 法则描述项目,重点是量化成果。比如 RAG 项目,我会说'召回率从 45% 提升到 78%,延迟从 800ms 降到 120ms',而不是'我优化了 RAG 系统'。数字最有说服力,面试官能立刻判断项目深度。"
Q10: 被问"没有 AI 项目经验怎么办",如何回答?
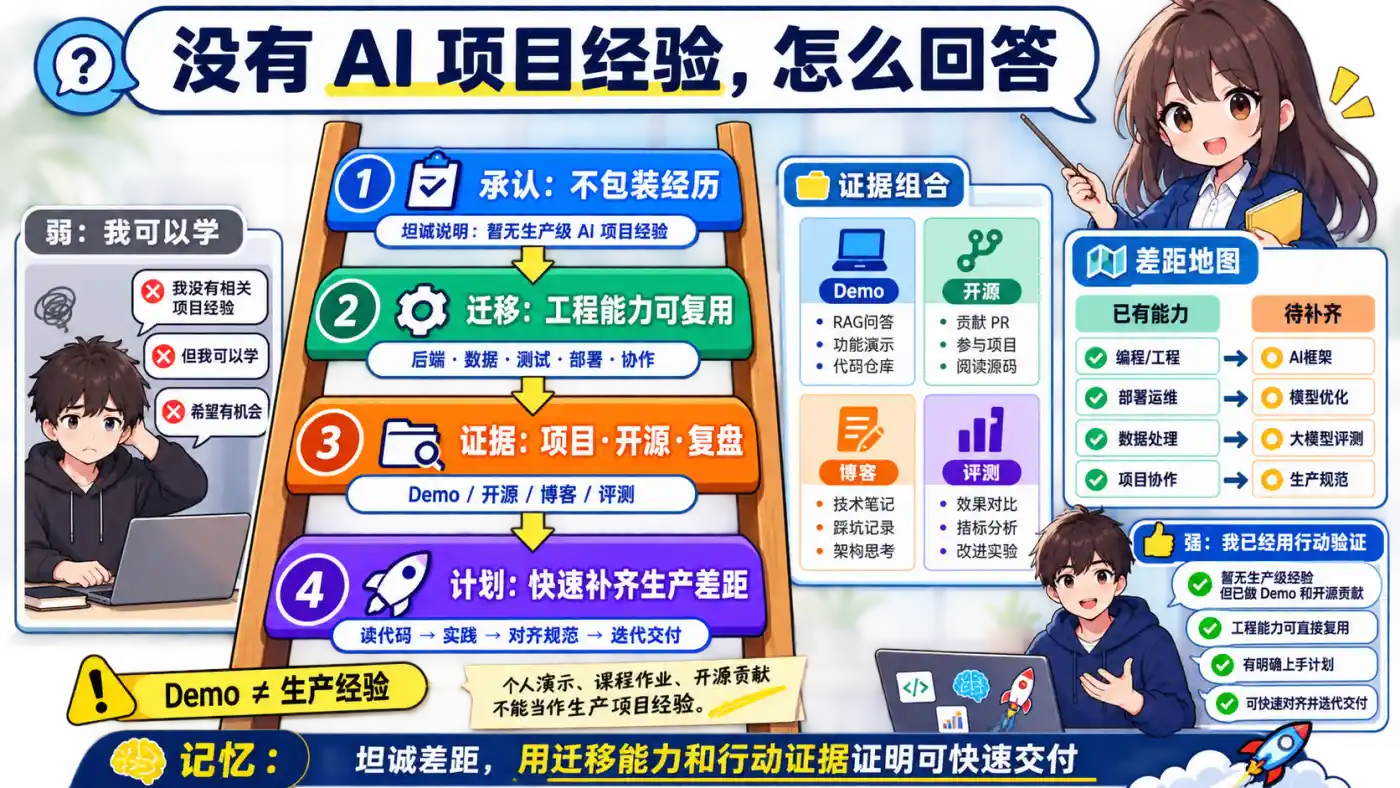
🧠 图解记忆: 不包装 Demo 为生产经验,坦诚差距后用可迁移工程能力、行动证据和清晰上手计划证明交付潜力。
💡 答案要点
核心思路:承认差距 + 展示迁移能力 + 证明学习速度
错误回答:
❌ "确实没有 AI 项目经验,但我可以学"
(太弱,没有差异化)
正确回答(四步法):
1. 承认现实,但不要自我贬低
"确实,我上一份工作主要是传统后端开发,没有生产级的 AI 项目经验。"

2. 找到你的独特优势
"但我认为 AI 应用开发的核心是工程落地,这正是我的强项。"

3. 展示已证明的学习能力
"我业余时间已经在做三件事:① 用 LangChain 跑了 RAG Demo;② 贡献了 Yapi MCP Pro 开源项目(Star 200+);③ 每天学习 AI 面试题库,已经整理了 300+ 道题。"

4. 强调快速融入的能力
"我的工程背景反而是优势——我理解微服务、消息队列、缓存这些生产级组件,能让 AI 应用真正落地,而不是停留在 Demo 阶段。"
加分项:拿出证据
| 证据类型 | 示例 |
|---|---|
| 开源项目 | "我做了 Yapi MCP Pro,让 AI 直接读接口文档" |
| 个人项目 | "我做了语音转文字小程序,400+ 用户" |
| 技术博客 | "我在掘金发了 3 篇 RAG 实践文章,2000+ 阅读" |
| 学习笔记 | "我整理了 AI 面试题库,385+ 道题,GitHub 500+ Star" |
| 培训证书 | "我完成了 LangChain 官方课程,拿到了证书" |
面试话术:
"没有 AI 项目经验是事实,但我在转型的过程中已经完成了 3 个 AI 相关项目:Yapi MCP Pro 开源工具、语音转文字小程序、知识库 RAG 实践。我的策略是先动起来,在做的过程中学习,而不是等到'准备好'才开始。工程能力的迁移性很强,我的后端经验让我比纯 AI 研究者更适合做 AI 应用落地。"
Q11: 技术总监面:如何回答"AI 未来会取代程序员吗"?
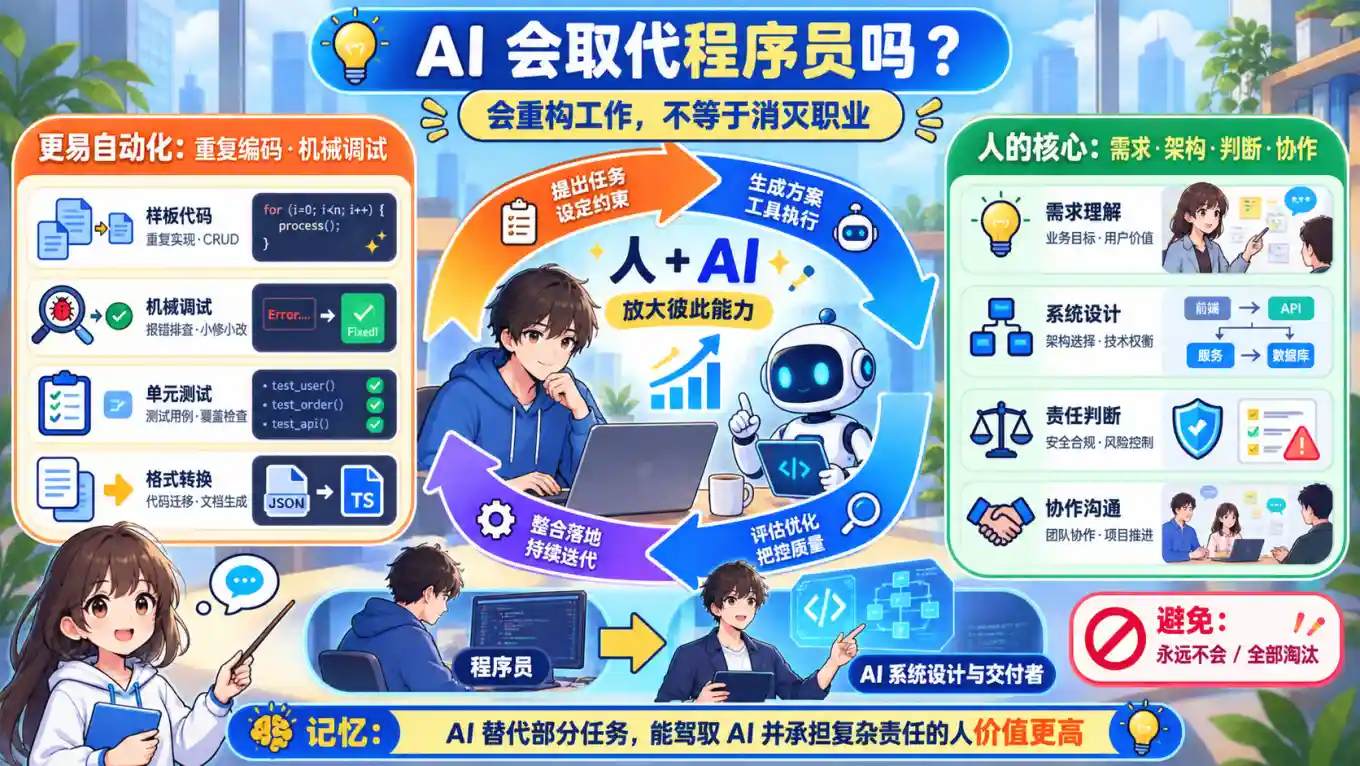
🧠 图解记忆: AI 更可能替代部分重复任务并重构工作方式,能驾驭 AI、理解需求并承担复杂系统责任的人价值更高。
💡 答案要点
考察点: 技术视野 + 辩证思维 + 自我认知 + 价值观
四层回答法:
【第一层:直接回答】
短期(5年内):不会取代,但会重构工作方式。

【第二层:辩证分析】
AI 会取代的是:重复性编码(CRUD、简单算法)、机械调试、死记硬背。
AI 无法取代的是:系统设计、需求理解、跨团队沟通、复杂问题拆解、创造新架构。

【第三层:历史类比】
"就像编译器和 IDE 取代了手写机器码,但没有消灭程序员,反而让程序员能做更高级的事。AI 会取代'写代码'这个动作,但程序员这个职业会升级为'AI 系统设计师+架构师+需求工程师'。"

【第四层:个人定位】
"我能做的是:① 学会用 AI 工具提升效率;② 深耕系统设计和架构能力;③ 积累业务理解,这是 AI 短期内无法替代的。"
禁用语:
❌ "AI 永远不可能取代程序员"(太绝对)
❌ "程序员都会被淘汰"(太悲观)
❌ "我不知道"(没有观点)
加分引用:
- "GitHub CEO 说:未来 80% 的代码将由 AI 生成,人类只需生成 20% 的关键代码" → 引用后反驳
- "但那 20% 恰恰是最难的部分:架构设计、业务理解、系统集成" → 体现深度思考
面试话术:
"我的判断是:AI 会取代'写代码',但不会取代'程序员'这个职业。就像汽车取代马车,但需要的是司机而不是马夫。未来程序员的核心能力是:① 用 AI 工具放大自己的产出;② 做 AI 做不了的系统设计和需求分析;③ 理解业务,成为技术和业务的桥梁。我的策略是主动拥抱 AI,而不是抗拒它。"
Q12: 如何准备白板编程题?(AI 应用工程师版本)
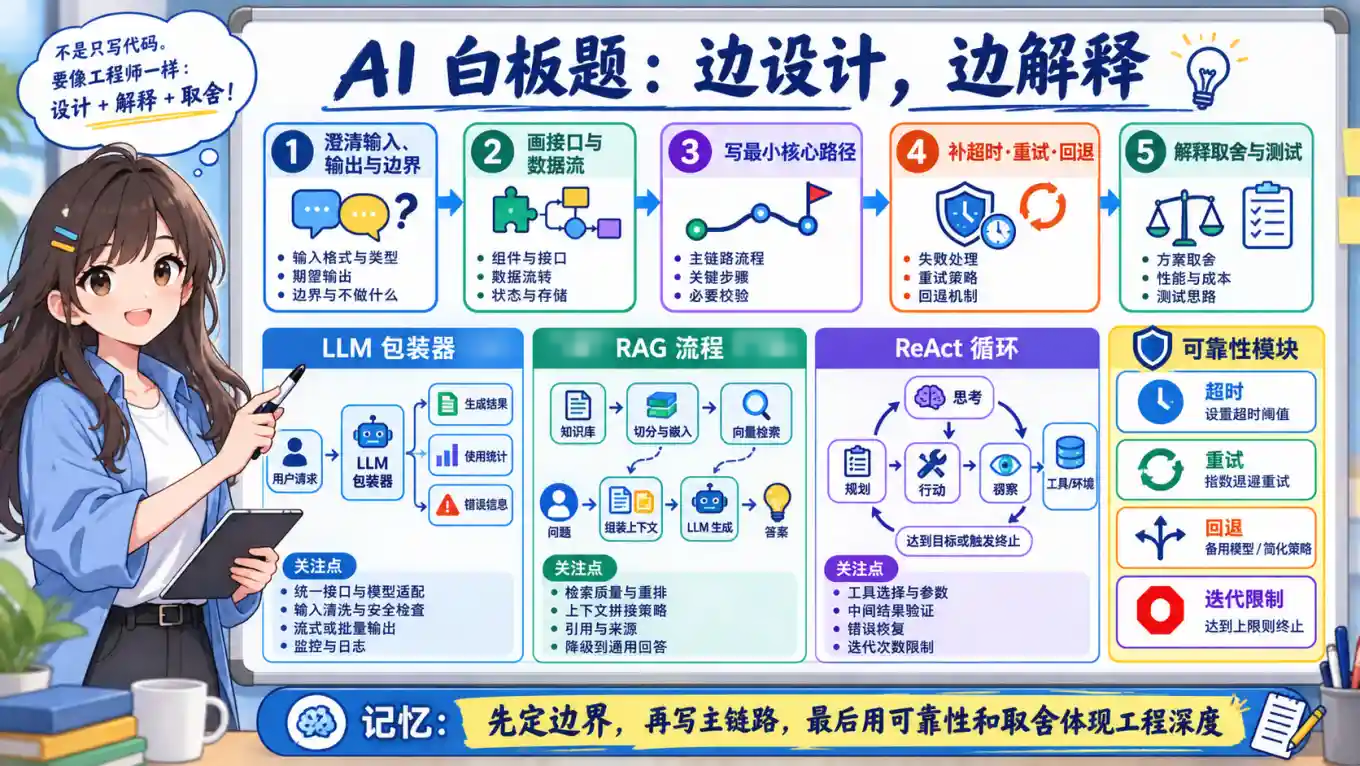
🧠 图解记忆: 先确认输入输出和边界,再画接口与数据流、写最小主链路,最后用超时、重试、回退和测试体现工程深度。
💡 答案要点
AI 应用工程师白板题的特点:
| 传统 SDE 白板题 | AI 应用工程师白板题 |
|---|---|
| 链表/树/图 | LLM 调用 / Prompt 设计 |
| 算法复杂度 | RAG 流程设计 / Agent 架构 |
| 手工实现 | 用 API 或框架组合 |
| 一次性写对 | 边想边调 + 分析 tradeoff |
高频题型:
题1:实现一个 LLM 包装器(类设计)
"请设计一个 LLM 调用类,支持:
- 自动重试(指数退避)
- 超时处理
- 流式输出
- 回退策略(GPT-4 失败 → DeepSeek V4-Flash)"
参考答案框架:
class LLMClient:
    def __init__(self, providers: list, fallback_order: list):
        self.providers = providers
        self.fallback_order = fallback_order

    async def generate(self, prompt, stream=False, timeout=30):
        for provider in self.fallback_order:
            try:
                return await self._call_with_timeout(provider, prompt, stream, timeout)
            except Exception as e:
                continue
        raise AllProvidersFailedError()

    async def _call_with_timeout(self, provider, prompt, stream, timeout):
        # 实现超时控制
        pass
题2:设计一个 RAG 检索流程
"请设计一个 RAG 系统,包含:
- 文档切分
- 向量嵌入
- 检索
- 重排
- 生成"
参考答案框架:
def rag_pipeline(query: str, top_k: int = 5):
    # 1. 查询改写
    rewritten_query = query_rewrite(query)

    # 2. 向量检索
    query_emb = embedding_model.encode(rewritten_query)
    initial_results = vector_db.search(query_emb, k=top_k*2)

    # 3. 重排
    reranked = cross_encoder.rerank(query, initial_results, top_k)

    # 4. 生成
    context = format_context(reranked)
    answer = llm.generate(f"上下文:{context}\n问题:{query}")

    return answer
题3:设计一个 Agent 循环
"请用 ReAct 模式实现一个 Agent,支持:
- Thought/Action/Observation 循环
- 最大循环次数限制
- 工具调用"
准备策略:
| 步骤 | 内容 |
|---|---|
| 1 | 刷完 LLM API 调用题(OpenAI SDK / LangChain) |
| 2 | 默写 RAG 流程(从 chunk 到 answer) |
| 3 | 实现一个最小化 Agent(ReAct Loop) |
| 4 | 练习 Tradeoff 分析(为什么选这个方案) |
面试话术:
"AI 应用的白板题和传统 SDE 不一样,重点不是算法复杂度,而是系统设计和 API 组合能力。我会先确认需求边界(要不要流式?要不要缓存?),然后画架构图,再写核心代码,最后分析 tradeoff。边想边说是关键,不要等想完美了才开始写。"
Q13: 行为面试高频题:说说你最失败的一个技术决策?
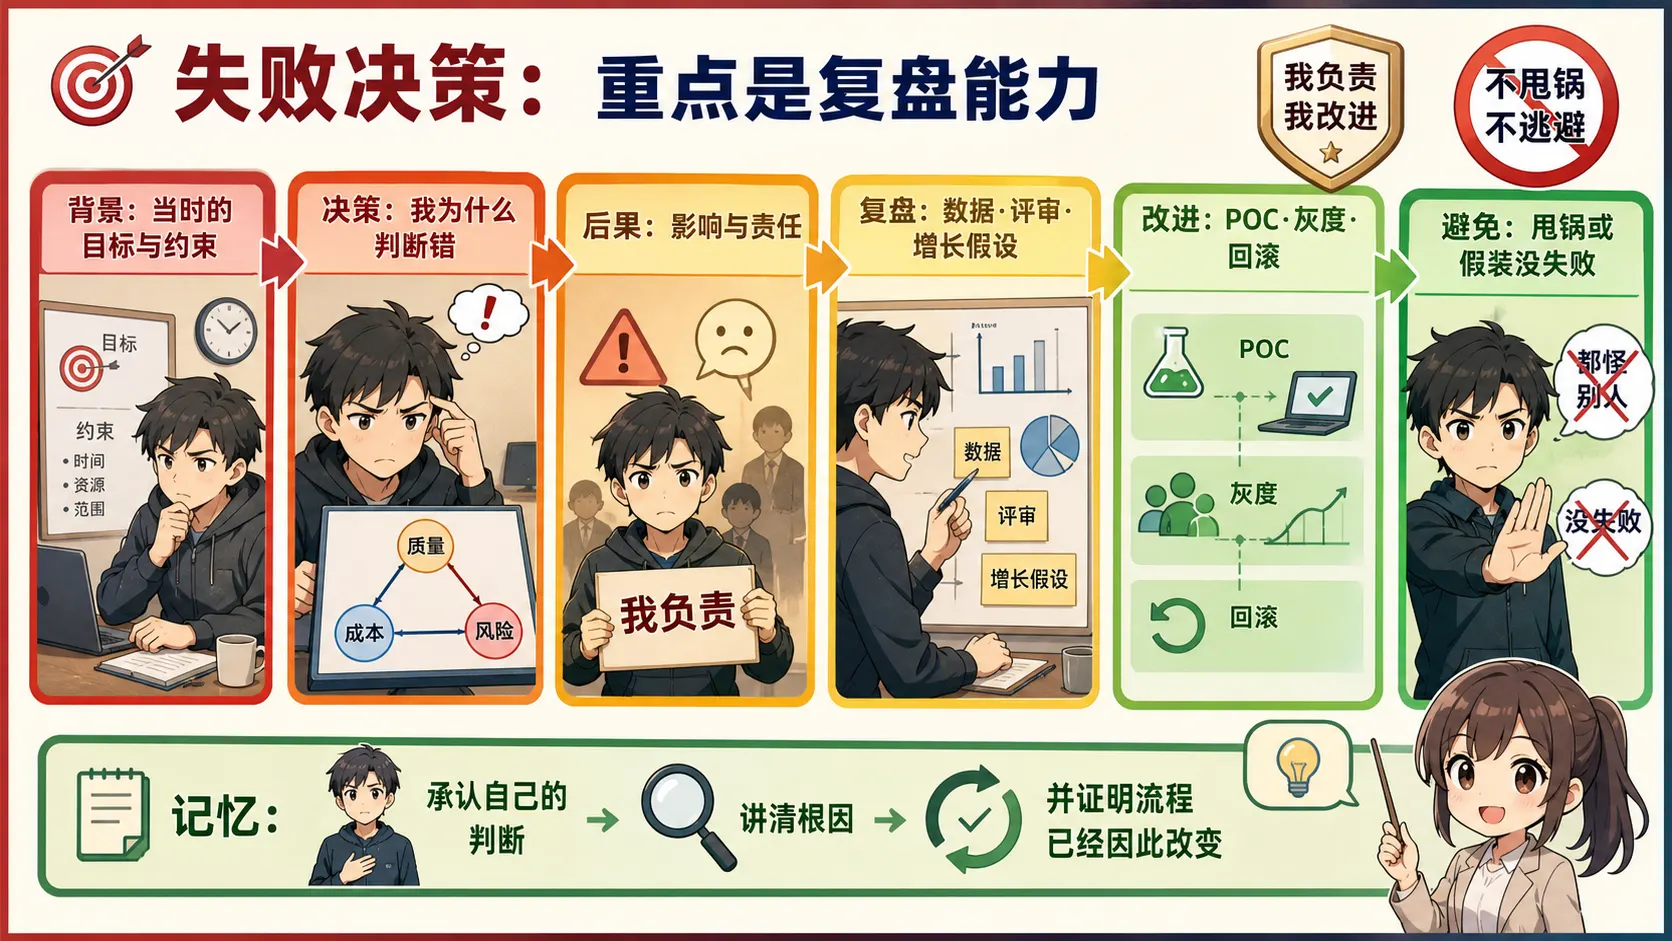
🧠 图解记忆: 好答案要承担自己的判断,说明影响和根因,并证明 POC、评审、灰度与回滚流程已经因此改变。
💡 答案要点
STAR 法则 + 复盘思维
禁忌:
❌ "我没有失败过"(太假)
❌ "我不记得了"(没有反思能力)
❌ "那不是我的错"(推卸责任)
❌ "失败的项目是别人的原因"(甩锅)
模板(直接可背):
【项目背景】
在上一家公司,我负责设计一个实时推荐系统,需要在 100ms 内返回推荐结果。

【错误决策】
我选择了 Elasticsearch 做向量检索,原因是我之前用过 ES,比较熟悉。但 ES 的向量检索性能不如专门的向量数据库(如 Milvus),而且 ES 的扩展性有限。

【失败后果】
系统上线后,P99 延迟超过 800ms,用户投诉率上升,最终不得不重构。

【深度复盘】
"回头看,我犯了三个错误:
① 技术选型凭经验而不是数据:我没有做性能基准测试,完全基于熟悉度选型
② 没有请教专家:我应该先咨询向量数据库团队,而不是自己硬扛
③ 忽视业务增长:我只考虑了当前数据量,没考虑 3 个月后的增长"

【改进措施】
"这次失败之后,我建立了技术选型的 checklist:
① 性能基准测试(至少测 3 个候选方案)
② POC 验证(用真实数据跑一周)
③ 架构评审(请资深工程师 review)
④ 制定回滚方案"

【现在的方法】
"我现在做技术选型,会先问自己三个问题:
1. 这个选择的最坏情况是什么?能接受吗?
2. 我有没有遗漏什么更优方案?
3. 如果错了,我怎么知道,怎么回滚?"
AI 应用工程师专属版本:
【项目背景】
我曾经在一个 RAG 项目中选择了小模型(DeepSeek-V4-Flash)来节省成本,认为它足够处理简单问答。

【错误决策】
没有做 A/B 测试,直接全量上线。

【失败后果】
用户反馈"回答太水",客服投诉率上升,最终不得不换成 GPT-4,成本反而更高(因为换了两次)。

【复盘】
"我错在:① 过度优化成本而忽视了质量;② 没有做灰度测试就全量上线;③ 没有建立评估指标就上线了。正确的做法是:先用 GPT-4 做 baseline → 和小模型做对比评估 → 确认质量差距可接受后再考虑降本。"

【改进】
"现在我的 AI 项目上线流程是:
① 用当前最优模型跑 baseline,记录指标
② 用候选模型跑对比测试
③ 质量差距 < 5% 才考虑换
④ 灰度 5% → 20% → 100%"
面试话术:
"我最失败的技术决策是在 RAG 项目中过早优化成本,用 DeepSeek V4-Flash 替代 GPT-4,结果用户反馈很差,最终成本反而更高(因为换了两次)。这次失败让我建立了'质量优先,分级验证'的上线流程:先用最优模型做 baseline,确认质量可接受后再优化成本。"
Q14: AI Agent 后端岗 JD 怎么拆解?转型 AI 开发要补哪些能力?
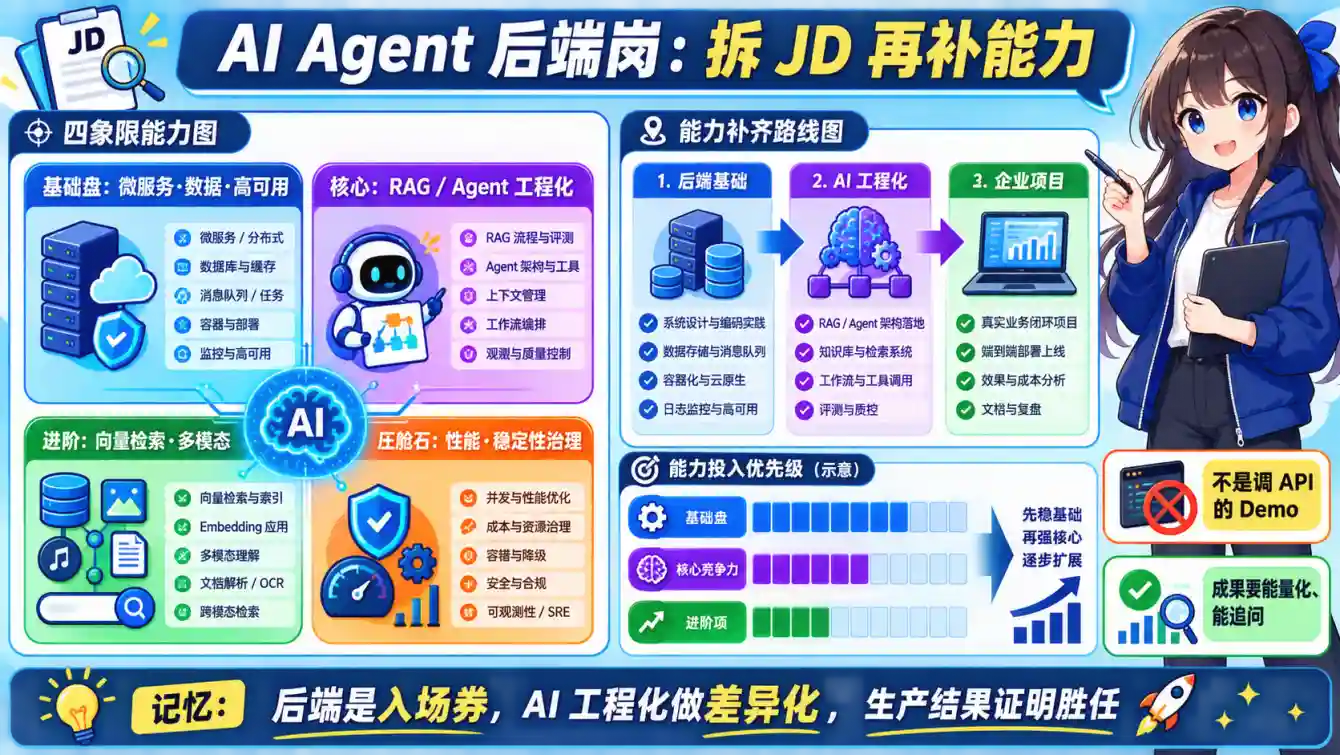
🧠 图解记忆: 后端基本功是入场券,RAG 与 Agent 工程化形成差异化,最终要用可量化的生产结果证明胜任。
💡 答案要点
背景: 面试官问"你凭什么胜任 AI Agent 后端岗",或者你被问"你怎么规划转型"——用 JD 拆解思维回答,直接展示工程认知。
AI Agent 后端岗 JD 的 4 大能力模块(面试必答):
| 模块 | JD 关键词 | 考察本质 |
|---|---|---|
| 1. 基础盘 | 企业级 Agent 架构、高可用微服务 | 不是单文件 Demo,是能支撑业务的微服务架构 |
| 2. 核心竞争力 | RAG/Function Call/多Agent 工程化落地 | 不是"会用 RAG",是"把准确率做到 93% 同时控成本" |
| 3. 进阶项 | 亿级向量、多模态搜索架构 | 向量库选型、冷热分离、标量过滤+向量检索 |
| 4. 压舱石 | 后端性能调优、稳定性治理 | 排查瓶颈、熔断降级、高可用(AI 是加分项,后端是入场券) |
核心认知(加分):
80% 的核心考察点是工程化能力+落地能力,纯算法占比极低。企业招的不是"会调 API 的人",是"能把 AI 落地成稳定业务系统的工程师"。
转型学习路线(3 阶段,面试可讲规划):
阶段一:筑牢后端基础盘(入场券)
  Go/Java 一门吃透 + MySQL/Redis/Kafka + 微服务架构
  → 能独立设计高可用后端系统

阶段二:攻克 AI 应用工程化(差异化)
  RAG:全流程 → 每环节优化(Chunk/混合检索/Rerank/幻觉治理)→ 工程化(版本/多租户/缓存)
  Agent:ReAct/Plan-Execute → 工具封装/MCP → 多Agent分层架构
  生产痛点:SSE流式/首字延迟/模型路由降本/异常兜底/效果漂移检测

阶段三:项目落地+面试备战(变现)
  做对标企业级的完整项目(企业级RAG知识库/多Agent平台)
  每个技术点准备"背景-方案-结果"三段式,成果量化
  对着 JD 逐条过,经得住连续追问
时间分配 631 法则(2026 面试策略):
60% 做项目(有差异化、能讲故事:基于 LLM 的智能客服/RAG 知识库)
30% 复盘八股(结合项目场景背,不背纯概念)
10% 练算法

八股优先级:
  P0 必背:MySQL(索引/事务/锁) Redis(缓存三大问题) 并发(线程池/AQS)
  P1 选背:MQ/分布式事务/Spring 源码
  P2 别死磕:偏门源码细节

原则:八股是答辩用的弹药,不是炫技用的展品。
  背 1000 道答不出场景,不如背 100 道每个都能讲清"我在项目里用过、踩过什么坑、怎么解决"
量化表达模板(面试关键):
❌ 不说:"我优化了 RAG 检索"
✅ 要说:"我针对专业文档召回率低的问题,设计了语义边界感知的 Chunk 策略 + BM25/向量混合检索方案,
        最终问答准确率从 53% 提升到 93%,同时通过模型路由把 Token 成本降了 40%"
面试话术:
"我看 AI Agent 后端岗 JD,核心是四块:企业级 Agent 架构(微服务拆分、工作流编排、高可用)、RAG+Agent 工程化落地(解决延迟/成本/长上下文/幻觉四大生产痛点)、复杂系统架构(向量库优化、多模态)、后端性能治理(熔断降级、高并发保护)。我的规划是:后端基本功打底,AI 工程化做差异化,项目对标企业级——不写 Demo,做一个能扛住追问、成果量化的完整系统。"
Q15: 面试官让"30秒自我介绍",AI 应用工程师怎么组织?(高频必考)
🧠 图解记忆: 别背简历——30秒内只讲三件事:你是谁、你能做什么、为什么匹配,每个话题不超过10秒。
💡 答案要点
核心原则:不是背诵简历,而是做"电梯演讲"
黄金公式:身份标签 + 核心能力 + 项目亮点 + 求职动机
【开场 — 身份标签】(10秒)
\"我是张XX,5年前端开发经验,最近2年专注AI应用开发方向。\"

【核心 — 能力+亮点】(10秒)
\"主导过公司知识库RAG系统从0到1搭建,检索准确率从45%提升到92%,日均处理80万次请求。\"

【收尾 — 求职动机】(10秒)
\"看到贵司在Agent方向的布局很有兴趣,我希望加入团队把AI从Demo变成稳定产品。\"
错误示范:
❌ \"大家好,我毕业于XX大学,做过XX工作,会Python Java Go...(翻简历)\"
→ 面试官在简历上已经看过了,不要重复念简历
高分模板(直接可套):
\"您好!我是[姓名],有[N]年[原领域]开发经验,近[N年]转向AI应用开发。
我最擅长的是[RAG/Agent/Prompt工程],在上一段经历中[量化成果一句话]。
我对贵司的[具体产品/技术方向]很感兴趣,相信我的[独特优势]能帮团队解决问题。\"
针对性调整技巧:
- 如果岗位偏后端 → 强调系统架构、高并发、稳定性治理
- 如果岗位偏算法 → 强调评测指标、模型调优、数据闭环
- 如果岗位偏产品 → 强调用户增长、业务理解、需求拆解
面试话术:
"30秒自我介绍的核心是制造好奇心——你不是要展示全部,而是要让面试官想追问你某一段经历。所以结尾一定要留一个钩子,比如'其中有个优化方案我想分享下,可以展开说',给面试官一个继续聊的理由。"
Q16: 拿到多个Offer怎么比较和选择?(真实场景最实用)
🧠 图解记忆: Offer比较不是比谁钱多,而是比哪条路更能放大你的核心竞争力——用加权评分法做理性决策。
💡 答案要点
背景: 2026年AI赛道火热,很多候选人手里有2-3个offer,如何科学选择?
五维评估法(给每个维度打分 1-10,乘以权重):
| 维度 | 权重 | 说明 |
|---|---|---|
| 🔥 技术成长空间 | 25% | 团队技术深度、Mentor水平、是否有挑战性的项目 |
| 💰 总包薪资 | 20% | 包括底薪+奖金+RSU+签字费,算年度总包 |
| 🎯 业务前景 | 20% | 产品的市场定位、商业模式是否清晰、是否为核心业务 |
| 🏢 公司平台 | 15% | 品牌背书、培训体系、跳槽时的简历含金量 |
| ⚖️ 工作生活 | 10% | 加班强度、出差频率、远程办公政策 |
| 👤 直属领导 | 10% | 面了几轮就接触了领导几次,感觉合不合拍 |
实战案例对比:
📋 候选Offer A:大厂AI实验室(总包 65W)
  - 技术成长:9分 × 25 = 2.25
  - 薪资:7分 × 20 = 1.40
  - 业务:6分 × 20 = 1.20
  - 平台:9分 × 15 = 1.35
  - 平衡:4分 × 10 = 0.40
  - 领导:8分 × 10 = 0.80
  → 总分:7.40

📋 候选Offer B:AI创业公司C轮(总包 55W)
  - 技术成长:8分 × 25 = 2.00
  - 薪资:5分 × 20 = 1.00
  - 业务:9分 × 20 = 1.80
  - 平台:5分 × 15 = 0.75
  - 平衡:7分 × 10 = 0.70
  - 领导:9分 × 10 = 0.90
  → 总分:7.15

📋 候选Offer C:传统企业AI部门(总包 50W)
  - 技术成长:5分 × 25 = 1.25
  - 薪资:4分 × 20 = 0.80
  - 业务:6分 × 20 = 1.20
  - 平台:8分 × 15 = 1.20
  - 平衡:8分 × 10 = 0.80
  - 领导:7分 × 10 = 0.70
  → 总分:5.95
关键提醒:
- 早期职业(0-3年),技术成长 > 一切。大平台的技术氛围值得优先选
- 已有扎实基础(3-5年),可以考虑创业公司的业务ownership
- 总包差距 < 15% 时,选技术成长更好的那个通常没错
- 拒绝话术要得体:"非常感激贵司的认可,经过慎重考虑我觉得另一个机会目前更适合我的发展方向,希望未来还有机会合作"
面试话术:
"我有过实际拿Offer的经验,选择标准不是'哪个给得多'而是'哪个让我成长快'。我会给每个维度打权重分,因为不同阶段关注点不同。入职后如果发现有更大问题,随时可以调整策略。"
Q17: 面试怎么问面试官?反向考察公司好不好?(被忽略但极重要)
🧠 图解记忆: 提问的质量决定你对公司的了解程度——按技术、团队、业务三层准备问题,别问官网能查到的。
💡 答案要点
重要性: 反向提问环节往往被低估。好的提问不仅帮你判断公司,还能展示你的思考深度。
三层提问框架(至少准备2个问题):
第一层:技术相关(展示技术热情)
1. \"团队的AI项目在技术栈上的主要痛点是什么?选型依据是什么?\"
   → 了解团队成熟度和面临的真实挑战

2. \"RAG系统在你们线上环境中最大的生产瓶颈是什么?是延迟还是准确率?\"
   → 了解实际应用场景的深度

3. \"代码review和技术评审是怎么做的?有新同学的设计评审流程吗?\"
   → 了解技术文化和质量保障
第二层:团队相关(判断工作体验)
4. \"这个岗位所在的团队规模多大?我和谁配合最多?\"
   → 了解协作模式和汇报线

5. \"团队新人一般需要多长时间才能独立负责一个模块?\"
   → 了解培养体系和上手难度

6. \"团队有没有定期技术分享或者代码走读?\"
   → 了解学习氛围
第三层:业务相关(展示商业思维)
7. \"这个AI产品在公司的战略地位是怎样的?投入资源优先级如何?\"
   → 了解业务价值和长期性

8. \"产品当前的核心KPI是什么?技术团队对KPI的贡献度有多大?\"
   → 了解产研关系和责任边界
❌ 千万别问这些低分问题:
- "你们的加班强度怎么样?"(太直白,显得你不肯吃苦) → ✅ 换种说法:"团队一般怎么平衡交付进度和质量?"
- "你们公司有什么福利?"(HR面再问,技术面问这个减分)
- "我能带电脑回家吗?"(太初级,让人质疑你的职业素养)
高阶提问(加分项):
\"我在GitHub上看到你们开源的XXX项目,请问现在还在维护吗?未来会有什么新版本的规划?\"
→ 证明你真的做了功课,而且关心他们的技术生态
面试话术:
"我认为面试是双向选择的过程。我准备的反向问题数量应该和面试者问我的问题数量差不多。好问题能让双方都学到东西——他们介绍实际情况,我也展示自己的思考角度。"
Q18: 空窗期/Gap Year怎么写进简历、面试怎么解释?(越来越常见)
🧠 图解记忆: 空窗期不可怕,可怕的是说不清。诚实交代原因 + 量化期间行动 + 明确回归决心,三步过关。
💡 答案要点
现状: 2025-2026年经济环境变化,AI行业快速迭代,很多从业者的空窗期变长。关键是如何合理化。
简历写法 —— 不要留空白!
❌ 差:
工作经历:
  XX公司 后端开发    2022.06 - 2024.12

✅ 好:
工作经历:
  XX公司 后端开发    2022.06 - 2024.12

职业过渡期             2025.01 - 至今
- 系统学习AI应用开发,完成 RAG系统 / Agent应用 等3个Side Project
- 参与开源项目贡献(X Star / Y PR merged)
- 输出技术博客 N 篇,累计阅读 X+
- 持续准备AI岗位面试,跟踪行业动态
面试回答框架 —— "原因 + 行动 + 决心"三句式:
【原因】简短、真诚、不卖惨
\"上一份工作在2024年底结束,当时恰逢公司业务线调整裁员...\"
\"我花了一段时间重新审视了自己的职业方向...\"

【行动】具体化、可验证
\"...这段时间我没有闲着。我用LangChain做了两个RAG系统Demo,
贡献了一个AI辅助编码工具的开源项目,在掘金发了5篇技术文章。\"

【决心】展现准备好投入的状态
\"我现在已经完全准备好了,也明确了想在AI应用方向深耕,
非常期待回到一线工程岗位。\"
不同类型空窗期的应对策略:
| 情况 | 推荐话术 | 注意事项 | |------|---------|---------|| | 被裁员 | "公司业务调整/架构重组" | 不抱怨前东家,强调客观因素 | | 主动离职 | "需要时间转型和学习新技术" | 突出学习成果和项目实践 | | 健康原因 | "身体需要一段时间恢复" | 简要说明已康复,不需细节 | | 家庭原因 | "需要处理家庭事务" | 点到为止,重点在当前可全职投入 | | Gap Year旅行 | "开阔视野同时保持学习" | 必须附带学到的技能/项目 |
2026年新趋势:"空窗期证明"
越来越多面试官不再只看你说什么,而是要求你证明你在空窗期做了什么:
- 要求打开GitHub看你的 commit 记录
- 让你现场解释一篇技术博客的技术细节
- 问你某个开源项目的代码实现
所以:如果你有空窗期,一定要有可验证的输出(项目、博客、开源贡献)。
面试话术:
"空窗期不是污点,关键是你要证明这段时间没浪费。最好的做法是在简历里就把空窗期写进去,配上具体的学习和项目产出。面试时被问到,就用'原因-行动-决心'三句话讲清楚。"
Q19: 产品公司 vs AI初创公司,技术面考察差异?怎么选?
🧠 图解记忆: 产品公司重系统和稳定性,初创公司重速度和创造力——知道考什么、要什么,面试表现才精准。
💡 答案要点
两种公司类型的面试风格完全不同,不能一套方法走天下:
产品型公司(大厂/互联网)的面试特点
📋 考察重点:
- 系统设计能力(占40%):缓存策略、分布式、高可用
- 性能优化(占25%):SQL调优、JVM/Go runtime、 profiling
- 工程规范(占20%):Code Review、CI/CD、监控告警
- 基础八股(占15%):数据结构、操作系统、计算机网络

🔍 高频考题:
- \"你的系统QPS从1000涨到10万怎么扩容?\"
- \"如何设计一个支持百万并发的消息通知系统?\"
- \"Redis缓存穿透/雪崩怎么处理?\"
- \"MySQL慢查询怎么排查和优化?\"
AI初创公司的面试特点
📋 考察重点:
- AI技术深度(占45%):RAG设计、Prompt优化、Agent架构
- 快速原型能力(占25%):能不能一天搭出一个可用Demo
- 业务理解(占20%):知不知道自己的产品在解决什么问题
- 学习能力(占10%):新技术上手速度

🔍 高频考题:
- \"给你的3天时间,你怎么做一个AI客服Demo?\"
- \"怎么让一个LLM准确理解你们行业的专有术语?\"
- \"如果用LangChain太慢了,你会怎么自己搞一个?\"
- \"竞品XX做了类似功能,你觉得我们和他们有什么区别?\"
选择建议
| 维度 | 产品公司适合 | AI初创适合 |
|---|---|---|
| 职业阶段 | 0-3年,打基础 | 2-5年,追求影响力 |
| 技能类型 | 系统工程强 | 快速创新力强 |
| 风险偏好 | 求稳定 | 能承受不确定性 |
| 技术目标 | 成为资深后端/架构师 | 成为AI应用专家 |
面试话术:
"面试时要根据公司性质切换模式。去产品公司就展示工程素养和系统性思考;去AI初创就展示技术热情和快速执行能力。知道自己要去哪种公司,面试表现就不会跑偏。"
Q20: 面试中遇到不会的题怎么办?(高频救命题)
🧠 图解记忆: 不会不可怕,乱编才致命。承认无知 + 展示思路 + 承诺学习,是最高级的回答方式。
💡 答案要点
核心原则:宁可说"我不会",也不要瞎编。 AI面试中,瞎编的后果比不会严重得多——因为面试官可以立刻用深入追问把你拆穿。
四步应对框架:
第一步:坦诚承认(不找借口)
\"这个问题我目前没有深入研究过,说实话我不太确定答案。\"

第二步:展示思路(展现思考能力)
\"不过我可以分享一下我的推测/理解...\"
\"虽然没有直接经验,但从我熟悉的XX方向来看,可能涉及...\"

第三步:建立联系(用已知推未知)
\"这和我在XX项目中遇到的YY问题有点类似,当时的解法是...\"

第四步:表态学习(留下好印象)
\"今天您提到的这一点对我很有启发,回来后我会补一下相关知识。\"
实战场景示例:
面试官:\"你知道MoE(混合专家)模型是怎么做负载均衡的吗?\"

❌ 错误回答1(硬编):
\"额...就是用路由网络把token分配给不同的专家吧...\"

❌ 错误回答2(嘴硬):
\"这个其实挺简单的,就是一个门控机制嘛,Gating Network...\"

✅ 正确回答:
\"坦率说,MoE的具体实现细节我之前没有深入研究过。但我从Transformer的基本架构理解,它应该是通过一个门控网络来决定哪些tokens由哪些专家处理。我在论文里看过类似的注意力机制,可能是某种稀疏化的注意力模式?
另外我从RAG方向的角度看,如果让我设计的话,我会先考虑如何评估各专家的负载是否均衡——可能跟你们现有的负载均衡方案有相通之处。
这个问题确实是我的知识盲区,回去我会好好补一下。感谢您的指点!\"
什么时候可以尝试猜测?
- 题目和你知道的知识高度相关,可以类比推理
- 面试官在给你提示,顺着提示往下推导
- 是开放性设计题,没有标准答案
什么时候坚决不能说"我会"?
- 完全没见过相关概念
- 涉及到核心业务逻辑
- 后续会有深入追问
面试话术:
"我经历过不少面试,总结出两条原则:一不会就是不会,不丢人;二要说'我试试看'就一定要真的试,哪怕只能说出部分思路也比沉默强。AI面试最怕的就是装懂,因为技术面试官一眼就能听出来。"
Q21: 如何用STAR法则写AI Side Project的经历?(应届生/无经验必备)
🧠 图解记忆: 个人项目不需要上线百万用户,STAR法则的关键是把每一个动作写成可验证的工程决策。
💡 答案要点
现状: 越来越多AI岗位JD明确要求"有RAG/Agent项目经验",但没有正式工作经验的人怎么做?答案是做Side Project并用STAR法描述。
Side Project 的类型选择(至少完成1-2个):
| 类型 | 推荐技术栈 | 复杂度 | 面试价值 | |------|----------|--------|---------|| | 📖 知识库问答RAG | LangChain/BGE-M3/Milvus | ⭐⭐⭐ | 🔥🔥🔥🔥🔥 最高频考点 | | 🤖 ReAct Agent | LangGraph/OpenAI Agents SDK | ⭐⭐⭐⭐ | 🔥🔥🔥🔥 次高频 | | 🔗 MCP Server | FastAPI + MCP Protocol | ⭐⭐⭐ | 🔥🔥🔥 差异化加分 | | 🧩 Prompt编排工具 | LangSmith/文心一言 | ⭐⭐ | 🔥🔥 基础够用 |
STAR描述模板(以RAG为例):
【Situation 背景】
大学生想整理课程笔记但不想每次都手动搜索

【Task 任务】
做了一个本地知识库问答工具,支持多种格式文档导入和语义检索

【Action 行动】
- 实现了PDF/Markdown/TXT等多格式解析 pipeline
- 使用BGE-M3生成向量存储到ChromaDB
- 设计了动态Chunk策略(按语义边界切分而非固定长度)
- 加入了Query Rewrite提升复杂问题的召回率

【Result 结果】
完成了3本教材的索引(约2000页),检索准确率实测达到85%,
在知乎分享了构建过程获得500+赞。
⚠️ 避坑指南:
- 不要把 Demo 吹成生产项目,面试官一问细节就露馅
- 不说"日活多少用户"(个人项目没有DAU),说"测试集上准确率提升多少"
- 强调你遇到了什么困难、怎么解决的,而不只是"我做完了"
- GitHub仓库必须有README,至少包含架构图和使用说明
面试话术:
"我的Side Project虽然是小项目,但我把它当真正的项目来对待:有架构图、有技术方案选型理由、有测试结果对比。面试时我不怕被追问,因为我确实一步步做过。"
Q22: AI岗位的"绩效面谈"和年终述职该怎么准备?(晋升答辩)
🧠 图解记忆: 年终述职不是记流水账,而是一份工程证据链——每页都在回答"你的价值在哪里"。
💡 答案要点
背景: 2026年AI团队扩张迅速,很多人第一次面临晋升答辩或绩效面谈。这和求职面试完全不同——你是内部人,要用内部语言说话。
述职PPT结构(15分钟演示 + 10分钟答疑):
第1页:一页纸总结(电梯演讲版)
- 今年主要负责什么(一句话)
- 最大的3个成果(用数据说话)
- 明年计划和期望晋升

第2-4页:重点项目A(业务价值最大)
- 背景与挑战
- 技术方案(架构图 + 关键决策)
- 量化成果(Before/After对比)

第5-6页:重点项目B(技术创新最大)
- 为什么做这个创新
- 踩过的坑
- 最终效果

第7页:跨团队协作与赋能
- 指导了谁
- 沉淀了什么文档/工具
- 推动了什么流程改进

第8页:个人成长与反思
- 学到了什么
- 哪里做得不够
- 明年计划
AI岗位特有的述职技巧:
| 传统述职套路 | AI岗位正确打开方式 |
|---|---|
| "我提升了系统性能" | "我把RAG系统的P99延迟从800ms降到280ms,用的是SGLang连续批处理+KV cache复用" |
| "我优化了数据库" | "我把Milvus的index类型从IVF_FLAT改成HNSW,查询延迟降低60%,内存占用增加15%(做了trade-off分析)" |
| "我做了Agent系统" | "设计了3个Tool Agent分工协作,覆盖90%的用户意图,人工介入率从85%降到27%" |
⚠️ 关键误区:
- ❌ 只列做了什么,不说不做会怎样
- ❌ 堆砌技术名词但说不出业务影响
- ❌ 只说自己的功劳,不提团队贡献
面试话术:
"述职报告的本质是让评委看完就想给你升职。每一页都要回答三个问题:①我解决了什么有价值的问题?②我是用什么方法解决的?③结果有多好(必须量化)?这三要素缺一不可。"
Q23: "你为什么想来我们公司?"——这个回答怎么讲不打折?(经典十级考题)
🧠 图解记忆: 这不是夸公司的好比赛,而是一场论证——用数据和事实证明为什么是这家公司而不是别人。
💡 答案要点
高频级别: 🔥🔥🔥🔥🔥 几乎每场终面都会问
底层考察点:
- 你是否真的做了功课?(还是海投?)
- 你的职业规划是否与公司能提供的一致?
- 你的动机是否真实可信?(vs 为了钱/户口/随便投的)
三层结构法(万能模板):
【第1层:信息输入】证明你认真看了公司信息
\"我先调研了贵司的情况,了解到[具体的产品/技术/新闻]...\"

【第2层:价值对齐】你的技能与公司需求对接
\"我看到这个岗位需要[具体技术要求],而这正是我过去N年积累的方向...\"

【第3层:情感连接】为什么是这家特定的公司
\"最重要的是[具体原因],这和我个人的[价值观/职业目标]很契合...\"
高质量回答示例(以字节跳动为例):
\"首先我注意到字节最近在大力推广豆包和多模态对话,这在行业内是一个很强的信号——说明公司对AI的体验和可用性非常重视,不只是停留在技术层面。

其次,我看到了这个岗位要求的多Agent系统设计和RAG优化经验,恰好是我过去一年在做的事情。我搭建过一个基于ReAct+Tool设计的客服Agent,用了LangGraph做状态管理,还针对检索准确率做了Hybrid Retrieval + Rerank的完整pipeline。

最后,我一直觉得一个好的AI产品应该让用户感受不到技术的存在——操作自然、回答准确、响应迅速。而字节在多模态交互方面的探索正好体现了这个理念。如果加入团队,我希望把这个理念落实到日常开发中,做出真正好用的产品。\"
❌ 绝对不要说的版本:
- "听说你们公司钱多" → 可以说薪酬有竞争力,但不能作为主因
- "不想在传统行业干了,想试试AI" → 显得你没有明确规划
- "你们公司规模大,稳" → 过于功利且显得缺乏热情
- "我没什么想法,就来试试" → 自杀式回答
面试话术:
"这个问题的本质是'你和我们要干的这件事有没有缘分'。所以答案必须具体、真实、有证据——提到对方的产品、技术路线、或者行业动向,证明自己真的了解他们,不是群发式的面试。"
Q24: 技术转AI岗,非科班出身容易被刷吗?(常见焦虑)
🧠 图解记忆: 2026年的AI岗位不缺算法博士,缺的是能把AI落地的工程师——工程能力是稀缺品。
💡 答案要点
真相: 2026年AI应用开发岗大量招聘的不是算法研究员,而是AI应用工程师——这种人更需要工程能力和业务理解,不是纯数学功底。
非科班的真实处境:
❌ 你可能担心:
- \"我没有计算机理论基础\"
- \"我没有硕士/博士学位\"
- \"我不懂数学,看不懂论文\"

✅ 实际上招聘方看重:
- \"你能不能把一个LLM API做成可用的产品?\"
- \"你能不能优化RAG系统让它跑得又快又准?\"
- \"你能不能设计一个Agent处理真实场景的异常?\"
- \"你能不能扛住生产环境的各种坑?\"
竞争策略(扬长避短):
🔹 如果你的优势是工程能力(如后端开发):
  → 强调:你能把AI技术变成稳定、可扩展的系统
  → 举例:高并发、微服务、部署运维经验
  → 话术:\"AI应用落地的最大瓶颈不是模型本身,而是工程化。我的后端经验正好弥补这个缺口。\"

🔹 如果你的优势是产品思维(如产品经理转):
  → 强调:你能理解用户需求,设计出真正好用的AI产品
  → 举例:用户调研、需求文档、数据驱动决策
  → 话术:\"很多技术人能写出准确的RAG,但写不出用户愿意用的产品。我能兼顾技术和用户体验。\"

🔹 如果你是应届生:
  → 强调:学习能力强,没有被旧范式束缚
  → 举例:Side Project、开源贡献、技术博客
  → 话术:\"虽然我不是科班出身,但我通过自建项目和社区贡献已经在实践中补齐了AI基础知识。\"
非科班需要补齐的底线(避免被刷):
必须掌握(不管什么背景,至少要达到):
1. LLM基本原理(Transformer架构、Attention、Tokenization)
2. RAG全流程(Embedding → 检索 → Rerank → Generation)
3. 至少一个框架的使用(LangChain/LlamaIndex/Dify)
4. Python基础编程能力
5. 至少一个完整的AI项目(无论大小)

可以不精通(面试够用即可):
- 复杂的深度学习理论
- 模型预训练细节
- 数学推导能力
面试话术:
"非科班不是缺陷,关键是找到差异化定位。AI应用开发的门槛从来不是'谁能看懂BERT论文',而是'谁能把AI变成一个可用的、稳定的、赚钱的产品'。如果你有工程能力、有AI项目经验、能清晰表达——你就有足够的竞争力。"
🎯 面试前 Checklist
技术准备:
- [ ] LLM 基础概念(Transformer、Attention、Token 化)
- [ ] RAG 系统设计(向量检索、混合检索、rerank)
- [ ] Agent 设计(ReAct、工具调用、多 Agent)
- [ ] Prompt 工程(CoT、Few-shot、参数调优)
- [ ] 性能优化(缓存、批处理、流式输出)
项目准备:
- [ ] 准备 2-3 个项目,能深入讲解
- [ ] 量化项目成果(准确率、响应时间、成本)
- [ ] 准备遇到的坑和解决方案
- [ ] 准备技术选型依据
软技能准备:
- [ ] 自我介绍(1 分钟)
- [ ] 职业规划(3-5 年)
- [ ] 离职原因(正面表述)
- [ ] 期望薪资(有理有据)
其他准备:
- [ ] 了解公司业务和产品
- [ ] 准备 2-3 个问题问面试官
- [ ] 打印简历(2 份)
- [ ] 提前 10 分钟到达
📚 参考资料
📄 示例简历
以下是一份示例简历,供参考。请根据自己的实际情况修改。
📄 个人简历示例
姓名: 张 ×× 求职意向: AI 应用开发工程师 / Golang 后端开发工程师 工作年限: 5 年 意向城市: 北京
👤 基本信息
- 电话: 134****1193
- 邮箱: guocong199708@163.com
- GitHub: https://github.com/xxx-xxx
- 出生: 199× 年 × 月
🎯 个人总结
5 年 Go 后端开发经验,2 年 AI 应用开发经验。擅长将 LLM 技术落地到实际业务场景,有从 0 到 1 构建 AI 应用的经验。
核心优势:
- 扎实的 Go 后端功底(高并发、微服务)
- 熟悉 AI 应用开发全流程(RAG、Agent、Prompt 工程)
- 有千万级用户项目经验
- 技术社区运营经验(Go 必知必会公众号)
💼 工作经历
××科技有限公司 | 2025.04 - 至今
职位: Golang 后端开发工程师 / AI 应用开发工程师
项目 1:××读书项目(海外)
- 2000w 用户,ROI 300%
- Go 后端开发、AI 应用开发
项目 2:××宗教项目(海外)
- 80w 日活,日营收 8w 人民币
- Go 后端开发、AI 应用开发
××互动科技有限公司 | 2023.04 - 2025.03
职位: Golang 后端开发工程师
项目:短剧平台
- 530w 用户,80w DAU
- 200 余部短剧,投出多部爆款
- 单日播放 170w 次,单日充值 350w
- 2023 年累计充值 230w 次,年营收 1200w
××教育科技股份有限公司 | 2021.03 - 2023.04
职位: Golang 后端开发工程师
项目 1:教师培训平台
- 服务用户 90w,涉及中小学 2.6w 所
- 基于 Gin 框架,RabbitMQ 解决高并发
项目 2:网络研修平台
- 微服务架构,k8s 容器编排
- 组织管理控制台,类似钉钉
项目 3:零信任安全项目
- 替代传统 VPN
- 高危账号阻截,保护网络安全
🚀 AI 项目经验
AI 编程辅助项目
- GitHub: https://github.com/xxx-xxx
- AI 编程项目,使用 Cursor、Claude Code 等 AI 编程工具开发
- 探索 AI 辅助编程最佳实践
MCP 协议服务器
- MCP (Model Context Protocol) 服务器
- 连接 API 文档与 AI 编程工具
- 提升 AI 编程效率
语音转文字小程序
- 微信小程序,语音转文字功能
- 注册用户 400+ 人
- 从 0 到 1 完整项目经验
💻 技术栈
核心技能
- Golang - 精通,5 年生产经验
- AI 应用开发 - RAG、Agent、Prompt 工程
- 数据库 - 精通 MySQL、Redis
- 框架 - 熟悉 Gin、Gorm、LangChain
- 网络 - HTTP/HTTPS、gRPC、TCP/IP
- 消息队列 - RabbitMQ、Kafka、Canal
AI 技术栈
- LLM: GPT-4o、Claude 3.5、DeepSeek、Llama 3
- 框架: LangChain、LlamaIndex
- 向量库: Chroma、Milvus、pgvector
- Embedding: OpenAI text-embedding-3、BGE-M3
🏆 所获成就
- 技术社区开创者 - 公众号 1000+ 粉丝
- 《开发规范手册》参与制定者 - 牵头整理项目架构
- 公司年度技术之星 - 年度奖项
- 技术社区、B 站、博客平台技术分享作者
🎓 教育背景
2017.09 - 2021.06 ××大学 | 计算机科学与技术(统招本科)
主修课程:数据结构、算法分析、操作系统、计算机网络、Java 开发
📝 项目介绍话术(面试用)
介绍 AI 编程辅助项目
"这是我探索 AI 辅助编程的标杆项目。我用 Cursor、Claude Code 等 AI 编程工具开发,探索如何将 AI 深度融入开发流程。
核心收获有三点:
- AI 不是替代程序员,而是放大程序员的能力
- Prompt 质量直接影响 AI 输出质量
- 工程化能力(测试、部署、监控)依然是核心竞争力
这个项目让我从'用 AI'到'懂 AI',为转型 AI 应用开发打下了基础。"
介绍 AI 转型
"我从 2026 年初开始系统学习 AI 应用开发,重点补足了三个领域:
- LLM 原理 - Transformer 架构、Token 化、注意力机制
- RAG 系统 - 向量数据库、混合检索、rerank、上下文压缩
- Agent 设计 - ReAct、Plan-and-Execute、多 Agent 协作
我的优势是:有扎实的后端功底,理解工程落地的挑战。AI 应用开发不仅仅是 Prompt,更多是对确定性工程和非确定性模型输出之间的边界管理。"
📄 简历文件
| 文件 | 说明 |
|---|---|
| resume-go.md | Go 后端简历(Markdown) |
| resume-go.html | Go 后端简历(HTML) |
| resume-ai.md | AI 应用开发简历(Markdown) |
| resume-ai.html | AI 应用开发简历(HTML) |
🌟 个人特长
- 合作、沟通、自学、坚韧、勤奋
- 兴趣爱好:阅读、骑行、游泳
最后更新: 2026-03-02
上一模块: 高级专题
版本: v0.1 | 更新: 2026-09-11 | by 二狗子 🐕 | 新增 Q15–Q24(自我介绍、Offer比较、反向提问、空窗期、产品vs初创、不会的题、Side Project STAR、年终述职、动机问答、非科班转AI)