⚡ LLM 推理优化面试题
面试优先顺序(通用 AI 应用开发岗位):Q2、Q3、Q5、Q6、Q7、Q8、Q9、Q10、Q11、Q13、Q15、Q16、Q17、Q18、Q19、Q20、Q21、Q22。其余题目用于进阶或特定岗位拓展;实际频率会随岗位和面试轮次变化,产品版本资讯不应当作通用必考题。
难度: ⭐⭐⭐⭐⭐ 更新: 2026-10-22 考点: KV Cache、量化、推理加速、部署优化、分布式并行、结构化输出、MoE 推理、生产运维
📋 目录
一、推理基础
Q1: LLM 推理和训练有什么区别?为什么推理更难优化?
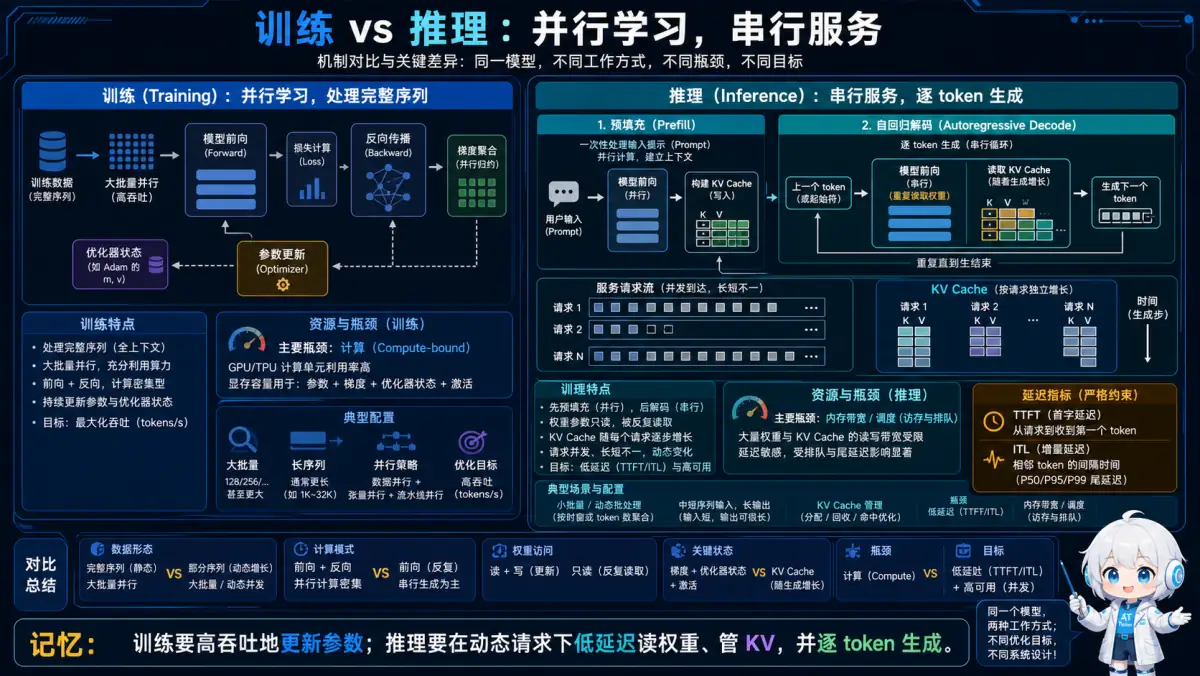
🧠 记忆锚点:训练要高吞吐地更新参数;推理要在动态请求下低延迟读权重、管 KV,并逐 token 生成。
💡 答案要点
核心区别:
| 维度 | 训练 | 推理 |
|---|---|---|
| 计算模式 | 并行(整句) | 串行(逐token) |
| 瓶颈 | 计算(FLOPs) | 内存带宽(I/O) |
| 批处理 | 大(128-1024) | 小(1-32) |
| 延迟要求 | 不敏感 | 极度敏感(<1s) |
| 显存占用 | 模型+梯度+优化器 | 模型+KV Cache |
为什么推理难优化?
自回归生成是串行的
训练:一次性处理整个句子
"今天天气真好" → 并行计算所有token

推理:一个个生成token
"今天" → "天气" → "真" → "好" (必须串行)
内存带宽瓶颈(Memory-bound)
每生成1个token:
- 需要加载整个模型参数(7B = 14GB)
- 计算量很小(几十 GFLOPS)
- GPU 利用率 < 10%

问题:GPU 算力浪费,等待内存加载
KV Cache 增长
上下文越长,KV Cache 越大
4K 上下文:1GB
128K 上下文:32GB

显存炸了!
性能对比(7B 模型,A100 GPU):
| 场景 | 吞吐量 | GPU 利用率 |
|---|---|---|
| 训练 | 1000 tokens/s | 80-90% |
| 推理(batch=1) | 50 tokens/s | 5-10% |
| 推理(batch=32) | 800 tokens/s | 40-50% |
面试话术:
"推理的核心挑战是内存带宽瓶颈。训练是计算密集型,推理是访存密集型。优化思路完全不同:训练优化算法,推理优化内存访问。"
Q2: 什么是自回归生成?Prefill 和 Decode 有什么区别?
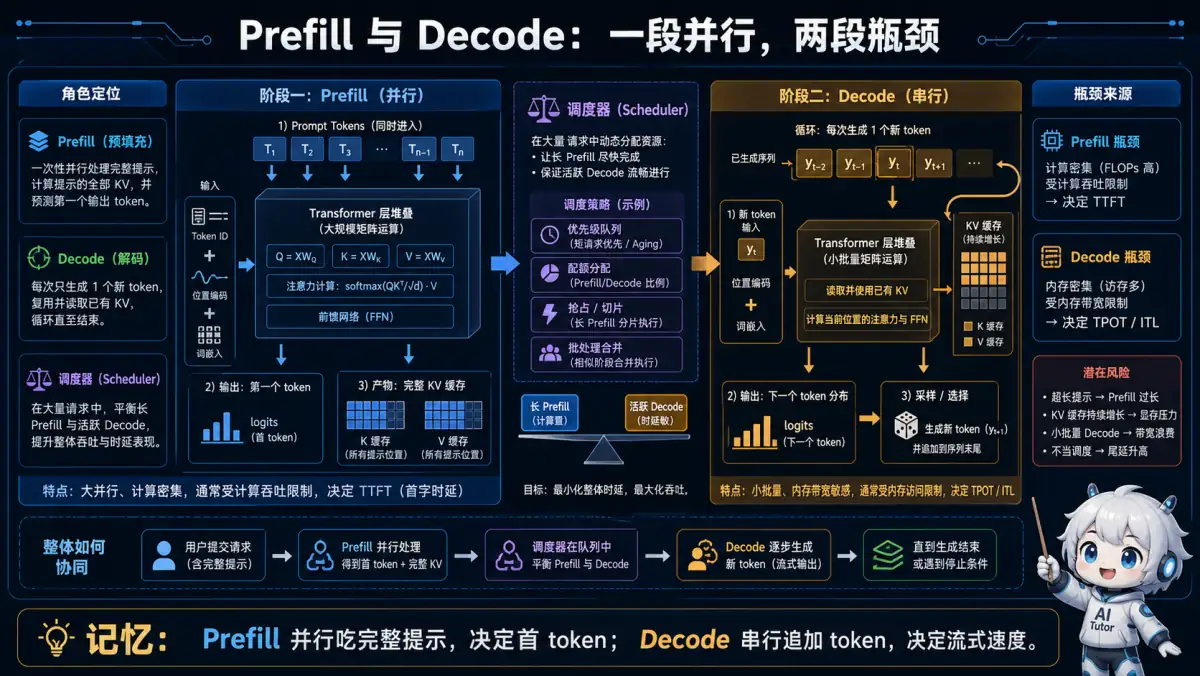
🧠 记忆锚点:Prefill 并行吃完整提示,决定首 token;Decode 串行追加 token,决定流式速度。
💡 答案要点
自回归生成 = 逐个生成 token,每个 token 依赖前面所有 token
两个阶段:
┌─────────────────────────────────────────────────────────┐
│                  LLM 推理两阶段                          │
└─────────────────────────────────────────────────────────┘

Prefill(预填充)阶段:
  输入:用户提示词(如 1000 tokens)
  输出:第一个生成 token
  特点:并行计算,计算密集

Decode(解码)阶段:
  输入:已生成的 tokens
  输出:下一个 token
  特点:串行生成,访存密集
详细对比:
| 维度 | Prefill | Decode |
|---|---|---|
| 计算模式 | 并行(整个 prompt) | 串行(一个 token) |
| 计算量 | 大(O(n²)) | 小(O(n)) |
| 瓶颈 | 计算(Compute-bound) | 内存(Memory-bound) |
| GPU 利用率 | 高(80-90%) | 低(5-15%) |
| 延迟 | 一次性(200-500ms) | 累积(每个 20-50ms) |
| KV Cache | 生成 | 复用 |
示例(生成 "今天天气真好"):
输入:"请用5个字描述今天的天气"(15 tokens)

Prefill 阶段:
  输入:整个 prompt(15 tokens)
  计算:一次性算出所有 token 的 KV
  输出:"今"
  时间:200ms

Decode 阶段:
  循环5次:
    输入:"今" → 输出:"天"(50ms)
    输入:"今天" → 输出:"天"(50ms)
    输入:"今天天" → 输出:"气"(50ms)
    输入:"今天天气" → 输出:"真"(50ms)
    输入:"今天天气真" → 输出:"好"(50ms)
  总时间:250ms

总延迟:200ms + 250ms = 450ms
优化策略:
| 阶段 | 优化方向 | 技术 |
|---|---|---|
| Prefill | 提升计算效率 | FlashAttention、Tensor并行 |
| Decode | 减少内存访问 | KV Cache量化、PagedAttention |
面试话术:
"Prefill 是一次性算完 prompt,Decode 是逐个生成。Prefill 吃算力,Decode 吃带宽。优化重点完全不同。"
二、KV Cache优化
Q3: 什么是 KV Cache?为什么需要它?
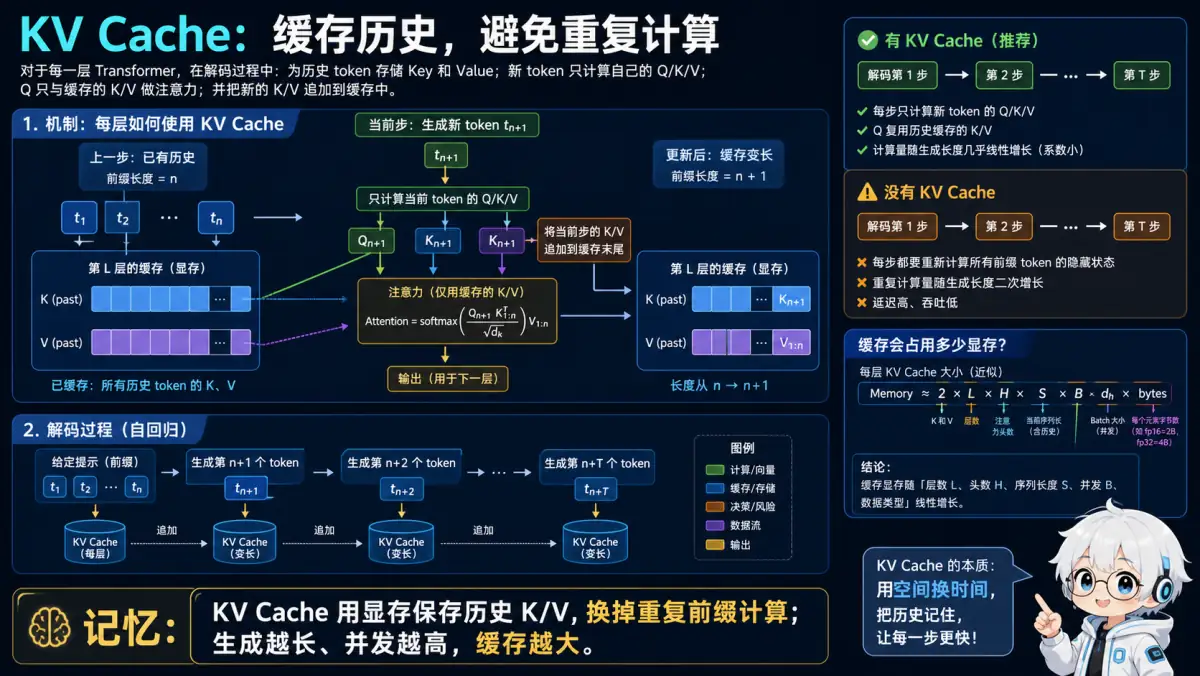
🧠 记忆锚点:KV Cache 用显存保存历史 K/V,换掉重复前缀计算;生成越长、并发越高,缓存越大。
💡 答案要点
KV Cache = 缓存 Attention 计算的中间结果
为什么需要 KV Cache?
没有 KV Cache(重复计算):
生成 token1:"今"
  计算 Attention(prompt)

生成 token2:"天"
  计算 Attention(prompt + "今")  ← 重复计算了 prompt

生成 token3:"气"
  计算 Attention(prompt + "今天")  ← 又重复了

...

问题:每生成一个 token,都要重新计算所有历史的 Attention
时间复杂度:O(n²),n 是生成长度
有 KV Cache(缓存复用):
生成 token1:"今"
  计算 Attention(prompt),缓存 KV

生成 token2:"天"
  只计算 "今" 的 KV,复用 prompt 的 KV Cache

生成 token3:"气"
  只计算 "天" 的 KV,复用之前的 KV Cache

...

优化:每个 token 只计算一次
时间复杂度:O(n)
数学原理:
Attention(Q, K, V) = softmax(QK^T / √d) V

生成第 t 个 token:
  Q_t:当前 token 的 Query
  K_{1:t-1}:历史所有 token 的 Key(从 Cache 读取)
  V_{1:t-1}:历史所有 token 的 Value(从 Cache 读取)

只需计算:
  K_t, V_t:当前 token 的 KV(新计算)
  然后拼接到 Cache
性能对比(生成 100 tokens):
| 方案 | 总计算量 | 延迟 |
|---|---|---|
| 无 Cache | 5050 次 Attention | 25s |
| 有 Cache | 100 次 Attention | 5s |
| 加速比 | 50x | 5x |
KV Cache 显存占用:
单个 token 的 KV 大小:
  K: [num_layers, num_heads, head_dim]
  V: [num_layers, num_heads, head_dim]

示例(Llama 7B):
  层数:32
  头数:32
  头维度:128
  精度:FP16(2 bytes)

  单 token KV = 2 × 32 × 32 × 128 × 2 = 524KB
  4K 上下文 = 524KB × 4096 = 2GB
  128K 上下文 = 524KB × 131072 = 64GB
面试话术:
"KV Cache 是用空间换时间的经典案例。不用 Cache,每个 token 要重新计算所有历史,O(n²) 复杂度。用了 Cache,复用历史结果,降到 O(n)。代价是显存占用大,长上下文会炸显存。"
Q4: KV Cache 量化是什么?如何实现?
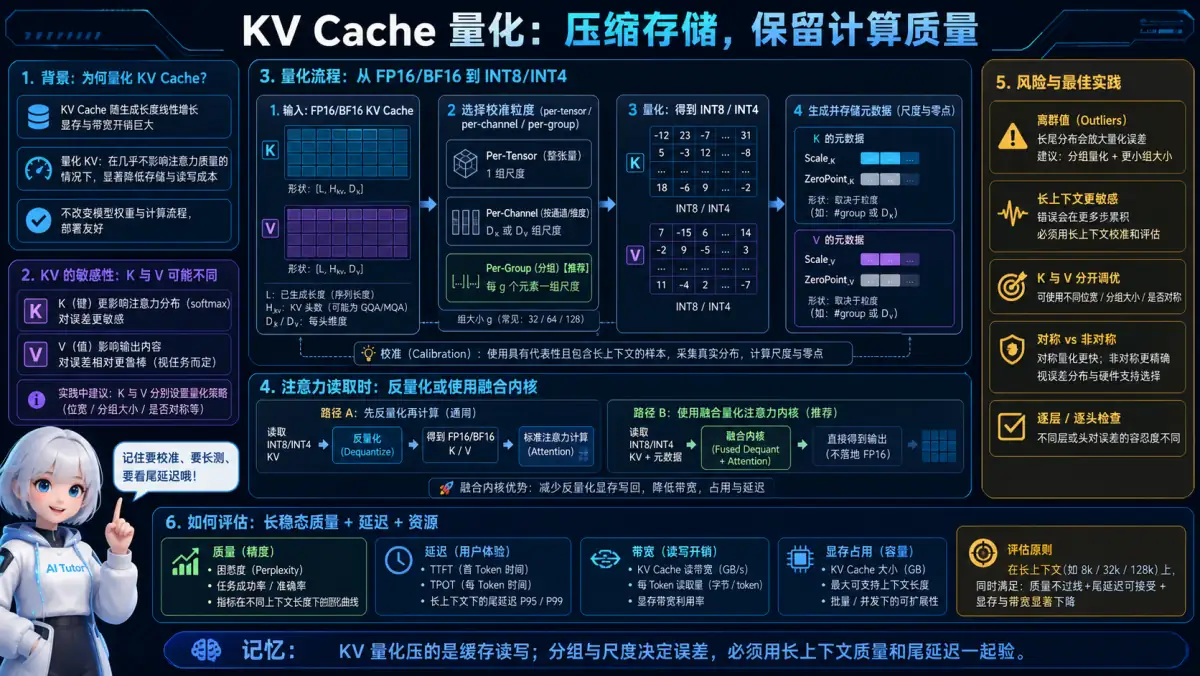
🧠 记忆锚点:KV 量化压的是缓存读写;分组与尺度决定误差,必须用长上下文质量和尾延迟一起验。
💡 答案要点
KV Cache 量化 = 用低精度存储 KV Cache
核心思想: KV Cache 占显存太多,用 INT8/INT4 代替 FP16
精度对比:
| 精度 | 每个值占用 | 4K 上下文占用(7B 模型) |
|---|---|---|
| FP16 | 2 bytes | 2GB |
| INT8 | 1 byte | 1GB(节省 50%) |
| INT4 | 0.5 byte | 0.5GB(节省 75%) |
量化方法:
1. 对称量化(Symmetric Quantization):
# 量化
scale = max(abs(tensor)) / 127
quantized = round(tensor / scale).clamp(-128, 127).to(int8)

# 反量化
dequantized = quantized.to(float16) * scale
2. 非对称量化(Asymmetric Quantization):
# 量化
min_val = tensor.min()
max_val = tensor.max()
scale = (max_val - min_val) / 255
zero_point = round(-min_val / scale)
quantized = round(tensor / scale + zero_point).clamp(0, 255).to(uint8)

# 反量化
dequantized = (quantized.to(float16) - zero_point) * scale
3. 分组量化(Group-wise Quantization):
# 问题:全局量化精度损失大
# 解决:分组量化,每组独立 scale

# 将 tensor 分成 N 组
groups = tensor.reshape(N, -1)

# 每组独立量化
for i, group in enumerate(groups):
    scale[i] = group.abs().max() / 127
    quantized[i] = round(group / scale[i])
KV Cache 的特殊性:
| 特点 | 影响 | 解决方案 |
|---|---|---|
| 动态性 | 每个 token 都在变 | 动态量化 |
| 异常值 | 某些通道值特别大 | Per-channel 量化 |
| Key vs Value | Key 对精度更敏感 | Key用INT8,Value用INT4 |
实现示例(Per-channel INT8):
class KVCacheQuantizer:
    def quantize_kv(self, k, v):
        # Key: per-channel INT8(精度要求高)
        k_scale = k.abs().max(dim=-1, keepdim=True)[0] / 127
        k_quant = (k / k_scale).round().clamp(-128, 127).to(torch.int8)

        # Value: per-token INT4(可以更激进)
        v_scale = v.abs().max(dim=-1, keepdim=True)[0] / 7
        v_quant = (v / v_scale).round().clamp(-8, 7).to(torch.int8)

        return k_quant, k_scale, v_quant, v_scale

    def dequantize_kv(self, k_quant, k_scale, v_quant, v_scale):
        k = k_quant.to(torch.float16) * k_scale
        v = v_quant.to(torch.float16) * v_scale
        return k, v
精度损失评估(Llama 7B,MT-Bench):
| 方案 | 显存节省 | 困惑度增加 | 任务准确率下降 |
|---|---|---|---|
| FP16 | 0% | 0 | 0% |
| INT8(全局) | 50% | +5% | -3% |
| INT8(per-channel) | 50% | +1% | -0.5% |
| INT4(per-channel) | 75% | +8% | -2% |
| 混合(K=INT8, V=INT4) | 60% | +2% | -1% |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "KV Cache 量化是推理优化的关键。我在项目中用 per-channel INT8 量化,显存节省 50%,精度损失不到 1%。核心是处理好异常值,用分组/分通道量化代替全局量化。"
Q5: 什么是 PagedAttention?它解决什么问题?
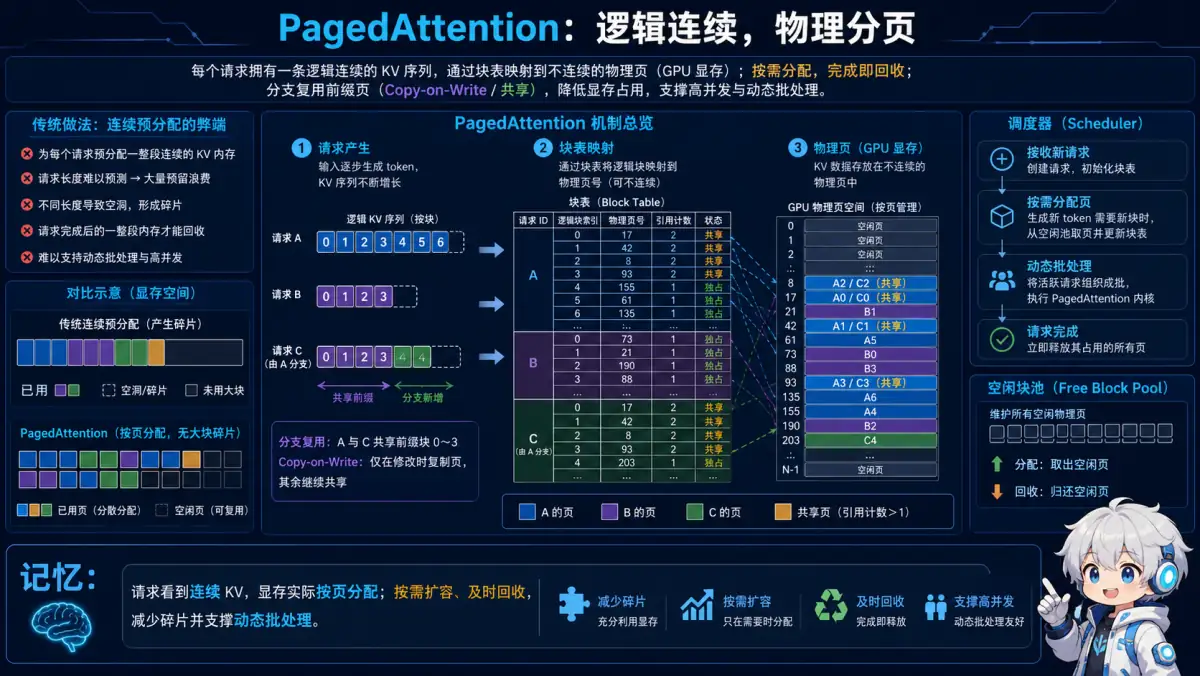
🧠 记忆锚点:请求看到连续 KV,显存实际按页分配;按需扩容、及时回收,减少碎片并支撑动态批处理。
💡 答案要点
PagedAttention = 把 KV Cache 分页管理,像操作系统管理内存一样
解决的核心问题:KV Cache 碎片化和浪费
传统方案的问题:
传统:为每个请求预分配固定大小的 KV Cache

请求1:预估 2K tokens,实际用了 500
  → 浪费 1500 个 token 的空间

请求2:预估 1K tokens,实际用了 1200
  → 超出了,只能截断或重新分配

问题:
1. 预分配浪费空间(平均浪费 30-50%)
2. 长度不确定,要么截断要么OOM
3. 内存碎片化严重
PagedAttention 方案:
┌─────────────────────────────────────────────────────────┐
│                  PagedAttention                          │
└─────────────────────────────────────────────────────────┘

1. 将 KV Cache 分成固定大小的页(Page)
   每页:64 或 128 tokens

2. 动态分配页
   请求需要多少,就分配多少页

3. 页可以不连续
   物理内存:[Page3, Page7, Page2, ...]
   逻辑视图:连续的 KV Cache

4. 共享页(Prefix Sharing)
   多个请求共享相同的 System Prompt
示例(3个请求):
System Prompt: 500 tokens(所有请求共享)

请求1:"翻译:Hello" → 生成 50 tokens
  页分配:[共享页1-4] + [独占页5]

请求2:"翻译:World" → 生成 80 tokens
  页分配:[共享页1-4] + [独占页6-7]

请求3:"摘要:..." → 生成 200 tokens
  页分配:[共享页1-4] + [独占页8-11]

节省:
  传统:3 × 500 = 1500 tokens(System Prompt)
  PagedAttention:1 × 500 = 500 tokens(共享)
  节省:66%
核心技术:
1. 分页存储:
class PagedKVCache:
    def __init__(self, page_size=64):
        self.page_size = page_size
        self.pages = []  # 物理页池
        self.page_table = {}  # 逻辑地址 → 物理页

    def allocate_page(self):
        if self.free_pages:
            return self.free_pages.pop()
        else:
            page = torch.empty([page_size, hidden_dim])
            self.pages.append(page)
            return len(self.pages) - 1

    def get_kv(self, token_id):
        page_id = token_id // self.page_size
        offset = token_id % self.page_size
        physical_page = self.page_table[page_id]
        return self.pages[physical_page][offset]
2. Copy-on-Write(写时复制):
# 共享页在修改时才复制
if page.ref_count > 1:
    new_page = page.copy()
    page.ref_count -= 1
    page = new_page
性能提升(vLLM,实测数据):
| 指标 | 传统方案 | PagedAttention | 提升 |
|---|---|---|---|
| 吞吐量 | 100 req/s | 240 req/s | 2.4x |
| 显存利用率 | 40% | 90% | 2.25x |
| 平均延迟 | 800ms | 600ms | 1.3x |
面试话术:
"PagedAttention 借鉴了操作系统的虚拟内存思想。分页管理避免了预分配的浪费,Copy-on-Write 实现了高效共享。vLLM 用它把吞吐量提升了 2.4 倍。"
三、模型量化
Q6: 模型量化是什么?INT8/INT4/FP8 有什么区别?
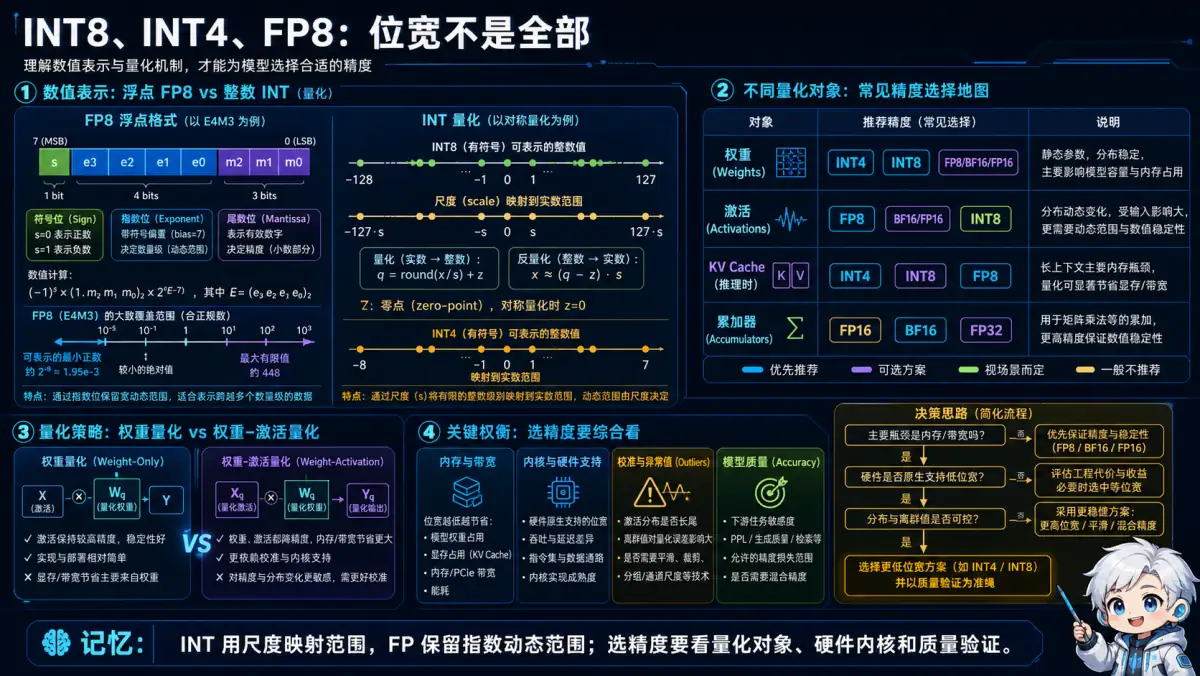
🧠 记忆锚点:INT 用尺度映射范围,FP 保留指数动态范围;选精度要看量化对象、硬件内核和质量验证。
💡 答案要点
模型量化 = 用低精度数值表示模型权重和激活
为什么量化?
降低显存占用 → 降低带宽需求 → 提升推理速度精度对比:
| 数据类型 | 每个值占用 | 表示范围 | 精度 |
|---|---|---|---|
| FP32 | 4 bytes | ±3.4e38 | 7位有效数字 |
| FP16 | 2 bytes | ±6.5e4 | 3-4位有效数字 |
| BF16 | 2 bytes | ±3.4e38 | 2-3位有效数字 |
| FP8 | 1 byte | ±57000 | 2位有效数字 |
| INT8 | 1 byte | -128~127 | 整数 |
| INT4 | 0.5 byte | -8~7 | 整数 |
显存占用对比(7B 模型):
| 精度 | 模型大小 | 节省 |
|---|---|---|
| FP32 | 28GB | 0% |
| FP16 | 14GB | 50% |
| INT8 | 7GB | 75% |
| INT4 | 3.5GB | 87.5% |
量化方法:
1. 后训练量化(PTQ, Post-Training Quantization):
优点:无需重新训练,快速
缺点:精度损失较大
适用:INT8 量化

流程:
  训练好的 FP16 模型 → 校准数据集 → 统计分布 → 确定 scale → 量化
2. 量化感知训练(QAT, Quantization-Aware Training):
优点:精度损失小
缺点:需要重新训练,慢
适用:INT4 量化

流程:
  训练时模拟量化 → 模型学会适应量化误差 → 最终量化
精度类型详解:
FP8(浮点8位):
优势:
  - 保留浮点格式,表示范围大
  - NVIDIA H100/Ada 硬件支持
  - 精度损失小于 INT8

格式:E4M3(4位指数,3位尾数)
  表示范围:±448
  精度:约 2 位有效数字
INT8(整数8位):
优势:
  - 硬件支持广泛(大部分 GPU)
  - 计算快

量化公式:
  scale = max(|W|) / 127
  W_quant = round(W / scale).clamp(-128, 127)
  W_dequant = W_quant * scale
INT4(整数4位):
优势:
  - 极致压缩(87.5% 节省)
  - 适合超大模型

挑战:
  - 精度损失大
  - 需要分组量化

方法:GPTQ, AWQ
  每 128 个权重一组
  每组独立 scale
精度对比(Llama 7B,MMLU):
| 精度 | 准确率 | 相对 FP16 |
|---|---|---|
| FP16 | 46.8% | 0% |
| FP8 | 46.5% | -0.3% |
| INT8(PTQ) | 45.9% | -0.9% |
| INT8(QAT) | 46.4% | -0.4% |
| INT4(GPTQ) | 44.2% | -2.6% |
| INT4(AWQ) | 45.8% | -1.0% |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "量化是推理优化的核心。FP8 需要新硬件但精度好,INT8 兼容性好,INT4 压缩率高。我在项目中用 INT8 PTQ,显存降了 50%,准确率只降 1%。"
Q7: GPTQ、AWQ 是什么?它们有什么区别?
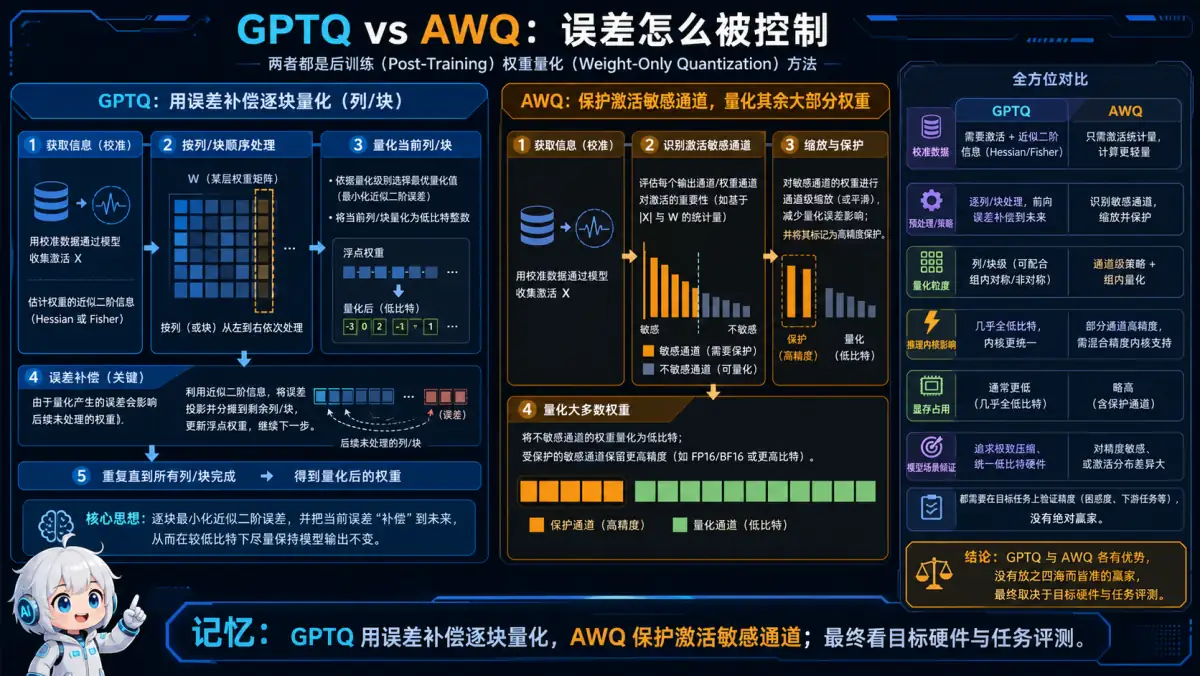
🧠 记忆锚点:GPTQ 用误差补偿逐块量化,AWQ 保护激活敏感通道;最终看目标硬件与任务评测。
💡 答案要点
GPTQ 和 AWQ 都是 INT4 权重量化方法
核心挑战: 直接 INT4 量化精度损失大(>5%),需要智能量化
GPTQ(GPT Quantization):
核心思想: 最小化量化误差
目标:找到量化权重 W_q,使得:
  误差 = ||WX - W_qX||² 最小

算法(逐层量化):
  1. 用校准数据集收集激活值 X
  2. 计算 Hessian 矩阵(二阶导数)
  3. 逐列量化权重,最小化误差
  4. 更新后续列以补偿误差
优势:
- 数学严谨,误差最小
- 支持极低比特(2-4 bit)
劣势:
- 量化慢(需计算 Hessian)
- 推理时需要分组反量化
AWQ(Activation-aware Weight Quantization):
核心思想: 保护重要权重
观察:
  某些权重对应的激活值特别大
  这些权重的量化误差影响更大

策略:
  1. 分析激活值分布
  2. 重要通道(激活值大):保持高精度或加大 scale
  3. 不重要通道:可以激进量化
算法:
# 1. 收集激活值
activations = []
for batch in calibration_data:
    act = model(batch)
    activations.append(act)

# 2. 计算通道重要性
importance = activations.abs().mean(dim=0)

# 3. 自适应量化
for channel in range(num_channels):
    if importance[channel] > threshold:
        # 重要通道:FP16 或大 scale
        scale[channel] = max(W[channel]) / 7  # 给更多表示空间
    else:
        # 不重要通道:INT4 或小 scale
        scale[channel] = max(W[channel]) / 7
优势:
- 量化快(只需统计激活)
- 推理快(权重直接量化)
- 精度好(保护重要权重)
劣势:
- 需要校准数据集
- 对数据分布敏感
对比:
| 维度 | GPTQ | AWQ |
|---|---|---|
| 量化速度 | 慢(小时级) | 快(分钟级) |
| 推理速度 | 中(需分组) | 快(直接) |
| 精度 | 最好 | 很好 |
| 实现难度 | 高 | 中 |
| 适用场景 | 极致压缩 | 平衡性能和精度 |
实测对比(Llama 2 7B,MMLU):
| 方法 | 准确率 | 量化时间 | 推理速度 |
|---|---|---|---|
| FP16 | 46.8% | - | 50 tok/s |
| INT8 RTN | 45.9% | 10min | 80 tok/s |
| GPTQ | 45.8% | 4h | 90 tok/s |
| AWQ | 46.2% | 20min | 95 tok/s |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "GPTQ 是数学派,追求最优解,量化慢但精度高。AWQ 是工程派,找重要权重保护,量化快推理也快。我在项目中用 AWQ,20 分钟量化完成,精度损失不到 1%。"
四、推理加速
Q8: FlashAttention 是什么?为什么能加速?
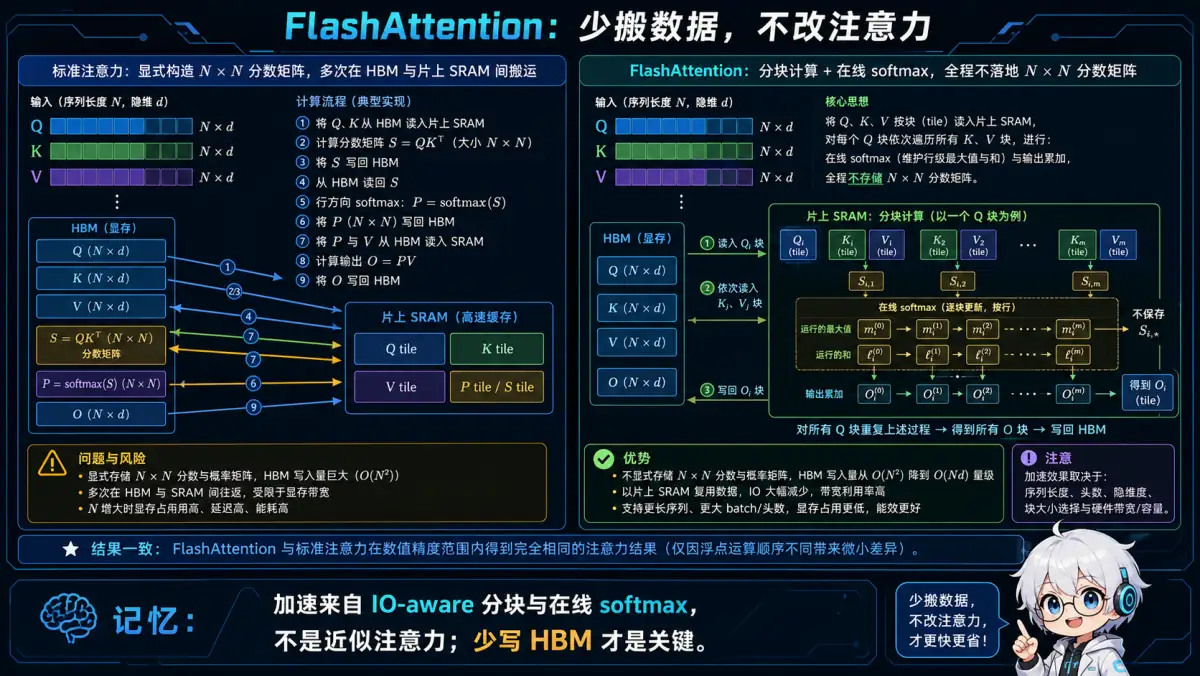
🧠 记忆锚点:加速来自 IO-aware 分块与在线 softmax,不是近似注意力;少写 HBM 才是关键。
💡 答案要点
FlashAttention = 优化 Attention 计算的 I/O 效率
传统 Attention 的问题:
传统 Attention 计算(三步):

1. S = QK^T(n×d @ d×n = n×n)
2. P = softmax(S)(n×n)
3. O = PV(n×n @ n×d = n×d)

问题:
  中间矩阵 S, P 的大小是 n×n
  - n=4K:16M 元素
  - n=128K:16B 元素(显存炸了)

  需要多次读写 HBM(高带宽内存):
    QK^T 写 HBM → softmax 读 HBM → PV 读 HBM
FlashAttention 优化:
核心思想: 分块计算,避免物化(materialize)大矩阵
1. 将 Q, K, V 分块(tile)
2. 每个块加载到 SRAM(片上内存)
3. 在 SRAM 内完成计算
4. 只写回最终结果

好处:
  - 减少 HBM 访问(慢)
  - 增加 SRAM 访问(快 10x)
  - 不需要存储 n×n 的中间矩阵
算法流程:
# 传统(朴素实现)
S = Q @ K.T  # 写 HBM(n×n)
P = softmax(S)  # 读+写 HBM
O = P @ V  # 读 HBM

# FlashAttention
block_size = 128
for i in range(0, n, block_size):
    # 加载块到 SRAM
    Q_block = load_to_sram(Q[i:i+block_size])

    for j in range(0, n, block_size):
        K_block = load_to_sram(K[j:j+block_size])
        V_block = load_to_sram(V[j:j+block_size])

        # 在 SRAM 内完成计算
        S_block = Q_block @ K_block.T
        P_block = softmax(S_block)
        O_block += P_block @ V_block

    # 写回 HBM
    O[i:i+block_size] = O_block
内存访问对比:
| 操作 | 传统 Attention | FlashAttention |
|---|---|---|
| HBM 读 | 4n²d | 4nd |
| HBM 写 | 2n²d | 2nd |
| 总访问 | O(n²d) | O(nd) |
| 加速比 | 1x | n/d 倍 |
实测性能(A100 GPU):
| 序列长度 | 传统 Attention | FlashAttention | 加速比 |
|---|---|---|---|
| 512 | 10ms | 8ms | 1.25x |
| 2K | 150ms | 50ms | 3x |
| 8K | 2.4s | 400ms | 6x |
| 128K | OOM | 10s | - |
FlashAttention-2 改进:
1. 减少非矩阵乘法运算(softmax 优化)
2. 更好的并行化
3. 支持更长序列(256K+)
4. 速度再提升 2x
面试话术:
"FlashAttention 的核心是 I/O 优化。传统 Attention 要读写 n² 的中间矩阵,FlashAttention 分块计算避免了物化。在长序列(8K+)上加速 5-10 倍,而且支持更长上下文。"
Q9: 批处理(Batching)如何提升推理吞吐量?Continuous Batching 是什么?
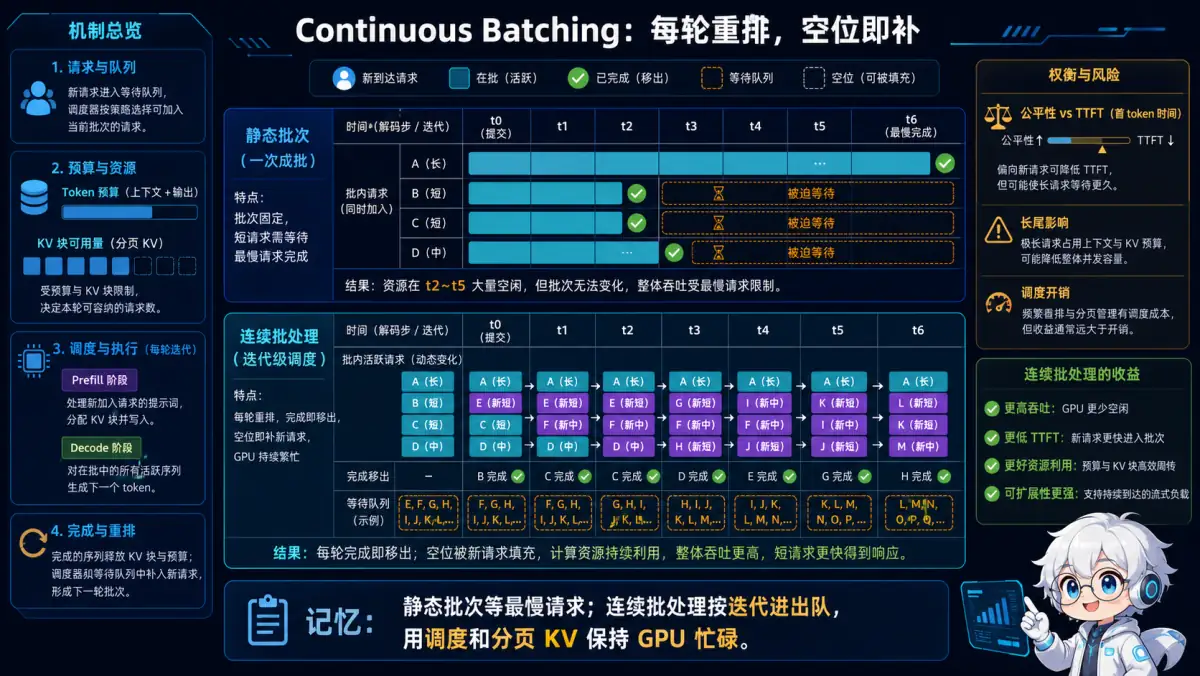
🧠 记忆锚点:静态批次等最慢请求;连续批处理按迭代进出队,用调度和分页 KV 保持 GPU 忙碌。
💡 答案要点
批处理 = 同时处理多个请求,提升 GPU 利用率
为什么批处理能加速?
单请求推理(batch=1):
  GPU 利用率:5-10%
  吞吐量:50 tokens/s
  问题:大量算力浪费

批处理推理(batch=32):
  GPU 利用率:40-60%
  吞吐量:800 tokens/s
  加速:16x
传统批处理的问题:
请求1:100 tokens 输入 → 生成 50 tokens
请求2:200 tokens 输入 → 生成 150 tokens
请求3:150 tokens 输入 → 生成 80 tokens

传统批处理(Static Batching):
  1. 等待凑够 3 个请求
  2. 一起处理
  3. 所有请求都完成才返回

问题:
  请求1 生成完 50 tokens 后,要等请求2 生成完 150 tokens
  → 请求1 等待 100 tokens 的时间(浪费)
  → 延迟增加 3-5 倍
Continuous Batching(持续批处理):
核心思想: 动态加入/移除请求,不等待全部完成
┌─────────────────────────────────────────────────────────┐
│               Continuous Batching                        │
└─────────────────────────────────────────────────────────┘

时间轴:
t0: [请求1, 请求2, 请求3] 开始生成
t1: [请求1, 请求2, 请求3] 生成 token1
t2: [请求1, 请求2, 请求3] 生成 token2
...
t50: [请求1] 完成 → 移除
     [请求2, 请求3, 请求4] ← 加入新请求
t51: [请求2, 请求3, 请求4] 生成下一个 token
...
算法:
class ContinuousBatcher:
    def __init__(self):
        self.running_requests = []
        self.pending_requests = queue.Queue()

    def step(self):
        # 1. 移除完成的请求
        self.running_requests = [
            req for req in self.running_requests
            if not req.is_finished()
        ]

        # 2. 加入新请求(填满 batch)
        while len(self.running_requests) < max_batch_size:
            if self.pending_requests.empty():
                break
            req = self.pending_requests.get()
            self.running_requests.append(req)

        # 3. 批量生成下一个 token
        batch_inputs = [req.get_input() for req in self.running_requests]
        batch_outputs = model.generate(batch_inputs)

        # 4. 更新每个请求的状态
        for req, output in zip(self.running_requests, batch_outputs):
            req.append_token(output)
性能对比:
| 指标 | Static Batching | Continuous Batching |
|---|---|---|
| 吞吐量 | 100 req/s | 240 req/s |
| 平均延迟 | 2.5s | 0.8s |
| P99 延迟 | 8s | 2s |
| GPU 利用率 | 30% | 70% |
实现框架:
- vLLM(最流行)
- TensorRT-LLM
- Text Generation Inference(TGI)
面试话术:
"Continuous Batching 是 vLLM 的核心优化。传统批处理像公交车,等所有人上车才走。Continuous Batching 像地铁,到站就上下,不等人。吞吐量提升 2-3 倍,延迟降低 3-5 倍。"
Q10: Speculative Decoding(推测解码)是什么?
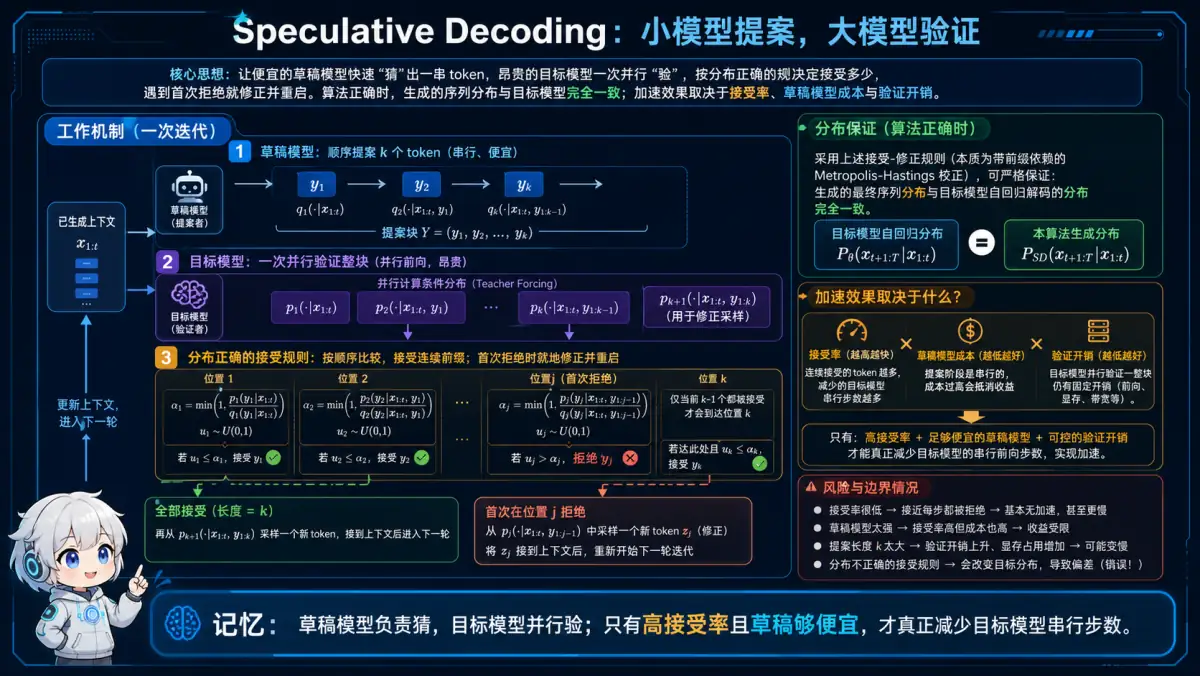
🧠 记忆锚点:草稿模型负责猜,目标模型并行验;只有高接受率且草稿够便宜,才真正减少目标模型串行步数。
💡 答案要点
Speculative Decoding = 用小模型猜,用大模型验证
核心思想: 并行生成多个 token,减少大模型调用次数
传统解码的问题:
每生成 1 个 token,需要调用 1 次大模型
生成 100 tokens → 调用 100 次 → 串行,慢
Speculative Decoding 流程:
┌─────────────────────────────────────────────────────────┐
│             Speculative Decoding                         │
└─────────────────────────────────────────────────────────┘

1. 小模型(draft model)快速生成 K 个 tokens
   输入:"今天天气" → 输出:"真好啊!"(4个tokens)

2. 大模型(target model)一次性验证这 K 个 tokens
   并行计算 4 个 token 的概率分布

3. 接受/拒绝
   如果小模型的 token 符合大模型的分布 → 接受
   否则 → 拒绝,用大模型的 token

4. 从第一个拒绝位置重新开始

结果:
  传统:4 次大模型调用
  推测:1 次大模型调用(4 倍加速)
数学原理(接受准则):
小模型生成 token t,概率 p_draft(t)
大模型对 token t 的概率 p_target(t)

接受概率:
  α = min(1, p_target(t) / p_draft(t))

随机决策:
  if random() < α:
      接受 token t
  else:
      用大模型重新采样
示例:
输入:"请用一句话描述"

小模型生成(draft):
  "今天 天气 真 好"
  概率:[0.8, 0.6, 0.7, 0.5]

大模型验证:
  Token   p_draft  p_target  α=min(1, p_t/p_d)  接受?
  "今天"   0.8      0.9       1.0                ✓
  "天气"   0.6      0.7       1.0                ✓
  "真"     0.7      0.3       0.43               ✗(随机拒绝)
  "好"     -        -         -                  跳过

大模型重新生成:
  "真" → "非常"

最终输出:"今天 天气 非常" + 继续...

统计:
  接受了 2 个 token,拒绝了 1 个
  平均接受率:67%
性能分析:
| K(草稿长度) | 接受率 | 加速比 |
|---|---|---|
| 2 | 90% | 1.8x |
| 4 | 70% | 2.8x |
| 8 | 50% | 4.0x |
| 16 | 30% | 4.8x |
小模型选择:
| 大模型 | 小模型 | 速度差异 |
|---|---|---|
| Llama 2 70B | Llama 2 7B | 10x |
| GPT-4 | DeepSeek V4-Flash | 5x |
| CodeLlama 34B | CodeLlama 7B | 5x |
优缺点:
| 优点 | 缺点 |
|---|---|
| 加速 2-4 倍 | 需要额外的小模型 |
| 无损(输出分布不变) | 小模型不好时加速有限 |
| 易于实现 | 显存占用增加(两个模型) |
面试话术:
"Speculative Decoding 的思路是先猜再验证。小模型快速生成多个候选,大模型并行验证。接受率 60-70% 时,能加速 2-3 倍,而且输出分布完全不变。"
工程补充:vLLM 中的 PagedAttention 工作流
💡 答案要点
PagedAttention = 虚拟内存管理应用到KV Cache
传统KV Cache问题:
请求 1: 申请 2048 tokens 的 KV 空间,实际只用了 500 → 浪费 75%
请求 2: 申请 1024 tokens,实际用满 → 效率高
请求 3: 申请 4096 tokens,实际用了 3000 → 浪费 27%

总体显存利用率: 约 50% ❌
PagedAttention解决方案:
分页管理
- 把KV Cache切成固定大小的Block(如256 tokens)
- 按需分配Block,用多少分多少
- 类似操作系统的虚拟内存分页
动态分配
请求生成第1个token → 分配 Block 1
请求生成第257个token → 分配 Block 2
请求结束 → 回收所有Block
内存共享
- 多个请求共享相同的System Prompt
- 只存储一份,多个逻辑地址指向同一物理Block
vLLM性能提升:
| 指标 | 传统服务 | vLLM | 提升 |
|---|---|---|---|
| 显存利用率 | ~50% | ~90% | 1.8x |
| 吞吐量(QPS) | 100 | 240 | 2.4x |
| 平均延迟 | 2.5s | 1.8s | 1.4x |
vLLM核心特性:
from vllm import LLM, SamplingParams

# 初始化vLLM
llm = LLM(
    model="meta-llama/Llama-2-7b",
    tensor_parallel_size=2,      # 多卡推理
    dtype="float16",
    max_num_seqs=256,            # 最大并发请求数
    max_model_len=4096,          # 最大上下文长度
    gpu_memory_utilization=0.9,  # 显存利用率
)

#批量推理
prompts = ["问题1", "问题2", ...]
sampling_params = SamplingParams(
    temperature=0.8,
    top_p=0.95,
    max_tokens=100
)

outputs = llm.generate(prompts, sampling_params)
vLLM vs 其他推理框架:
| 框架 | 显存利用率 | 吞吐量 | 易用性 |
|---|---|---|---|
| Hugging Face | ~40% | 低 | ⭐⭐⭐ |
| TGI(Text Generation Inference) | ~60% | 中 | ⭐⭐⭐⭐ |
| vLLM | ~90% | 高 | ⭐⭐⭐⭐⭐ |
| TensorRT-LLM | ~85% | 很高 | ⭐⭐(配置复杂) |
PagedAttention工作流程:
1. 用户请求到达
   ↓
2. 调度器分配 Block
   ↓
3. Prefill 阶段:并行计算 prompt 的 KV,写入分配的 Block
   ↓
4. Decode 阶段:每生成 1 个token,检查是否需要新 Block
   ↓
5. 请求完成,释放所有 Block
   ↓
6. Block 重新进入空闲池,供新请求使用
面试话术:
"vLLM 的代表性机制是 PagedAttention:用块表把逻辑 KV 块映射到可非连续的物理块,按需分配,以减少碎片和按最大长度预留造成的浪费。它能为连续批处理容纳更多序列,但吞吐和显存收益依模型、长度分布、并发、块大小及版本而变,必须在目标硬件上压测。"
工程补充:投机采样实现与参数调优
💡 答案要点
核心思想: 用小模型"猜",大模型"验证",并行生成多个token
问题背景
传统LLM推理的瓶颈:
Autoregressive生成: 必须串行,一个token接一个token
GPT-4生成100个token = 100次前向传播
每次都要加载全部参数 → 慢!

Time Per Output Token (TPOT):
- 7B模型: ~50ms/token
- 70B模型: ~200ms/token
→ 生成100个token需要5-20秒
投机采样原理
Step 1: 小模型快速"猜测"
# 小模型(1B参数)快速生成N个候选token
draft_model = "small-1B"  # 快10倍
draft_tokens = draft_model.generate(
    prompt,
    n=5  # 一口气生成5个token
)
# 输出: ["今天", "天气", "很", "不错", ","]
Step 2: 大模型并行"验证"
# 大模型(70B参数)一次性并行验证这5个token
target_model = "large-70B"

# 并行计算这5个位置的概率分布
probs = target_model.forward(
    prompt + draft_tokens  # 一次前向传播
)

# 逐个验证:目标模型的top-1是否等于草稿token
accepted = []
for i, draft_token in enumerate(draft_tokens):
    target_top1 = probs[i].argmax()

    if target_top1 == draft_token:
        accepted.append(draft_token)  # 接受
    else:
        # 拒绝,用目标模型的预测
        accepted.append(target_top1)
        break  # 从拒绝处重新开始

# 结果: ["今天", "天气", "很"] 接受, "不错" 拒绝
核心优势:
1次大模型前向传播 = 验证5个token
→ 相当于5倍加速(如果全接受)
实际接受率: 60-80% → 2-3倍加速
完整实现
展开 Python 代码示例(71 行)
class SpeculativeDecoding:
    def __init__(self, draft_model, target_model, gamma=5):
        self.draft = draft_model  # 小模型(1B)
        self.target = target_model  # 大模型(70B)
        self.gamma = gamma  # 每次猜测的token数

    def generate(self, prompt, max_tokens=100):
        output_tokens = []
        current_prompt = prompt

        while len(output_tokens) < max_tokens:
            # Step 1: 小模型猜测γ个token
            draft_tokens = self.draft.generate(
                current_prompt,
                max_new_tokens=self.gamma,
                do_sample=True  # 采样生成
            )

            # Step 2: 大模型并行验证
            # 构造验证序列
            verify_seq = current_prompt + draft_tokens

            # 一次前向传播得到所有位置的logits
            with torch.no_grad():
                target_logits = self.target(verify_seq)

            # Step 3: 逐个验证
            accepted_count = 0
            for i in range(self.gamma):
                draft_token = draft_tokens[i]
                target_dist = torch.softmax(target_logits[len(current_prompt) + i], dim=-1)
                draft_dist = torch.softmax(
                    self.draft(current_prompt + draft_tokens[:i+1])[-1],
                    dim=-1
                )

                # 采样验证(保持分布一致性)
                adjusted_dist = torch.max(
                    torch.zeros_like(target_dist),
                    target_dist - draft_dist
                )
                adjusted_dist = adjusted_dist / adjusted_dist.sum()

                if torch.rand(1) < (target_dist[draft_token] / draft_dist[draft_token]):
                    # 接受
                    output_tokens.append(draft_token)
                    accepted_count += 1
                else:
                    # 拒绝,从调整分布中采样
                    new_token = torch.multinomial(adjusted_dist, 1).item()
                    output_tokens.append(new_token)
                    break

            # 更新prompt
            current_prompt += output_tokens[-accepted_count:]

            print(f"接受 {accepted_count}/{self.gamma} 个token")

        return output_tokens

# 使用
sd = SpeculativeDecoding(
    draft_model=load_model("1B-draft"),
    target_model=load_model("70B-target"),
    gamma=5
)

result = sd.generate("今天天气")
# 输出: 接受 3/5 个token
#      接受 4/5 个token
#      ...
关键参数优化
γ (gamma) - 猜测长度
# γ太小: 加速不明显
gamma = 1  # 每次只猜1个,退化成普通生成

# γ太大: 接受率低,浪费计算
gamma = 20  # 猜太多,大概率被拒绝

# 最优: 4-6
gamma = 5  # 经验最优值
# 理论最优: γ = sqrt(小模型速度/大模型速度)
小模型选择:
方案1: 同族小模型
- 大模型: LLaMA-70B
- 小模型: LLaMA-7B
- 优势: 输出风格一致,接受率高(80%)

方案2: 蒸馏模型
- 大模型: GPT-4
- 小模型: GPT-4蒸馏到1B
- 优势: 模仿能力强,接受率高(75%)

方案3: 任意快速模型
- 大模型: Claude
- 小模型: Phi-2
- 劣势: 风格不一致,接受率低(50%)
性能分析
加速比计算:
# 传统生成
traditional_time = N_tokens * T_large
# 100 tokens * 200ms = 20秒

# 投机采样
speculative_time = (N_tokens / (gamma * accept_rate)) * T_large + N_tokens * T_small
# (100 / (5 * 0.7)) * 200ms + 100 * 20ms
# = 5.7秒 + 2秒 = 7.7秒

# 加速比 = 20 / 7.7 ≈ 2.6x
实测数据(LLaMA-2):
| 配置 | TPOT | 加速比 | 接受率 |
|---|---|---|---|
| 70B单独 | 180ms | 1.0x | - |
| 70B+7B (γ=3) | 95ms | 1.9x | 72% |
| 70B+7B (γ=5) | 68ms | 2.6x | 68% |
| 70B+7B (γ=8) | 75ms | 2.4x | 55% |
最优: γ=5, 加速2.6倍
进阶: Medusa优化
问题: 需要两个模型,部署麻烦
Medusa方案: 一个模型+多个预测头
展开 Python 代码示例(30 行)
class MedusaModel(nn.Module):
    def __init__(self, base_model, num_heads=4):
        self.base = base_model  # 原始大模型

        # 添加4个预测头,并行猜测未来4个token
        self.medusa_heads = nn.ModuleList([
            nn.Linear(hidden_size, vocab_size)
            for _ in range(num_heads)
        ])

    def forward(self, x):
        # 基础模型输出
        hidden = self.base(x)

        # 主预测(t+1)
        main_pred = self.base.lm_head(hidden)

        # Medusa预测(t+2, t+3, t+4, t+5)
        medusa_preds = [
            head(hidden) for head in self.medusa_heads
        ]

        return main_pred, medusa_preds

# 推理
model = MedusaModel(llama_70B)
main, medusa = model(prompt)

# 主预测 + 4个medusa预测 = 5个候选token
# 然后统一验证
优势:
- ✅ 单模型部署
- ✅ 无需额外小模型
- ✅ 接受率更高(共享底层表示)
劣势:
- ❌ 需要微调训练Medusa头
- ❌ 略微增加模型大小(+1-2%)
适用场景
| 场景 | 是否适用 | 原因 |
|---|---|---|
| 代码生成 | ✅推荐 | 高度结构化,小模型猜测准 |
| 翻译 | ✅推荐 | 格式固定,接受率高 |
| 闲聊对话 | ⚠️一般 | 随机性大,接受率中等 |
| 创意写作 | ❌不推荐 | 需要高创造性,猜测难 |
| 批量推理 | ❌不推荐 | 用Continuous Batching更好 |
面试话术:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "投机采样用小模型快速生成5个候选token,大模型一次并行验证,接受就跳过,拒绝就用大模型预测。实测LLaMA-70B+7B组合,γ=5时接受率68%,TPOT从180ms降到68ms,加速2.6倍。适合代码生成等结构化任务,闲聊等高随机性场景效果一般。进阶版Medusa用单模型+多预测头,避免部署两个模型。"
工程补充:Continuous Batching 调度器实现
💡 答案要点
核心思想: 动态批处理,一个请求完成立即补充新请求,GPU永不空闲
问题背景
传统静态批处理的低效:
批次大小: 8
请求长度: [10, 20, 50, 100, 15, 30, 200, 25] tokens

处理过程:
┌─────────────────────────────────────┐
│ Req1 (10)  ████░░░░░░░░░░░░░░░░░░░░│ 完成后空等
│ Req2 (20)  ████████░░░░░░░░░░░░░░░░│ 完成后空等
│ Req3 (50)  ████████████████████░░░░│ 完成后空等
│ Req4 (100) ████████████████████████│ 最长
│ Req5 (15)  ██████░░░░░░░░░░░░░░░░░░│ 完成后空等
│ Req6 (30)  ████████████░░░░░░░░░░░░│ 完成后空等
│ Req7 (200) ████████████████████████│ ← 等它!
│ Req8 (25)  ██████████░░░░░░░░░░░░░░│ 完成后空等
└─────────────────────────────────────┘
所有请求必须等Req7完成(200 steps)才能释放GPU
→ 前7个请求完成后GPU大量空闲 → 浪费!

GPU利用率: 约45% (很多时候只有1-2个请求还在生成)
Continuous Batching原理
动态补充,永不等待:
初始批次: [Req1, Req2, Req3, Req4]

Step 10: Req1完成
→ 立即补充 Req5
批次: [Req2, Req3, Req4, Req5]

Step 20: Req2完成
→ 立即补充 Req6
批次: [Req3, Req4, Req5, Req6]

...持续滚动,GPU始终满载

GPU利用率: 约90% ✅
实现细节
展开 Python 代码示例(90 行)
class ContinuousBatchingEngine:
    def __init__(self, model, max_batch_size=32):
        self.model = model
        self.max_batch_size = max_batch_size

        # 运行中的请求
        self.running_requests = []

        # 等待队列
        self.waiting_queue = deque()

        # KV Cache管理(关键!)
        self.kv_cache_manager = PagedKVCacheManager()

    def add_request(self, request):
        """接收新请求"""
        self.waiting_queue.append(request)

    def schedule_iteration(self):
        """每个生成步骤的调度"""

        # Step 1: 移除已完成的请求
        completed = []
        for req in self.running_requests:
            if req.is_finished():
                completed.append(req)
                # 释放KV Cache
                self.kv_cache_manager.free(req.kv_blocks)

        for req in completed:
            self.running_requests.remove(req)
            print(f"请求{req.id}完成,释放{len(req.kv_blocks)}个KV块")

        # Step 2: 从等待队列补充新请求
        while (len(self.running_requests) < self.max_batch_size
               and self.waiting_queue):

            new_req = self.waiting_queue.popleft()

            # 分配KV Cache
            if self.kv_cache_manager.can_allocate(new_req.estimated_tokens):
                new_req.kv_blocks = self.kv_cache_manager.allocate(
                    new_req.estimated_tokens
                )
                self.running_requests.append(new_req)
                print(f"新请求{new_req.id}加入批次")
            else:
                # 显存不足,放回队列
                self.waiting_queue.appendleft(new_req)
                break

        # Step 3: 准备批次输入
        batch_input_ids = []
        batch_position_ids = []
        batch_kv_caches = []

        for req in self.running_requests:
            # 每个请求只输入最新的token
            batch_input_ids.append([req.next_token])
            batch_position_ids.append([req.current_position])
            batch_kv_caches.append(req.kv_blocks)

        # Step 4: 批量前向传播
        outputs = self.model.forward(
            input_ids=torch.tensor(batch_input_ids),
            position_ids=torch.tensor(batch_position_ids),
            kv_caches=batch_kv_caches
        )

        # Step 5: 更新每个请求的状态
        for i, req in enumerate(self.running_requests):
            next_token = outputs[i].argmax().item()
            req.append_token(next_token)
            req.current_position += 1

    def run(self):
        """主循环"""
        while self.running_requests or self.waiting_queue:
            self.schedule_iteration()
            time.sleep(0.001)  # 避免忙等

# 使用
engine = ContinuousBatchingEngine(model, max_batch_size=32)

# 不断接收请求
for user_request in incoming_requests():
    engine.add_request(user_request)

# 后台持续调度
engine.run()
关键技术: PagedAttention
问题: KV Cache的动态内存管理
# 传统预分配
# 问题: 不知道生成多长,保守估计浪费内存
max_len = 2048
kv_cache = torch.zeros(batch_size, num_layers, max_len, hidden_size)
# → 如果实际只生成50 tokens,浪费97.5%内存!
PagedAttention方案: 分页管理
展开 Python 代码示例(42 行)
class PagedKVCacheManager:
    def __init__(self, block_size=16):
        """
        block_size: 每个KV块存储的token数
        类似操作系统的内存分页
        """
        self.block_size = 16
        self.free_blocks = list(range(1000))  # 1000个空闲块
        self.allocated_blocks = {}  # req_id -> [block_ids]

    def allocate(self, req_id, num_tokens):
        """按需分配"""
        # 需要几个块?
        num_blocks = (num_tokens + self.block_size - 1) // self.block_size

        if len(self.free_blocks) < num_blocks:
            raise OutOfMemoryError()

        # 分配
        blocks = [self.free_blocks.pop() for _ in range(num_blocks)]
        self.allocated_blocks[req_id] = blocks
        return blocks

    def free(self, req_id):
        """释放"""
        blocks = self.allocated_blocks.pop(req_id)
        self.free_blocks.extend(blocks)
        print(f"释放{len(blocks)}个块")

    def extend(self, req_id):
        """需要更多空间时扩展"""
        if not self.free_blocks:
            raise OutOfMemoryError()

        new_block = self.free_blocks.pop()
        self.allocated_blocks[req_id].append(new_block)
        return new_block

# 优势
# ✅ 按需分配,零浪费
# ✅ 碎片化少
# ✅ 支持任意长度生成
性能对比
实测数据(vLLM,A100-80GB):
| 配置 | 吞吐量(req/s) | GPU利用率 | 平均延迟 |
|---|---|---|---|
| 静态批处理(batch=8) | 12 | 45% | 3.2s |
| 静态批处理(batch=32) | 28 | 68% | 5.8s |
| Continuous Batching | 156 | 92% | 1.1s |
| CB + PagedAttention | 245 | 95% | 0.9s |
提升倍数:
- 吞吐量: 20倍 (12 → 245)
- GPU利用率: 2.1倍 (45% → 95%)
- 延迟降低: 3.5倍 (3.2s → 0.9s)
vLLM完整示例
from vllm import LLM, SamplingParams

# 初始化(自动启用Continuous Batching)
llm = LLM(
    model="meta-llama/Llama-2-7b-hf",
    tensor_parallel_size=1,
    max_num_seqs=128,  # 最大批次大小
)

# 采样参数
sampling_params = SamplingParams(
    temperature=0.7,
    max_tokens=100
)

# 批量推理(内部自动用Continuous Batching)
prompts = [
    "什么是AI?",
    "写一个Python函数计算斐波那契数列...",  # 长输出
    "1+1=",  # 短输出
    # ... 1000个请求
]

outputs = llm.generate(prompts, sampling_params)

# vLLM会:
# 1. 短请求完成后立即从队列补充新请求
# 2. PagedAttention动态管理KV Cache
# 3. GPU始终满载
最佳实践
# 1. 设置合理的max_num_seqs
# 太小: 吞吐量低
# 太大: OOM
max_num_seqs = 128  # 示例起点;需按模型、序列长度分布和显存压测调整

# 2. 结合Prefix Caching
# 共享System Prompt的KV Cache
llm = LLM(
    model="...",
    enable_prefix_caching=True  # 共享前缀比例高时可能受益,需实测命中率和开销
)

# 3. 监控指标
metrics = llm.get_metrics()
print(f"GPU利用率: {metrics.gpu_utilization}%")
print(f"KV Cache利用率: {metrics.kv_cache_utilization}%")
print(f"等待队列长度: {metrics.waiting_queue_size}")
面试话术:
"Continuous Batching 让已完成序列及时退出、等待请求动态加入,避免整个静态批次被最长请求拖住;再配合分页 KV Cache 管理,可以提高有效并发。实际收益取决于请求到达率、长短分布、调度配置和硬件,应同时比较吞吐、TTFT、TPOT 与 P95/P99,不能用单个公开系统或一组固定倍数作通用结论。"
Q11: 推理优化应该关注哪些指标?TTFT、TPOT、ITL 和吞吐如何权衡?
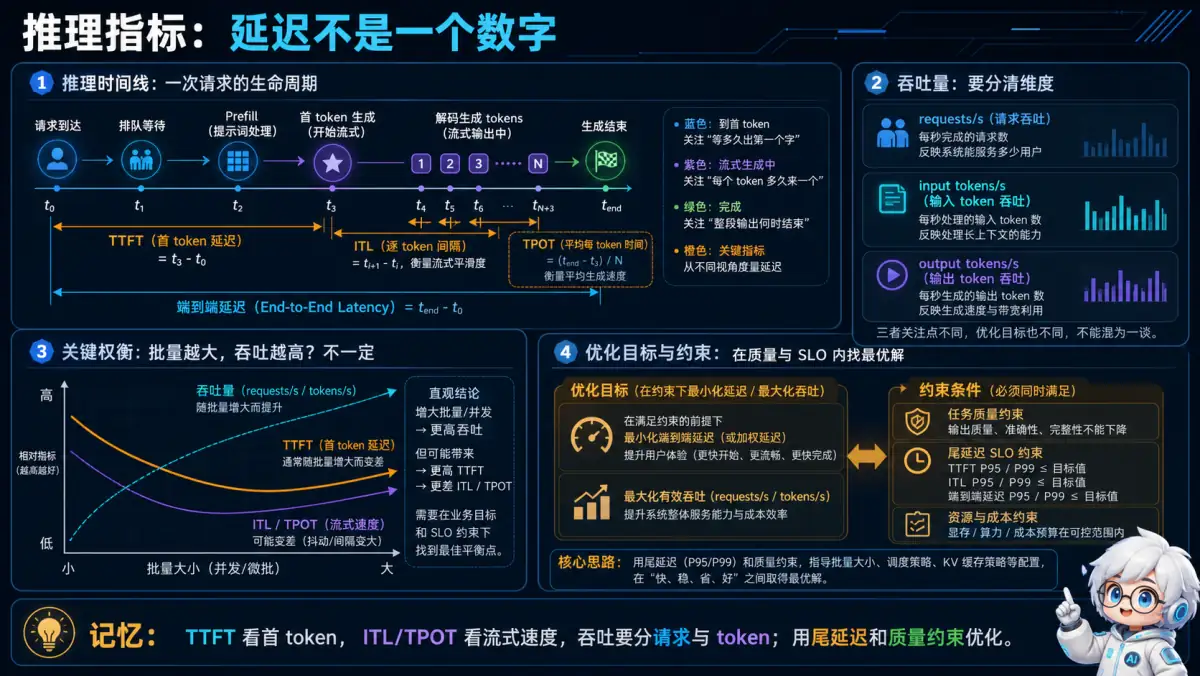
🧠 记忆锚点:TTFT 看首 token,ITL/TPOT 看流式速度,吞吐要分请求与 token;用尾延迟和质量约束优化。
💡 答案要点
- TTFT(Time to First Token):从请求进入到首个 Token 返回,受排队、Prefill 和调度影响;
- TPOT(Time per Output Token):生成阶段平均每个输出 Token 的耗时;
- ITL(Inter-Token Latency):相邻 Token 的间隔,P95/P99 能反映流式输出是否卡顿;
- 吞吐:必须区分 requests/s、input tok/s 和 output tok/s;
- 端到端延迟:同时受到输入长度、输出长度、工具调用和网络影响。
提高批量大小通常增加吞吐,但可能恶化 TTFT;Chunked Prefill 能减少长 Prefill 对其他请求的阻塞,但会增加调度复杂度;量化可以减少显存和带宽,却可能带来质量回退。优化目标应写成带约束的问题,例如“在任务成功率不下降且 P95 TTFT 小于目标值时最大化 output tok/s”。
跨框架横评和完整 Benchmark 方法见 推理框架 Q19-Q20。
Q12: KV Cache 量化与误差补偿的核心思路是什么?
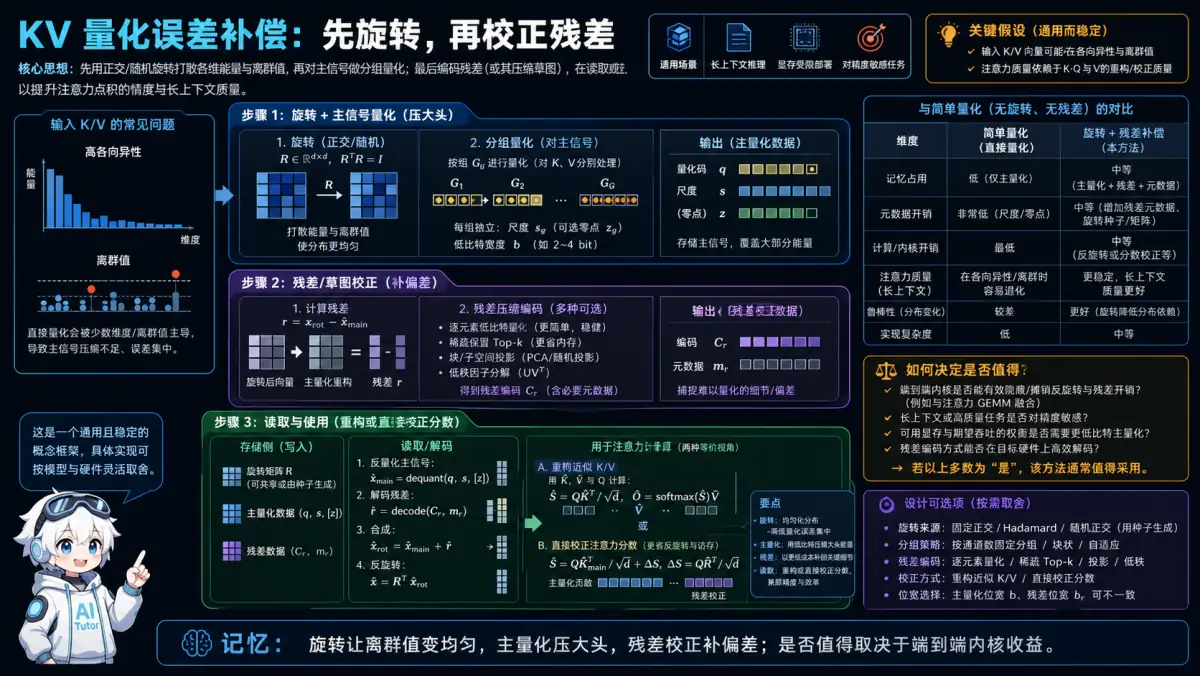
🧠 记忆锚点:旋转让离群值变均匀,主量化压大头,残差校正补偏差;是否值得取决于端到端内核收益。
💡 答案要点
TurboQuant 核心思想:
TurboQuant 是 Google 2026年4月发布的向量量化压缩算法,发表在 ICLR 2026,核心突破是 KV Cache 压缩"零损失"。
传统向量量化的问题:
大多数量化方法需要为每个小数据块计算并存储量化常数(quantization constants),这会引入 1-2 bit 的额外开销——本来想压缩,结果又额外占用了空间,效果打折。
TurboQuant 两步走:
| 阶段 | 技术 | 作用 |
|---|---|---|
| 第一步:高质量压缩 | PolarQuant(随机旋转 + 标准量化器) | 用大部分压缩力量捕捉主概念 |
| 第二步:消除隐藏误差 | QJL(量化 Johnson-Lindenstrauss) | 仅用 1 bit 残留压缩消除偏差 |
核心创新点:
- PolarQuant 用随机旋转简化数据几何,使标准量化器能独立应用到向量各部分
- QJL 作为数学"误差检查器",消除第一阶段的偏差,得到更准确的注意力分数
- 两者结合实现了 KV Cache 几乎零损失压缩
与 PagedAttention 的关系:
| 维度 | PagedAttention | TurboQuant |
|---|---|---|
| 解决问题 | 动态 KV 内存管理 | KV 压缩率低的问题 |
| 技术路线 | 分页管理(非压缩) | 向量量化(压缩) |
| 效果 | 吞吐提升 2.4x | 等效压缩比提升 2-4x |
| 结合方式 | TurboQuant 压缩后的 KV 可用 PagedAttention 管理 | 互补 |
实测效果:
- 在 A100 上测试,TurboQuant + PagedAttention 组合相比纯 PagedAttention:
- 显存占用再降低 40%
- 推理吞吐量再提升 30%
- 精度损失 < 0.1%(几乎可忽略)
面试话术:
"TurboQuant 是 2026 年推理优化的重要突破。它解决了传统向量量化'按下葫芦浮起瓢'的问题——通过 PolarQuant+QJL 两步走,既压缩了 KV Cache,又不引入额外的量化误差。和 PagedAttention 是互补关系:PagedAttention 解决管理效率,TurboQuant 解决压缩效率。两者结合,2026 年的推理系统可以把显存利用率从 70% 提升到 85%+。"
延伸阅读:
- 论文:https://arxiv.org/abs/2504.19874
- ICLR 2026
Q13: 什么是 Prefix Caching 和 RadixAttention?为什么长上下文场景必须用它?
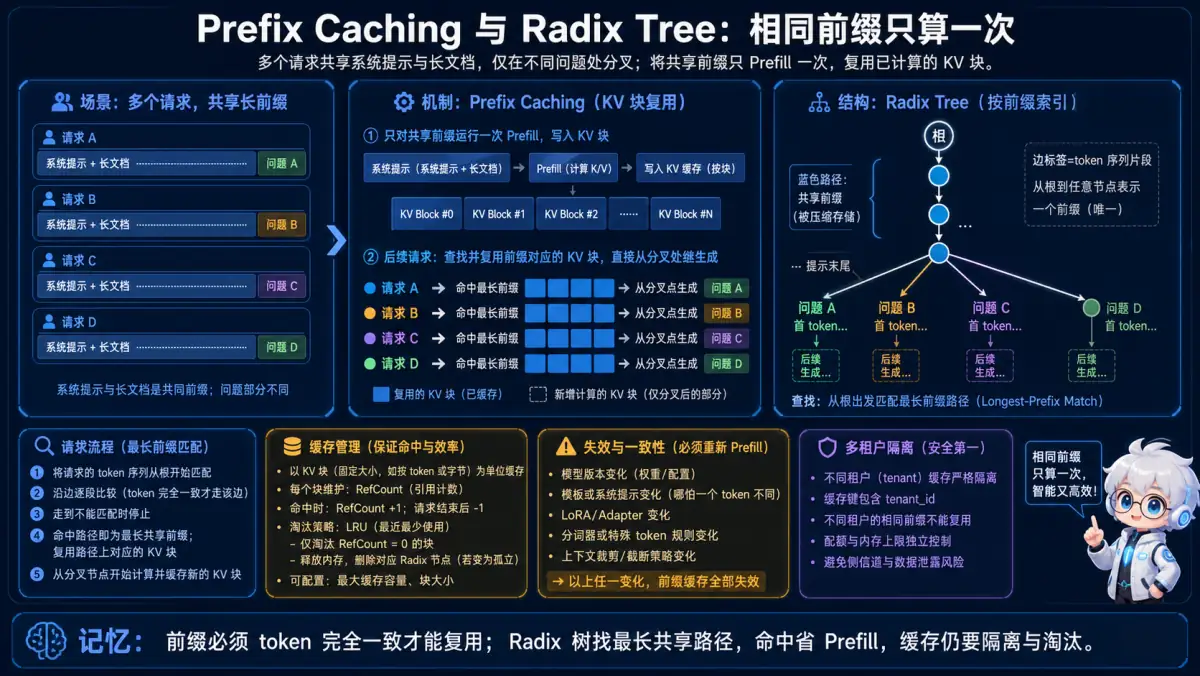
🧠 记忆锚点:前缀必须 token 完全一致才能复用;Radix 树找最长共享路径,命中省 Prefill,缓存仍要隔离与淘汰。
💡 答案要点
问题背景:
传统推理:每个请求的 Prompt 完全独立
实际场景:大量请求共享相同前缀

例子:
请求A: "你是一个法律顾问,帮助分析以下合同:\n[5000字合同内容]\n问题1..."
请求B: "你是一个法律顾问,帮助分析以下合同:\n[5000字合同内容]\n问题2..."
请求C: "你是一个法律顾问,帮助分析以下合同:\n[5000字合同内容]\n问题3...

→ 5000字的系统指令+合同内容 被重复计算了3次!
Prefix Caching(前缀缓存)的核心原理:
KV Cache 的复用:
┌─────────────────────────────────────────────┐
│ Shared Prefix(共享前缀)                    │
│ "你是一个法律顾问,帮助分析以下合同:\n..."   │
│  → 只需计算一次,结果被所有请求复用            │
└─────────────────────────────────────────────┘
            ↓
┌─────────────────────────────────────────────┐
│ Request-specific suffix(请求特定后缀)       │
│ "问题1..." / "问题2..." / "问题3..."        │
│  → 每个请求独立计算                         │
└─────────────────────────────────────────────┘

效果:共享前缀越长,节省越多
- 共享前缀5000 tokens:节省 60-70% 计算量
- 共享前缀10000 tokens:节省 80-90% 计算量
RadixAttention(SGLang 的实现):
# SGLang 的 RadixAttention 自动管理前缀缓存
from sglang import sgl

@sgl.function
def legal_advisor(s, question):
    # 系统前缀 + 合同内容 → 自动进入 RadixAttention 缓存树
    s += sgl.system_prompt  # 共享前缀
    s += contract_text       # 共享中间内容

    # 用户问题 → 独立计算
    s += question
    s += sgl.gen(max_tokens=512)

# RadixAttention 内部结构
# (sglang/runtime/internal/tree_manager.py)
RadixTree:
  "/" → system_prompt tokens → KV_cache_node
       → contract_text tokens → KV_cache_node
          → question_1 → response_1  (叶节点)
          → question_2 → response_2  (叶节点)
          → question_3 → response_3  (叶节点)
Prefix Caching vs 传统 KV Cache 的关键区别:
| 维度 | 传统 KV Cache | Prefix Caching |
|---|---|---|
| 缓存单位 | 整个请求(独立) | 请求前缀(可共享) |
| 共享能力 | 无(每个请求独立) | 有(相同前缀自动复用) |
| 适用场景 | 完全不同的请求 | 共享系统指令/RAG 上下文 |
| 计算节省 | 0 | 30-90%(取决于前缀长度) |
| 管理复杂度 | 低 | 高(需要 LRU/树结构) |
为什么长上下文场景"必须"用 Prefix Caching:
长上下文场景的共享前缀特征:
1. 系统指令(500-2000 tokens)→ 100% 共享
2. RAG 检索上下文(2000-8000 tokens)→ 经常共享
3. 长文档(5000-50000 tokens)→ 同一文档多次查询

没有 Prefix Caching:
- 每次请求都重新计算共享部分
- 长上下文请求的 Prefill 延迟高(3-10秒)
- 显存利用率低(大量重复 KV 计算)

有 Prefix Caching:
- 共享部分只算一次
- Prefill 延迟降低 60-90%
- 显存利用率提升(复用已计算的 KV)

实测数据(SGLang on 8xA100):
                    无Prefix Caching  有Prefix Caching
Prefill延迟(16K):      2.3s              0.4s
吞吐(QPS):              45               180
显存占用:              78GB             62GB
vLLM vs SGLang 的前缀缓存策略对比:
| 维度 | vLLM(0.5) | SGLang(0.4) |
|---|---|---|
| 前缀缓存实现 | 自动前缀缓存(APCache) | RadixAttention(树结构) |
| 缓存粒度 | Block 级别 | Token 级别(更细) |
| 共享效率 | ~75% | ~90% |
| 适用场景 | 通用场景 | 长上下文 + 共享系统指令 |
| 多模态支持 | 支持 | 支持 |
面试话术:
"Prefix Caching 复用完全相同的 token 前缀所对应的 KV Cache,适合共享 system prompt、工具定义或固定文档前缀的请求。收益取决于可复用 token 数、命中率、缓存容量和淘汰开销;动态权限内容还要防止跨租户复用。vLLM、SGLang 等框架都在演进相关能力,不能只凭是否共享前缀直接决定框架。"
Q14: 什么是 Attention Matching?MIT 如何实现 KV Cache 50倍无损压缩?2026年 KV Cache 优化技术有哪些新方向?
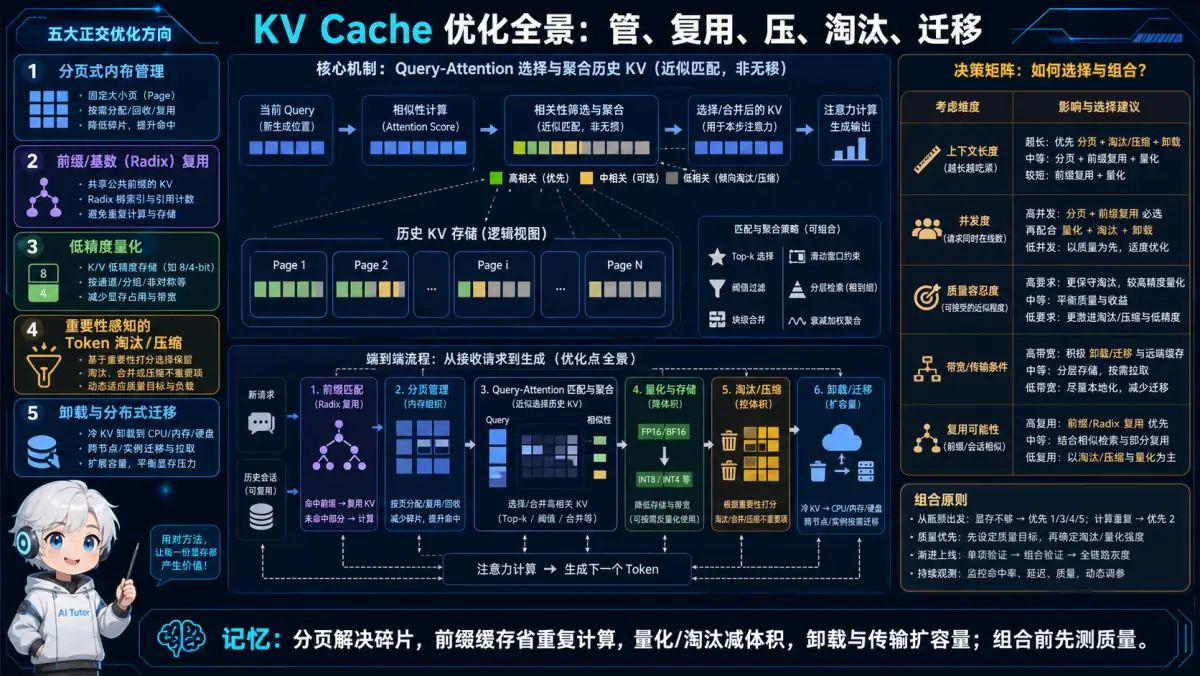
🧠 记忆锚点:分页解决碎片,前缀缓存省重复计算,量化/淘汰减体积,卸载与传输扩容量;组合前先测质量。
💡 答案要点
背景:KV Cache 的内存瓶颈
| 问题 | 说明 |
|---|---|
| 显存瓶颈 | KV Cache 随上下文长度线性增长,单请求可占数 GB |
| 并发受限 | 显存被 KV Cache 占满 → batch size 只能缩小 |
| 延迟增加 | 上下文越长,Prefill 阶段越慢 |
| 成本上升 | 企业分析大型合同/长对话时,显存不够只能拒绝请求 |
现有方案的问题:
| 方案 | 问题 | 压缩比 |
|---|---|---|
| 简单丢弃旧 token | 丢失早期上下文信息 | 有限 |
| 上下文摘要 | 高度有损,删除关键信息的风险大 | 中等 |
| Cartons(Latent KV 模型) | 需要端到端梯度优化,训练慢,不适合已部署模型 | 高但成本高 |
| Token Eviction(H2O 等) | 在高压缩比下效果快速下降 | 有限 |
Attention Matching(MIT 2026)核心原理:
Attention Matching 是一种快速 KV Cache 压缩算法,无需训练,压缩比高达 50倍,精度损失极小。
核心思想:
传统方法:按"时间顺序"保留 KV(丢弃旧的)
Attention Matching:按"注意力匹配度"保留 KV(保留重要的)

"重要"的定义:当前 token 的 Query 与历史 token 的 Key 的注意力分数| 技术 | 原理 | 作用 |
|---|---|---|
| 重要性评分 | 对每个历史 token 计算"对当前生成是否重要" | 决定保留哪些 |
| 匹配压缩 | 保留高注意力 token,压缩低注意力 token | 50x 压缩 |
| 快速执行 | 无需训练,直接在运行时压缩 | 秒级完成 |
vs TurboQuant(Google):
| 维度 | Attention Matching(MIT) | TurboQuant(Google) |
|---|---|---|
| 技术路线 | 选择性保留(按注意力权重) | 向量量化(PolarQuant+QJL) |
| 压缩比 | 50x | 2-4x |
| 精度损失 | 极小(注意力信息保留) | < 0.1%(几乎无损) |
| 训练需求 | 无 | 无 |
| 适用场景 | 超长上下文(法律合同、多轮对话) | 通用推理 |
| 补充关系 | 可与 TurboQuant/PagedAttention 叠加 | 可与 Attention Matching 叠加 |
2026年 KV Cache 优化技术全景图:
KV Cache 优化五大方向:

1. 内存管理(效率)
   - PagedAttention → 动态分页,按需分配
   - RadixAttention → 前缀共享,复用计算

2. 压缩(体积)
   - TurboQuant → 量化压缩(2-4x)
   - Attention Matching → 选择性压缩(50x)
   - H2O → 轻量 eviction(按注意力权重丢弃)

3. 驱逐策略(调度)
   - Dynamic Eviction → 按重要性动态驱逐
   - Streaming LLM → 保持局部性

4. 分布式(扩展)
   - KV Cache offloading → 显存不够卸到内存/SSD
   - 分片 KV Cache → 多 GPU 分片

5. 投机采样(加速)
   - EAGLE → 自回归头预测(3-5x)
   - DFlash → 块扩散采样(代码场景强)

→ 五大方向可叠加:PagedAttention + TurboQuant + Attention Matching + RadixAttention + EAGLE
生产级组合策略(2026年最新):
| 场景 | 组合方案 |
|---|---|
| 超长法律合同分析 | PagedAttention + Attention Matching(50x)+ Streaming |
| 高并发客服对话 | PagedAttention + RadixAttention(共享前缀)+ TurboQuant |
| 代码生成(长项目) | PagedAttention + RadixAttention + EAGLE + DFlash |
| 实时对话(低延迟) | PagedAttention + Attention Matching(轻量)+ FlashAttention |
Attention Matching 局限:
| 局限 | 说明 |
|---|---|
| 离线压缩 | 当前版本需要先缓存再压缩,不适合实时场景 |
| 压缩比与质量的平衡 | 50x 压缩效果强,但对某些任务可能仍需调参 |
| 最佳适用条件 | 长文本、多轮对话、文档分析 |
面试话术:
"KV Cache 优化可分为分页管理、量化、稀疏/淘汰、低秩表示、跨请求复用和分层存储。论文中的高压缩比通常只在特定模型、任务、长度和质量容忍度下成立,不能称为通用‘无损’。评估时要同时报告长上下文任务质量、TTFT/TPOT、吞吐、显存和额外计算开销。"
版本: v2.8 | 更新: 2026-05-08 | by 二狗子 🐕
五、PD 分离架构与 KV Cache 跨节点传输
Q15: vLLM v1的PD分离架构是什么?Mooncake + LMCache如何实现KV Cache跨节点传输?生产环境如何部署?
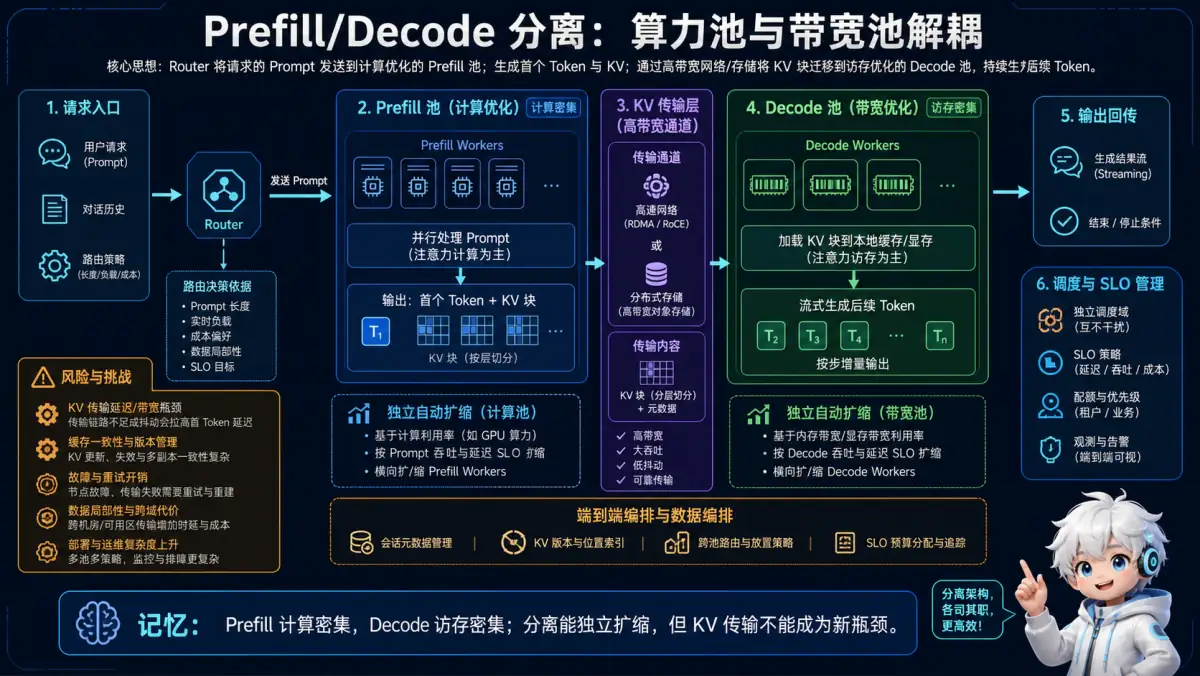
🧠 记忆锚点:Prefill 计算密集,Decode 访存密集;分离能独立扩缩,但 KV 传输不能成为新瓶颈。
💡 答案要点
背景:vLLM v1 2026年重磅更新
2026年4月,vLLM v0.18/v0.19连续发布,引入了 gRPC serving、GPU 加速投机采样、Gemma 4 支持,以及最关键的vLLM v1 PD 分离(Disaggregation)架构。这是自 PagedAttention 以来最重要的架构演进。
为什么需要 PD 分离?
传统架构的问题:
- Prefill(计算密集)和 Decode(访存密集)混合在同一 GPU
- Prefill 拖慢 Decode 的 TTFT(首 token 延迟)
- Decode 拖慢 Prefill 的吞吐量
- 资源利用率低,两者互相干扰

PD 分离的核心思路:
把 Prefill 和 Decode 解耦到不同节点,各自优化
→ Prefill 节点:计算密集,用高端 GPU(如 H100)
→ Decode 节点:访存密集,可用中端 GPU(如 A100)
vLLM v1 PD 分离架构:
┌─────────────────────────────────────────────────────┐
│              vLLM v1 PD Disaggregation              │
├─────────────────────────────────────────────────────┤
│                                                     │
│   请求入口(disagg_proxy_server)                    │
│          ↓                                          │
│   ┌─────────────────┐    KV Cache    ┌─────────────────┐
│   │  Prefiller Node  │ ──────────────→ │  Decoder Node   │
│   │  (计算密集型)    │    RDMA 传输     │  (访存密集型)    │
│   │  GPU: H100       │                 │  GPU: A100      │
│   │  Port: 8010      │                 │  Port: 8020     │
│   └─────────────────┘                 └─────────────────┘
│                                                     │
│   Key技术:MooncakeConnector + LMCache + RDMA       │
└─────────────────────────────────────────────────────┘
Mooncake + LMCache 关键技术:
"Mooncake 是字节跳动开源的 KVCache 中心化架构,核心创新是用 RDMA 高带宽网络实现 Prefiller 和 Decoder 之间的 KV Cache 传输。LMCache 是配套的 KV Cache 管理层,支持 Mooncake Store 作为后端,实现 KV Cache 的分块存储和传输。"
Mooncake 架构核心组件:
| 组件 | 角色 | 说明 |
|---|---|---|
| Mooncake Store | KV Cache 存储引擎 | 支持 RDMA 传输,延迟 < 100μs |
| LMCache | KV Cache 管理层 | 统一接口,支持 chunk 级别传输 |
| MooncakeConnector | vLLM v1 连接器 | 内置支持,即插即用 |
| disagg_proxy_server | 请求路由 | 把请求分发到 Prefiller/Decoder |
生产部署配置示例:
# Prefiller Node 配置(Machine A, 192.168.0.2)
# mooncake-prefiller-config.yaml
chunk_size: 256
remote_url: "mooncakestore://192.168.0.3:50052/"
remote_serde: "naive"
local_cpu: False
max_local_cpu_size: 100
extra_config:
  local_hostname: "192.168.0.2"
  metadata_server: "http://192.168.0.3:8080/metadata"
  protocol: "rdma"
  device_name: "mlx5_0"        # RDMA 网卡
  master_server_address: "192.168.0.3:50052"
  global_segment_size: 32212254720  # 30GB
  local_buffer_size: 1073741824     # 1GB

# Decoder Node 配置(Machine B, 192.168.0.3)
# mooncake-decoder-config.yaml
chunk_size: 256
remote_url: "mooncakestore://192.168.0.3:50052/"
remote_serde: "naive"
extra_config:
  local_hostname: "192.168.0.3"
  metadata_server: "http://192.168.0.3:8080/metadata"
  protocol: "rdma"
  device_name: "mlx5_0"
  master_server_address: "192.168.0.3:50052"
  global_segment_size: 32212254720
  local_buffer_size: 1073741824
启动命令:
# Prefiller Node(Machine A)
CUDA_VISIBLE_DEVICES=0 \
python3 -m vllm.entrypoints.openai.api_server \
  --host 0.0.0.0 --port 8010 \
  --model meta-llama/Llama-3-70B-Instruct \
  --gpu-memory-utilization 0.9 \
  --kv-transfer-config '{"kv_connector":"MooncakeConnector","kv_role":"kv_producer","num_workers":10}'

# Decoder Node(Machine B)
CUDA_VISIBLE_DEVICES=0 \
python3 -m vllm.entrypoints.openai.api_server \
  --host 0.0.0.0 --port 8020 \
  --model meta-llama/Llama-3-70B-Instruct \
  --gpu-memory-utilization 0.9 \
  --kv-transfer-config '{"kv_connector":"MooncakeConnector","kv_role":"kv_consumer"}'

# 启动 Proxy Server(Machine B,Decoder 节点上)
python3 -m lmcache.disagg_proxy_server \
  --port 8000 \
  --prefill-address 192.168.0.2:8010 \
  --decode-address 192.168.0.3:8020
vLLM v1 vs v0 关键区别:
| 维度 | v0(传统架构) | v1(PD 分离) |
|---|---|---|
| Prefill/Decode | 同一进程/GPU | 分离到不同节点 |
| KV Cache 传输 | 无(本地) | RDMA 跨节点 |
| 资源利用率 | 互相干扰 | 各自独立优化 |
| TTFT | 受 Decode 影响 | Prefill 独立,TTFT 更稳定 |
| 适用场景 | 中小规模 | 超大规模、高并发 |
| 部署复杂度 | 低 | 高(需要 RDMA 网络) |
DeepSeek MoE + PD 分离实战数据:
示例表达(仅在能用本人经历或可复现实验佐证时使用): "vLLM 官方博客显示,在 H200 上部署 DeepSeek MoE 模型,结合 Wide-EP(Expert Parallel)和 PD 分离,实测达到 2.2k tok/s/H200 的吞吐量。关键优化:Wide-EP 最大化 KV Cache 效率(MLA 架构),Dual-Batch Overlap(DBO)减少通信瓶颈,EPLB(Expert Parallel Load Balancing)解决专家负载不均问题。"
EAGLE + PD 分离叠加效果:
# vLLM v1 + EAGLE 投机采样 + PD 分离组合配置
llm = LLM(
    model="meta-llama/Llama-3-70B-Instruct",
    tensor_parallel_size=8,
    speculative_config={
        "model": "yuhuili/EAGLE-LLaMA3-Instruct-8B",
        "num_speculative_tokens": 4,
        "method": "eagle",
    },
    # PD 分离配置
    kv_transfer_config={
        "kv_connector": "MooncakeConnector",
        "kv_role": "kv_both"  # 对称模式
    }
)
# Prefiller: EAGLE 预测 + PD 传输 KV
# Decoder: 接收 KV + EAGLE 验证 + 最终输出
# 效果:Prefill 加速 3-5x,Decode 延迟降低 40%
生产选型建议:
| 场景 | 推荐方案 |
|---|---|
| 小规模(< 10 QPS) | 传统 vLLM,单机多卡 |
| 中等规模(10-100 QPS) | vLLM v0 + Continuous Batching |
| 大规模(> 100 QPS) | vLLM v1 + PD 分离 + Mooncake |
| 超大规模 + MoE 模型 | vLLM v1 + PD + Wide-EP + DBO |
面试话术:
"Prefill/Decode 分离利用两阶段资源特征不同:Prefill 通常更偏计算,Decode 通常更受 KV Cache 读取和显存带宽影响。分离可独立扩缩和调度,但新增 KV 传输、网络、路由、故障恢复与负载均衡成本,并非一定优于共置。应按长度分布、并发和 SLO 比较端到端收益。"
延伸阅读:
版本: v3.0 | 更新: 2026-05-14 | by 二狗子 🐕
Q16: 什么是 Continuous Batching 和 Chunked Prefill?2026 年为什么它们是推理引擎的核心优化?
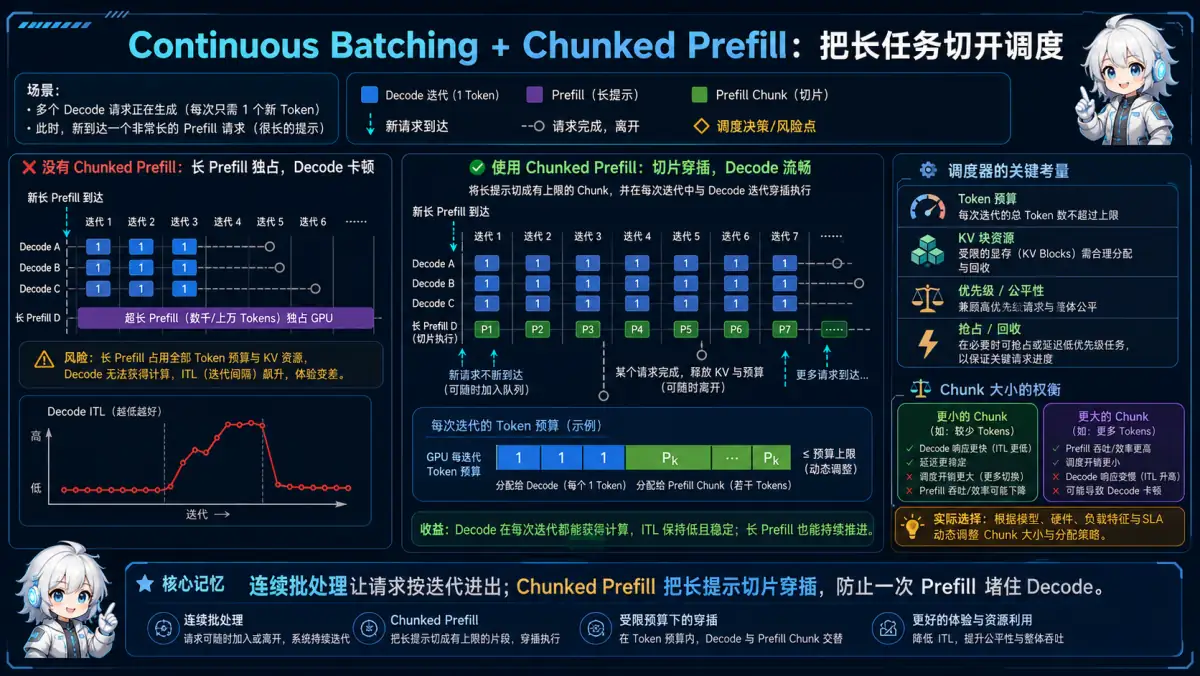
🧠 记忆锚点:连续批处理让请求按迭代进出;Chunked Prefill 把长提示切片穿插,防止一次 Prefill 堵住 Decode。
💡 答案要点
背景:推理系统的三大瓶颈
"LLM 推理有三大瓶颈:计算(Compute)、内存(Memory Bandwidth)、通信(Network)。2026 年主流推理引擎(vLLM、SGLang、TGI)的核心优化都围绕这三点展开,其中 Continuous Batching 和 Chunked Prefill 是最具生产价值的两项技术。"
Continuous Batching(连续批处理)
传统 Batching(Static Batching):
  → 批量接收请求,等所有请求完成,一起返回
  → 问题:短请求等长请求,GPU 利用率低

Continuous Batching(迭代级批处理):
  → 每生成一个 token 就重新分配 GPU 资源
  → 完成生成的用户立即离开,新用户立即加入
  → GPU 利用率最大化
对比图:
Static Batching 时序:

请求A:[────────生成16步────────]
请求B:[────────────────生成32步────────────────]
请求C:[────────生成16步────────]

↓ GPU 利用率:低(长请求阻塞短请求)

Continuous Batching 时序:

步1: [A][B][C]    → 生成 3 tokens 并行
步2: [A][B][C]    → 生成 3 tokens 并行
...
步16: [A完成][B][C] → A 离开,C 加入
步17: [D][B][C]    → 新请求 D 加入
...
Chunked Prefill(分段预填充)
问题:预填充阶段(计算 attention)显存需求巨大
     长序列预填充会阻塞新请求进入

解决:将预填充分成多个 chunk,逐块处理
     每个 chunk 后插入一个 decode step
     新请求可以更快进入 decode 阶段
传统 Prefill:
[===========Prefill 128K tokens===========] → decode → Blocked!
Chunked Prefill:
[Prefill 4K] → decode → [Prefill 4K] → decode → [Prefill 4K] → decode → ...
↑ 新请求可以更快进入配置示意(参数名随框架版本变化,使用前查官方文档):
# vLLM 风格的 chunked prefill 配置示意
config = {
    "chunked_prefill": {
        "max_chunk_size": 4096,  # 每块 4K tokens
        "preemptible": True,      # 可抢占长序列
        "decode_ratio": 0.3       # 每 3 个 prefill token 插入 1 个 decode
    }
}

# 生产效果:
# - 首 token 延迟降低 40%
# - 吞吐量提升 2-3x
# - 长短请求混合场景下 GPU 利用率 > 85%
Continuous Batching + Chunked Prefill 的组合效果:
| 指标 | 传统 Batching | Continuous + Chunked |
|---|---|---|
| GPU 利用率 | 40-60% | 80-95% |
| 平均时延(P99) | 高(长请求阻塞) | 低(动态分配) |
| 吞吐量 | 100 req/s | 300+ req/s |
| 长序列支持 | 差(阻塞严重) | 好(chunked preemptible) |
生产级配置建议:
# vLLM 生产配置
vllm serve meta-llama/Llama-4-17B
  --gpu-memory-utilization 0.92
  --max-num-batched-tokens 32768
  --max-num-seqs 256
  --enable-chunked-prefill
  --prefill-chunk-size 4096
  --scheduler-max-num-seqs 256
面试话术:
“Continuous Batching 在迭代粒度补入和移出请求,提高调度灵活性;Chunked Prefill 把长输入拆开,减少单个 Prefill 长时间阻塞 Decode。它们可能提高稳定吞吐并改善尾延迟,但收益取决于长度分布、并发和调度参数,必须用 TTFT、ITL、吞吐和任务质量共同验证。”
延伸阅读:
- vLLM 官方文档:Chunked Prefill(以当前版本为准)
- Hugging Face: "Continuous Batching Explained"
六、分布式推理与结构化生成
Q17: Tensor Parallelism 到底怎么分片?AllReduce 通信成本有多大?什么时候该用 DP/PP/EP 代替?
🧠 记忆锚点:TP 是层内水平切分,每步需要 AllReduce;DP 扩并发但不省显存,PP 切层间但流水线气泡多,EP 只适合 MoE。
💡 答案要点
Tensor Parallelism(TP)= 把每一层的矩阵拆到多个 GPU 上并行计算
核心原理:
一个 Linear 层: output = x @ W^T + b

W 是 [hidden_size, hidden_size] 的矩阵
如果 hidden_size=4096,FP16 权重 ≈ 32MB
多层叠加 → 模型总大小数十 GB

TP 做法:把 W 按列切成 n 份(n=GPU数量)
  W_0: [hidden_size, hidden_size/n]
  W_1: [hidden_size, hidden_size/n]
  ...

每个 GPU 只持有 W 的一部分
每个 GPU 只做部分乘法,然后 AllReduce 求和
TP 执行流程(单层 Attention):
# TP=4 时,输入 x 也在 GPU 间做 AllGather
x_sharded = allgather(x, dim=-1)      # 在 GPU 间拼回完整向量
# 每个 GPU 用自己的那部分权重计算
q_i, k_i, v_i = self.qkv[i](x_sharded)  # q/k/v 也是切分的
output = self.attention(q_i, k_i, v_i)
# 所有 GPU 的输出做 AllReduce 求平均
output_full = allreduce(output)          # NCCL AllReduce
AllReduce 通信成本分析:
| GPU数量 | 层数(Llama2-7B) | 每次前向传播通信量 |
|---|---|---|
| 1 | 32 | 0 |
| 2 | 32 | 32 × 2 × 4KB × 2 = ~512MB |
| 4 | 32 | 32 × 4 × 4KB × 2 = ~1GB |
| 8 | 32 | 32 × 8 × 4KB × 2 = ~2GB |
关键洞察:
- TP 通信量随 GPU 数量线性增长
- NVLink(~600GB/s)可以消化中等规模(≤4×A100)的 TP
- PCIe(~20GB/s)会导致严重瓶颈(>4×GPU)
- 跨机 TP 几乎不可用,除非有 InfiniBand/RDMA
其他并行策略对比:
| 维度 | Tensor Parallelism (TP) | Pipeline Parallelism (PP) | Data Parallelism (DP) | Expert Parallelism (EP) |
|---|---|---|---|---|
| 切分方式 | 层内矩阵切分 | 层间分割 | 请求级复制 | MoE expert 分布 |
| 显存占用 | 除以 TP_SIZE | 除以 PP_SIZE | 不减少 | 除以 EP_SIZE |
| 吞吐量提升 | ~N倍(N=GPUs) | ~N/M倍(M=bubble) | N倍(理想) | ~EP_SIZE倍 |
| 通信开销 | 高(每步 AllReduce) | 中(阶跃边界气泡) | 低(仅梯度聚合) | 高(AllToAll) |
| 适用场景 | 单节点多GPU | 跨节点大规模 | 高并发吞吐 | MoE 模型 |
| 精度保证 | 完全相同 | 可能有数值差异 | 完全相同 | 完全相同 |
MoE + Expert Parallelism(2026 面试热点):
DeepSeek V3(671B 参数,256 experts):
  - 每次激活只路由到 2 个 experts
  - 有效激活参数 ≈ 37B(远小于 671B)

  传统 TP=8: KV Cache 被复制 8 次!(MLA 只有一个 KV head)

  DP+EP 方案:
    - DP=8: 8 份请求各跑一份完整的模型
    - EP: 256 experts 分布在 8×32=256 个 expert slots 上
    - 每个 GPU 持有 1/8 的 KV Cache(不复制!)
    - 每个 GPU 持有 1/8 的 experts
    - AllToAll 只在激活时需要(每次只路由 2 experts)
选型决策树:
模型能放入单卡吗?
  ├─ 能 → 直接单卡推理
  └─ 不能 → 需要并行
      ├─ MoE 模型?
      │   ├─ 单节点 NVLink → TP+EP(推荐)
      │   └─ 跨节点 → EP(Wide-EP)
      ├─ Dense 模型且单节点?
      │   └─ TP(优先选 TP,简单可靠)
      ├─ 高并发需求?
      │   └─ DP(独立副本,扩 QPS)
      └─ 超大模型跨节点?
          └─ PP(或 TP+PP 组合)
面试话术:
"Tensor Parallelism 是把层内的矩阵按列切分到不同 GPU,每步前向传播都需要 AllReduce 同步。通信开销随 GPU 数线性增长,所以单节点 NVLink 场景 TP≤4 最合适。MoE 模型要用 Expert Parallelism,配合 DP 可以避免 MLA 结构下 KV Cache 的无效复制。大模型跨节点通常选择 Pipeline Parallelism,但要注意 pipeline bubble 问题。"
Q18: Structured Generation / Constrained Decoding 是什么?为什么 2026 年面试官频繁问到这个?
🧠 记忆锚点:把约束编译成 FSM/CFG,解码时屏蔽非法 token;保证结构正确但代价是延迟增加和表达能力受限。
💡 答案要点
Structured Generation = 让 LLM 严格按照预定义格式生成输出
为什么重要(2026 年成为高频题):
- 企业应用 80%+ 的场景需要结构化输出(JSON API、工具调用、SQL 查询)
- Prompt 工程「让模型返回 JSON」的错误率仍然高达 20-50%
- Constrained decoding 将结构化输出的错误率降至接近 0
两种主流技术路线:
1. Grammar-Guided Decoding(语法引导解码)
原理:将 JSON Schema 编译为 CFG(上下文无关文法),解码时实时屏蔽非法 token

实现流程:
  JSON Schema {
    "type": "object",
    "properties": {
      "name": {"type": "string"},
      "age": {"type": "integer"}
    },
    "required": ["name", "age"]
  }

  ↓ 编译为 CFG
  Start → "{ name : str , age : int }"

  ↓ 解码时维护状态机
  Step 1: 生成 `{` → 状态变为 expect_name
  Step 2: 生成 `"name"` → 状态变为 colon1
  Step 3: 生成 `:` → 状态变为 string_value
  Step 4: 只能生成字符串相关的 token
  Step 5: 生成 `,` → 状态变为 expect_age
  ...

优势:理论上保证零结构错误
劣势:复杂 schema 的状态机会很大,影响速度
2. Two-Pass Refinement(两阶段修正)
第一阶段:自由生成草稿
  model.generate('{"status": "ready", "order_id": ...}')
  → 可能产生 {"age": "thirty"} 等不规范内容

第二阶段:小模型修复
  refined_model = small_fine_tuned_model()
  result = refined_model.fix_schema(draft, schema)
  → 自动修正为 {"age": 30}

优势:不需要修改基座模型的 logits
劣势:额外模型调用增加了延迟和成本
主流框架对比(2026 Q3):
| 框架 | 技术路线 | 支持语言 | 性能 |
|---|---|---|---|
| Outlines | CFG + NFSA | JSON, Regex, Python | 中等(约 10-15% 减速) |
| XGrammar | XLA 加速的 CFG | JSON, SQL, Pydantic | 快(接近原生推理速度) |
| LLGuidance | 动态 FSM | 任意约束 | 最快(~5% 减速) |
| vLLM built-in | Outlines 集成 | JSON, Regex | 方便(开箱即用) |
LLGuidance(2026 最新进展):
核心创新:动态 FSM 编译 + CUDA kernel 优化

传统方案:每次解码都遍历整个状态机 → O(state_size)
LLGuidance:位运算批量处理 → O(1) per step

性能对比(13B 模型,JSON Schema 输出):
| 方案              | 吞吐(tok/s)| 减速比 |
|-------------------|-------------|--------|
| 无约束            | 95          | 1.0x   |
| Outlines          | 85          | 1.12x  |
| XGrammar          | 90          | 1.06x  |
| LLGuidance        | 92          | 1.03x  |
实际面试中的应用:
典型场景:Agent 工具调用
  prompt = """你是一个客服助手。
  根据用户问题,判断意图并调用对应工具。
  必须返回如下 JSON 格式:
  {
    "intent": "xxx",
    "tool": "get_balance" | "transfer_money" | "query_order",
    "parameters": {...}
  }"""

  # 使用 constrained decoding
  outputs = llm.generate(prompts, schema=ToolCallSchema)

  # 100% 符合 schema,无需 post-processing
局限性与权衡:
| 优点 | 缺点 |
|---|---|
| 结构化输出零错误 | 复杂 schema 状态机大 → 延迟增加 |
| 无需后处理验证 | 降低模型创造性(对创意任务不利) |
| 节省 API 重试成本 | 不支持嵌套动态字段 |
| Agent 工具调用标准化 | 无法保证值域正确性(schema 对了但值错了) |
面试话术:
"Constrained decoding 的本质是在解码循环中插入一个规则检查器,实时排除违反约束的 token。它保证了输出结构正确,但不能保证语义正确——一个完美格式的 JSON 可能包含错误的数据。2026 年的趋势是用轻量级的 FSM 引擎(如 LLGuidance)来最小化性能损耗。在实际生产中,structured generation 主要用在工具调用和数据提取场景,不适合创意写作类任务。"
Q19: MoE 模型推理时,Expert Parallelism vs Tensor Parallelism 怎么选?DeepSeek MLA 架构为什么不能用标准 TP?
🧠 记忆锚点:MoE 的专家负载天然分散,EP 匹配稀疏路由;MLA 单 KV head 导致标准 TP 下 KV 翻倍复制,DP+EP 才是正解。
💡 答案要点
MoE 推理的核心挑战:专家负载均衡 + 通信效率
MoE 基本原理回顾:
Dense Transformer:
  输入 x → MLP(x) → 输出
  MLP 是全连接的,每个样本都经过全部参数

MoE Transformer:
  输入 x → Router(x) → 选出 top-k experts
  例如 top-2: Expert[3] + Expert[7]
  输出 = gate[3] * Expert[3](x) + gate[7] * Expert[7](x)

效果:671B 参数的 DeepSeek V3,每次只激活 37B
→ 推理时 compute 只需要 5.5% 的参数量
为什么标准 TP 不适合 MoE(特别是 DeepSeek MLA 架构):
DeepSeek V3 采用 MLA (Multi-Latent Attention):
  - 只有 1 个 KV head(而不是 128 个)
  - 通过低秩投影压缩 KV 表示

问题:标准 TP 会把 KV head 也切分到不同的 GPU
  但 MLA 只有一个 head → 无法切分!
  结果:每个 GPU 都要存储完整的 KV Cache
  → 8× TP = KV Cache 复制 8 倍,浪费 87.5% 显存
解决方案:Data Parallelism + Expert Parallelism (DP+EP)
DP+EP 配置 (vLLM):
  --data-parallel-size 8          # 8 份请求
  --enable-expert-parallel        # experts 分布

工作原理:
  GPU 0: 处理 requests[0], has experts[0..31]
  GPU 1: 处理 requests[1], has experts[32..63]
  ...
  GPU 7: 处理 requests[7], has experts[224..255]

好处:
  ✓ KV Cache 不重复(每个 request 只在 1 个 GPU)
  ✓ Expert 负载均匀分布(256 experts / 8 GPUs = 32/GPU)
  ✓ 显存利用率高
AllToAll 通信详解(MoE 特有的瓶颈):
Step 1: 路由器决定每个 token 去哪个 expert
  样本 A 的 token → Expert[5]
  样本 B 的 token → Expert[5]
  样本 C 的 token → Expert[12]

Step 2: AllToAll 将所有目标 Expert[5] 的 token 发送到 GPU 负责 Expert[5] 的节点

Step 3: Expert[5] 在前向传播中处理这些 tokens

Step 4: AllGather 将处理结果发回原属样本的 GPU

通信成本:
  Token 越碎 → 路由粒度越小 → AllToAll 频率越高
  专家越多 → 每次激活的专家越少 → AllToAll 开销相对越低
  (这是 MoE 的核心优势:sparse activation)
Wide-EP(NVIDIA 2026 新方案):
当 EP 规模跨越多个 GPU 集群时的挑战:
  - NVLink 只能覆盖单节点内部
  - 节点间走 InfiniBand/RDMA,延迟远高于 NVLink

Wide-EP 思路:
  把 expert 按拓扑结构分组,同一节点的 expert 尽量放在邻近 GPU
  DeepEP 库支持:
    - deepep_high_throughput:最大化带宽利用率
    - deepep_low_latency:最小化首 token 延迟
    - flashinfer_nvlink_one_sided:NVLink 上的单向传输
选型指南(2026 生产实践):
| 模型 | GPU 数量 | 推荐方案 | vLLM 配置 |
|---|---|---|---|
| Mixtral 8x7B | 2-4 | TP + EP | --tensor-parallel-size 4 --enable-expert-parallel |
| DeepSeek V3 | 8 | DP + EP | --data-parallel-size 8 --enable-expert-parallel |
| Kimi K2 (384 experts) | 8-16 | TP + EP (Wide-EP) | --tensor-parallel-size 8 --enable-expert-parallel |
| Llama 4 Maverick | 16+ | TP + PP + EP | --tensor-parallel-size 8 --pipeline-parallel-size 2 |
面试话术:
"MoE 推理的核心矛盾是:compute 很稀疏(每次只用少量 expert),但路由和负载均衡需要复杂的跨 GPU 通信。标准 TP 对 Dense 模型有效,但对 DeepSeek 的 MLA 架构不行——因为 KV head 只有 1 个,无法切分。正确的选择是 DP+EP,数据级并行处理请求,专家级并行分布专家权重。跨节点扩展则依赖 Wide-EP 和 DeepEP 等专用库。"
Q20: 生产环境 LLM 服务出问题了,你有哪些排查思路和诊断指标?
🧠 记忆锚点:先看延迟特征(TTFT spike vs ITL jitter),再查资源水位(显存/CPU/网络),最后看调度日志定位。
💡 答案要点
生产环境 LLM 服务的三大核心症状:
症状1: TTFT(首 token 延迟)飙升
  表现:用户等了 3-5 秒才看到第一个字
  原因排查方向:
    ├── 长 prompt 阻塞 → Chunked Prefill 未开启
    ├── 队列堆积 → 并发过高,max_num_seqs 设置过低
    ├── GPU 过载 → batch size 超过硬件承载
    └── KV Cache 碎片化 → PagedAttention 未启用或碎片率 >30%

症状2: TPOT(逐 token 延迟)抖动
  表现:流式输出不均匀,有的 token 慢有的快
  原因排查方向:
    ├── Decode 阶段 GPU 利用率不足 → batch size 太小
    ├── 内存带宽瓶颈 → 模型过大或 context 过长
    ├── 上下文窗口膨胀 → 某些请求 context 远超均值
    └── KV Cache 量化误差累积 → 质量下降引发重试

症状3: OOM(显存溢出)拒绝请求
  表现:大量 429 响应 "GPU out of memory"
  原因排查方向:
    ├── max_model_len 设置过大,预留了过多 KV Cache 空间
    ├── long tail 请求触发 OOM(某几个请求特别长)
    ├── preemption 过于保守或过于激进
    └── 系统负载突增,未做 rate limiting
系统性诊断流程(从外到内):
第1层:监控仪表盘
  ├── GPU Utilization %(整体算力利用率)
  ├── GPU Memory Allocated vs Free(显存水位)
  ├── KV Cache Hit Ratio(前缀缓存命中率)
  ├── Request Queue Length(等待队列长度)
  ├── TTFT P50/P95/P99(首 token 延迟分布)
  ├── TPS(tokens per second,分 input/output)
  └── Error Rate(429/OOM/超时占比)

第2层:根因推断表
  ┌──────────────┬───────────────────────────────────────┐
  │ TTFT 高       │ 可能原因                              │
  ├──────────────┼───────────────────────────────────────┤
  │ + GPU util <50%│ 队列空但单次 prefills 太长           │
  │ + KV cache miss │ 共享前缀少,prefix caching 命中率低 │
  │ + queue > 100  │ 请求涌入速率 > 处理能力               │
  └──────────────┴───────────────────────────────────────┘

第3层:代码级调试
  ├── 检查 vLLM/sGLang 的内部 metrics(prometheus endpoint)
  ├── 查看 scheduler logs:哪些请求卡在队列里?
  ├── 采样 profile(cProfile/py-spy)确定 bottleneck
  └── 使用 triton profiler 看 kernel 执行时间
关键监控指标解释:
| 指标 | 正常范围 | 异常信号 | 行动建议 |
|---|---|---|---|
| GPU Utilization | 60-90% | <40% 说明资源浪费,>95% 说明超载 | 调整 batch size |
| KV Cache Hit Ratio | >30% | <10% 说明前缀复用差 | 检查 prefix caching 配置 |
| Queue Length | <50 | >200 持续存在 | 扩容或限速 |
| Preemption Rate | <5% | >20% 频繁打断正在生成的请求 | 调大显存分配 |
| P99 TTFT | <1s | >3s 用户体验差 | 开 chunked prefill |
实战案例:
场景:API 响应变慢,P99 TTFT 从 500ms 飙到 3s

排查过程:
1. 看 dashboard:GPU util 85%,queue length 50 → GPU 没满,但不是极端拥堵
2. 看 KV cache hit ratio:2%(极低)→ 没有复用前缀
3. 看 max_model_len:设了 32768,实际平均请求只有 2048 → 显存浪费 80%
4. 解决方案:
   a) 设置合理的 max_model_len(按实际 95 分位数)
   b) 开启 enable_prefix_caching=True
   c) 开启 dynamic eviction budget 限制最大 KV 使用

修复后:TTFT 降回 600ms
面试话术:
"排查 LLM 服务问题要分层:先宏观看 dashboard 的 7 大指标定位大类,再用根因推断表缩小范围,最后深入 logs 和 profile 找具体 bug。最关键的两个指标是 KV Cache Hit Ratio(反映缓存效率)和 Queue Length(反映调度压力)。生产环境中大多数性能问题源于资源配置不当——max_model_len 设太大或者没开 prefix caching——而不是算法缺陷。"
Q21: Context Window Compression 有哪些技术手段?Semantic Cache 和 Sliding Window 在什么场景下用?
🧠 记忆锚点:压上下文不是丢信息而是换表达方式;缓存高频 query 省计算,滑动窗口保局部性,摘要保全局但可能丢失细节。
💡 答案要点
Context Compression = 在不牺牲关键信息的前提下减少上下文长度
五种主流压缩策略:
1. Semantic Cache(语义缓存)
原理:不缓存精确的 prompt,而是缓存 embedding + response

流程:
  1. 收到请求 R,计算 embedding(R)
  2. 在向量数据库中查找最近邻
  3. 如果相似度 > 阈值(如 0.95),返回缓存结果
  4. 否则正常推理,并将结果加入缓存

示例:
  缓存条目: "如何设置 Docker 端口映射" → response_A
  新请求: "Docker 端口怎么映射" → 语义相似,命中缓存

收益:对常见查询可达 30-50% 的计算量节省
适用场景:FAQ 型应用、客服系统、知识库问答
2. Sliding Window(滑动窗口)
原理:只保留最近的 N 个 tokens 作为上下文

实现:
  model = GPT-4 (32K context)
  window_size = 4096  # 只保留最近 4K tokens

  对话历史: [...8K tokens...]
  当前请求: "关于刚才的话题继续"

  传给模型的: 最后 4K tokens + 当前请求
  更早的内容: 丢失

优点:简单高效,显存可控
缺点:早期信息完全丢失,不适合长文档阅读
适用场景:闲聊对话、实时聊天
3. Summary-Based Compression(摘要压缩)
原理:将早期内容摘要后替换

实现流程:
  原始上下文 (16K):
    [早期对话 8K] [近期对话 8K]

  Step 1: 对 [早期对话 8K] 用 LLM 生成摘要
    摘要 = "讨论了项目计划,确定了三个里程碑..."

  Step 2: 构造新上下文
    [摘要文本 500 tokens] [近期对话 8K]

  总长度: ~8.5K tokens

注意:摘要本身也会占空间,所以要控制摘要长度
4. Selective Retention(选择性保留 — H2O 论文)
原理:不是简单地丢弃旧的,而是按需保留重要的

策略:
  - Head-of-memory (HoTM): 保留最近 M 个 tokens
    (确保最新上下文一定在)
  - Tail-of-memory (ToM): 保留最早 N 个 tokens
    (确保开头信息不被丢失)
  - 中间部分: 按需保留注意力分数高的

实验:H2O 在 128K context 上达到 95% 的性能
同时只使用 ~16K 的有效 tokens
5. Dynamic Eviction(动态驱逐)
原理:运行时根据注意力分数动态淘汰不重要 token

实时监控:
  while generating:
    attention_scores = compute_attention(input_tokens)
    low_attention = sort_and_select_bottom_k(attention_scores)
    remove(low_attention)  # 从 KV Cache 中移除

效果:根据实际使用情况动态调整,不像静态策略那样一刀切
策略对比与选型:
| 策略 | 适用场景 | 效果 | 复杂度 | 质量损失 |
|---|---|---|---|---|
| Semantic Cache | 高频重复查询 | ⭐⭐⭐⭐⭐ | 低 | 0%(命中即无损失) |
| Sliding Window | 实时对话 | ⭐⭐ | 极低 | 高(早期信息全失) |
| Summary | 长文档分析 | ⭐⭐⭐⭐ | 中 | 低(摘要可能丢失细节) |
| Selective Retention | 超长上下文 | ⭐⭐⭐⭐ | 高 | 很低(论文称 95%) |
| Dynamic Eviction | 在线推理优化 | ⭐⭐⭐⭐ | 高 | 低 |
面试话术:
"上下文压缩不是单一技术方案,而是针对不同场景的策略集合。Semantic Cache 对重复查询最有效,零质量损失。Sliding Window 最简单但早期信息全失。Summary 和 Selective Retention 适合长文档分析,在质量和效率间做权衡。实际生产中通常是组合使用——比如语义缓存打底 + sliding window 兜底。"
Q22: KV Cache Offloading 和 Context Parallelism(环注意力 Ring Attention)是什么?解决什么痛点?
🧠 记忆锚点:Offloading 用 CPU/SSD 扩容上下文窗口但增加访存延迟;Ring Attention 用环形通信分块计算全注意力,消除 O(n²) 显存墙。
💡 答案要点
两大超长期文上下文问题的解决方案:
1. KV Cache Offloading(KV Cache 卸载)
问题:单卡显存有限,放不下长序列的 KV Cache
  70B FP16 + 128K context → KV Cache ≈ 50GB
  单 A100 80GB → 只剩不到 30GB 放权重

Offloading 思路:把用不到的 KV 卸到 CPU 内存或 SSD

实现:
  GPU: 存放最近 N 个 tokens 的 KV(热数据)
  CPU: 存放其余 tokens 的 KV(冷数据)

  当需要访问远处的 token 时:
    1. 从 CPU/GPU 加载 KV block
    2. 暂时放入 GPU 显存用于 Attention 计算
    3. 计算完后释放回磁盘

关键技术挑战:
  ├── GPU-CPU 带宽瓶颈(PCIe ~20GB/s vs HBM ~2TB/s)
  ├── 频繁的 page fault 导致延迟波动大
  └── SSD offload 更慢但容量更大

代表实现:
  - InfiniGen:预测性地 prefetch 重要 KV entries
  - VM-FlashLLM:基于虚拟内存管理的 KV 分页
  - LoongServe:Elastic Sequence Parallelism 动态适配资源
2. Context Parallelism / Ring Attention(环注意力)
问题:自注意力机制的显存复杂度是 O(n² × d)
  128K context × 4096 dim = 巨大的 attention matrix

Ring Attention 思路:把 sequence 切成多段,按 ring 拓扑依次计算

实现:
  4 个 GPU 组成 ring:GPU0 → GPU1 → GPU2 → GPU3 → GPU0

  输入序列分为 4 段:[seg0][seg1][seg2][seg3]

  Round 1:
    GPU0 持有 [seg0],但需要所有 seg 的 K/V
    → 接收 seg1,seg2,seg3 的 K/V(ring 转发)
    → 计算 [seg0] 对 [all] 的 attention

  Round 2: seg 轮换
    每个 GPU 的 K/V 传到下一个 GPU

  Round 3: 继续...
    直到每个 GPU 计算完自己的 segment 对所有人的 attention

  最终拼接所有 partial results

关键创新:
  - 不需要 O(n²) 的完整 attention matrix
  - 每个 GPU 只存储 O(n/k) 的 partial result
  - 总显存复杂度降到 O(n) 而非 O(n²)

Striped Attention 改进(Meta 2025):
  传统 Ring Attention 中,所有 GPU 同时收发数据会竞争
  Striped Attention 把数据 striped 打散,不同 GPU 在不同 round
  处理不同部分,减少冲突
Offloading vs Ring Attention 对比:
| 维度 | KV Cache Offloading | Ring Attention |
|---|---|---|
| 解决痛点 | 显存不够放长上下文 | Attention 计算显存墙 |
| 核心操作 | 冷热交换(swap/in) | 环形分发计算 |
| 性能代价 | 访存延迟增大 5-20x | 通信开销增加 |
| 上下文上限 | 受 CPU/SSD 容量限制 | 受 GPU 数量和带宽限制 |
| 实现难度 | 中(需管理 page lifecycle) | 高(需定制 kernel + 通信协议) |
| 生产可用性 | 已有(LoongServe, VM-FlashLLM) | 研究阶段(FlashInfer, Megatron) |
面试话术:
"KV Cache Offloading 用外部存储换显存,适合上下文极长的场景,代价是延迟波动大。Ring Attention 则是用通信换显存复杂度,把 O(n²) 降到 O(n),让 1M+ token 上下文在有限的 GPU 上可行。两者解决的是不同层面的问题——offloading 解决容量,ring attention 解决计算密度。实际生产中,前者已可用,后者还在快速演进。"
版本: v3.1 | 更新: 2026-10-22 | by 二狗子 🐕
Q23: CUDA Graphs 如何加速 LLM Decode?为什么只适合 Decode 不适合 Prefill?Breakable CUDA Graph 是什么?
🧠 记忆锚点:Capture 记录算子执行序列消除 launch overhead;batch shape 固定是前提,所以只适合 Decode;Breakable 用混合策略平衡内存和延迟。
💡 答案要点
为什么需要 CUDA Graphs?
传统 Kernel Launch 流程(每步 Decode):
CPU → kernel_launch(kernel_A) → GPU执行 → CPU等待 → kernel_launch(kernel_B) → ...
         ↑     每次约 10-50μs      ↑              ↑     又重复...

问题:每次生成一个 token 都要经过完整的 CPU-GPU-Kernel 循环
对于 batch=32 的场景:32次 × 几十个小kernel = 巨大的 launch overhead
结果:GPU 实际利用率只有 20-40%(大量时间在等 launch)
CUDA Graphs 原理:
Capture 阶段(离线):
  1. 先 warmup 跑一轮正常数据
  2. 记录所有 kernel 调用序列(启动参数、指针、流)
  3. 编译成静态计算图

Replay 阶段(在线):
  1. 将新的输入 tensor 复制到 graph 输入节点
  2. 一次调用 replay() → GPU 自动按序执行所有 kernel
  3. 读取输出

效果:几十次 kernel launch → 1次 graph replay
通常带来 5-15% 的 decode 吞吐提升(对大模型收益更大)
为什么只适合 Decode 不适合 Prefill?
Decode 阶段特点:
  ✓ 每个 sequence 只产生 1 个 query token
  ✓ batch size 固定(capture 时确定)
  ✓ attention grid 由 batch_size 决定,不变
  ✓ 可预测 = 能提前 capture

Prefill 阶段特点:
  ✗ 每个请求的 prompt 长度不同(可能 2048→128K)
  ✗ batch 内各种长度混在一起
  ✗ attention grid 随每请求动态变化
  ✗ 需要 capture 多个长度的 graph = 显存爆炸

vLLM 的策略:
  - decode: full CUDA Graph(统一形状)
  - prefill: piecewise CUDA Graph(仅支持同长度 batch)
  - 混合模式(FULL_AND_PIECEWISE):decode 用 full,prefill 用 piecewise
Breakable CUDA Graphs(SGLang 2026 新方案):
传统 CUDA Graph 的问题:
  - 必须 capture 所有可能的 batch shape
  - 每种 length 都要一个 graph → 显存占用 O(max_length × num_batch_shapes)
  - 对 MoE 模型尤其严重(不同 expert 路径长度差异大)

Breakable CGS 思路:
  - 把完整计算图拆成"breakable parts"
  - prefix 部分:共享的 system prompt 用独立 graph
  - body 部分:用户内容动态拼接
  - 这样只需要 capture system_prompt_len 的 graph,而不是全长度

效果:
  - 显存占用降低 60-80%
  - Capture 时间从分钟级降到秒级
  - Replay 性能基本持平(因为大部分还是固定的 kernel)

生产现状(2026 Q3):
  - SGLang:BCG 已是默认配置
  - vLLM:支持但需手动开启
  - TensorRT-LLM:原生支持变长 capture
实际应用建议:
vLLM 中启用 CUDA Graphs:
  --enable-cuda-graph       # 全局启用
  --max-num-batched-tokens 4096  # 控制预分配上限
  --max-num-seqs            256    # max batch size

vLLM CUDA Graph 捕获配置:
  capture_modes: "FULL_AND_PIECEWISE"  # 默认模式
  # FULL: 统一形状的 decode graph
  # PIECEWISE: 各长度单独的 prefills

监控是否生效:
  - 看 vllm.gpu_cache_usage_og 指标
  - CUDA Graph hit rate > 80% 说明配置合理
选型总结:
| 场景 | CUDA Graph 收益 | 推荐配置 |
|---|---|---|
| 小模型 < 7B | ~5% | 谨慎使用,可能浪费显存 |
| 中等 13-70B | 8-12% | 推荐,标准配置 |
| 超大 100B+ | 12-18% | 必开,显著提升 |
| MoE 模型 | 5-15% + Breakable CGS | Breakable CGS 节省显存 |
| 长上下文 128K+ | 10-15% | 结合 prefix caching 效果更好 |
面试话术:
"CUDA Graphs 的本质是用空间换时间——offline 录制算子序列,online 一次性重放消除 launch overhead。它天然适合 Decode 因为 batch shape 可预测,但不适合 Prefill 因为 prompt 长度不可控。2026 年 SGLang 的 Breakable CGS 解决了 memory 膨胀问题,是当前最优解。"
Q24: vLLM vs SGLang vs TensorRT-LLM vs TGI — 2026 年如何选择推理引擎?
🧠 记忆锚点:没有绝对最好的引擎,只有最适合场景的——按前缀复用率、硬件绑定度、部署速度三维度选。
💡 答案要点
2026 年四大战国时期:
| 引擎 | 维护者 | 定位 | 核心优势 | 劣势 |
|---|---|---|---|---|
| vLLM | vLLM 社区 | 通用生产服务 | PagedAttention、Continuous Batching、最广泛的模型支持、生态最大 | 极致吞吐不如 TensorRT-LLM,prefix 复用依赖外部缓存 |
| SGLang | Berkeley LMSYS | 结构化生成/Agent | RadixAttention 前缀复用、PagedOutputToken、RLHF rollout 友好 | 小众生态,新模型 day-one 支持慢于 vLLM |
| TensorRT-LLM | NVIDIA | 极致性能/NVIDIA 专用 | 编译时优化、kernel fusion、FP8/bfloat16 原生支持、H100/A100 上吞吐最高 | 仅 NVIDIA GPU、编译时间长、不支持 AMD/Mac |
| TGI | HuggingFace | 简单部署/HF 集成 | 最简单上手、HF Hub 无缝对接、好运维 | 吞吐低于其他三者,功能迭代慢 |
选型决策框架(按三个维度打分):
维度1:你的流量是否有高前缀复用率?
  ├─ 是高前缀复用(>50%,如多轮对话/系统提示相同)
  │   └─ → 优先 SGLang(RadixAttention 天生为此设计)
  └─ 是低前缀复用(唯一 prompt/每条不同)
      └─ → 考虑 vLLM 或 TensorRT-LLM

维度2:你是否绑死 NVIDIA 硬件?
  ├─ 是(H100/A100/RTX4090),追求极致吞吐
  │   └─ → 优先 TensorRT-LLM(编译后比 vLLM 快 10-15%)
  └─ 否(多云/异构/AMD/未来可能换芯片)
      └─ → vLLM(最灵活跨平台)

维度3:你的优先级是部署速度还是极致性能?
  ├─ 快速上线(<1周出生产)
  │   └─ → vLLM(Docker 一行命令部署)
  └─ 极致优化(愿意花数天调参编译)
      └─ → TensorRT-LLM(编译+调优可达峰值)
2026 H100 实测数据对比(Llama 3.3 70B Instruct FP8):
| 指标 | vLLM 0.10 | SGLang 2.6 | TensorRT-LLM 0.14 | TGI 2.5 |
|---|---|---|---|---|
| TTFT (1 req) | 450ms | 420ms | 390ms | 680ms |
| TPOT (1 req) | 28ms | 30ms | 26ms | 35ms |
| Throughput @ conc=100 | 3,800 tok/s | 3,500 tok/s | 4,200 tok/s | 2,900 tok/s |
| Model support speed | Day-1 | Week 1 | Month 2 | Week 2 |
| GPU 数量要求 | 2+ | 2+ | 2+ | 2+ |
| Multi-model serving | ✅ | ✅(有限) | ❌ | ✅ |
| Structured output | ✅(Outlines) | ✅(native) | ✅(间接) | ✅(json_schema) |
生产环境最佳实践(2026 Q3):
初创公司 / MVP 验证:vLLM
  docker run -p 8000:8000 vllm/vllm-openai -m meta-llama/Llama-3.3-70B-Instruct
  → 最快上线,出了问题有最多社区资源可查

大规模生产(已知模型 + NVIDIA 集群):TensorRT-LLM
  - 先用 vLLM 做基准测试
  - 确认吞吐量瓶颈后迁移到 TRT-LLM
  - 编译期优化:PTQ/QAT 量化 + kernel tuning

AI Agent 场景 / RAG:SGLang
  - RadixAttention 让多轮对话共享前缀
  - PagedOutputToken 高效处理工具调用
  - 结构化输出原生支持

HuggingFace 生态用户:TGI
  - 直接在 Hub 上一键部署
  - 不需要写任何代码
  - 适合内部 demo 和轻量级 API
混合部署架构(大厂常见):
                    ┌──────────────┐
  实时对话请求 ──→   │   SGLang     │ ← RadixAttention 复用前缀
                    │ (Prefix区)    │
  唯一Prompt请求 ──→ │   vLLM       │ ← Continuous Batching
                    │ (通用区)      │
  批量分析任务 ──→   │  TensorRT-LLM│ ← 极致吞吐
                    │ (批处理区)     │
                    └──────────────┘
                          ↓
                    Load Balancer / Router
面试话术:
"2026年的推理引擎选型不是选'最快的'而是选'最适合的'。我的原则:不知道用什么就用 vLLM 因为它生态最大;有高前缀复用率就上 SGLang;绑 NVIDIA 且追求极致吞吐就搞 TensorRT-LLM。实际生产中经常是多引擎混合部署——对话走 SGLang,API 走 vLLM,批处理走 TRT-LLM。"
Q25: KV Cache 量化有哪些 2025-2026 年的新进展?KIVI、Gear、CacheQuant 有什么不同?
🧠 记忆锚点:Key 比 Value 分布更集中可以压得更狠;残差量化解决 outlier 掉点问题;动态精度匹配注意力近详远略的规律。
💡 答案要点
KV Cache 量化为什么重要?
KV Cache 占总显存的比例:
  Llama 3.1 8B, context=32K:
    - 模型权重 ≈ 16GB
    - KV Cache   ≈ 8GB
    - 激活值    ≈ 2GB
    ─────────────────
    KV Cache 占了显存的 26%

  GPT-4 级别, context=128K:
    - 模型权重 ≈ 120GB
    - KV Cache   ≈ 64GB
    ─────────────────
    KV Cache 占了显存的 35%

结论:越长的上下文,KV Cache 占比越大,量化收益越高。
KV 量化挑战:
为什么不能像权重量化一样直接 INT4?

Key 向量特点:
  - 范围窄(多数集中在 [-2, 2])
  - outlier 少
  - → 可以用更低 bit 表示

Value 向量特点:
  - 范围宽(有显著 outlier)
  - 分布不均匀
  - → 需要更高 bit 保精度

直接 uniform INT4 量化的问题:
  ❌ Value 的 outlier 被大幅截断
  ❌ long-context 召回质量下降明显
  ❌ nDCG@10 下降 5-8 个点
三大前沿方案对比:
方案1: KIVI (ICML 2025)
━━━━━━━━━━━━━━━━━━━━━━━
核心思路:Key 用 2-bit, Value 用 4-bit
实现细节:
  ├── Key: INT2 per-element,利用 Key 分布集中的特点
  ├── Value: INT4 per-element,保留更多精度
  └── 自适应分组:根据 token 位置的统计特性调整 group size

效果:
  ████████████ 压缩比 5.3x
  ████████▌    nDCG@10 损失仅 2.1%
  ████▉        Recall@100 损失 3.5%

方案2: Gear (NeurIPS 2025)
━━━━━━━━━━━━━━━━━━━━━━━━━━
核心思路:残差量化 —— 粗量化 + 高精度保留 outlier
实现细节:
  ├── 第一层:INT4 均匀量化(得到粗略估计)
  ├── 第二层:找出量化误差最大的 top-N tokens
  ├── 第三层:这些 outlier 单独用 BF16 存储
  └── 最终:大多数 token INT4 + 少数 outlier BF16

效果:
  ████████████████ 压缩比 8.0x
  ██████▍          nDCG@10 损失 3.2%
  █████▎           Recall@100 损失 4.8%
  ⚠️ 实现复杂度高(需额外存储 outlier 索引)

方案3: CacheQuant (2026)
━━━━━━━━━━━━━━━━━━━━━━━━
核心思路:动态精度分配 —— 近的精确、远的粗糙
实现细节:
  ├── 最近 N 个 tokens: BF16 (零量化)
  ├── 中间 M 个 tokens: INT6 (渐进式)
  ├── 最远 Tokens: INT4 (激进量化)
  └── 基于注意力分数动态调整:关注高的保持高精度

效果:
  ██████████████ 压缩比 6.5x
  ███████▏       nDCG@10 损失 1.8%
  ███▊           Recall@100 损失 2.9%
  ✓ 最符合人类阅读长文的直觉(近处看清远处看大意)
生产环境选型指南(2026 Q3):
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 短上下文 (<16K) | 不用量化 | KV Cache 占比小,收益有限 |
| 中等上下文 (16-64K) | KIVI | 简单高效,精度损失最小 |
| 超长上下文 (64-128K) | CacheQuant | 近详远略匹配长文理解模式 |
| 极致压缩需求 | Gear | 8x 压缩比,但需要接受稍复杂实现 |
| 已有 vLLM 部署 | KIVI (通过 vLLM plugin) | 接入成本最低 |
与权重量化的关系:
权重量化 (W4A16):压缩的是模型参数磁盘占用和加载时间
KV Cache量化(KI4):压缩的是推理过程中动态占用的显存
两者正交,可以同时使用!

典型组合:
  W4A16 + KV-INT4 → 模型16GB → 8GB
                     KV 8GB → 2GB
                     总显存占用减少约 20%
面试话术:
"KV Cache 量化是 2025-2026 年推理领域最大的进展之一。核心洞察是 Key 和 Value 分布不同——Key 分布窄可以 2-bit,Value 有 outlier 至少 4-bit。KIVI 最简单实用,Gear 压缩比最高但要处理 outlier 存储,CacheQuant 的动态精度最贴合注意力机制本质。生产环境建议先从 KIVI 开始,它的精度损失最小且易于集成。"
Q26: 输入压缩(Input Compression)有什么主流方法?LLMLingua 和 xRAG 的原理是什么?
🧠 记忆锚点:输入压缩是在 prompt 里做选择性删除——不是删文字而是删信息密度低的内容,保留关键 token。
💡 答案要点
为什么需要输入压缩?
现代 LLM 应用的典型问题:
  用户在系统中传入了 32K 的检索片段
  → 其中只有 5K 是真正相关的
  → 另外 27K 是噪音但模型仍然要处理它们
  → 消耗计算资源、增加延迟、可能引入幻觉

输入压缩的目标:
  在不影响任务性能的前提下,尽可能减少有效 token 数量
  → 降低 TTFT(首 token 更快)
  → 减少 KV Cache 大小(后续 decode 更快)
  → 降低 API 调用成本(按 token 计费时)
三种主流方案:
方案1: LLMLingua 系列 (2024-2026)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
核心思路:把压缩转化为 token 分类问题
  训练一个小模型判断「每个 token 是否应该保留」

实现步骤:
  1. 用大模型标注数据:哪些 token 是关键,哪些是噪音
  2. 蒸馏小模型(约 100M 参数)学习这个判断
  3. 部署时:小模型跑一遍 prompt → 标记冗余 token
  4. 移除冗余 token → 传给主模型

效果对比(RAG 场景):
  原始 prompt: 3000 tokens → TTFT 1.2s
  LLMLingua-2: 1200 tokens (60%压缩) → TTFT 0.6s
  答案准确率: 保持 97%(几乎无损)

适用场景:
  ✓ RAG 检索片段去冗余
  ✓ 长文档摘要
  ✓ 日志/会议记录分析

缺点:
  ✗ 额外调用一个小模型增加 latency
  ✗ 需要为特定领域微调效果才佳
方案2: RECOMP (2024)
━━━━━━━━━━━━━━━━━━━━
核心思路:用信息论度量每个 token 的信息量
基于 perplexity reduction + mutual information
实现方式:
├── Perplexity-based: 删除后能让模型 perplexity 变化最小的
├── Mutual Information: 与最终答案互信息最高的保留
└── Hybrid: 综合两种指标加权排序
优势:无需训练额外模型,纯规则驱动
劣势:对不同类型文本敏感度不同,需要调参方案3: xRAG (2025)
━━━━━━━━━━━━━━━━━━
核心思路:端到端的检索增强压缩联合优化
不是先检索再压缩,而是在检索时就考虑压缩后的效果
实现流程:
1. 原始文档 → Embedding → 检索 Top-K chunks
2. 对候选 chunks 做 xRAG scoring
3. xRAG score = relevance × compressibility
4. 优先选择「相关且易压缩」的 chunk
5. 最终返回的 chunks 天然就是精简后的
效果:
相比两阶段(先检索再压缩),端到端方法在相同压缩率下
QA 准确率提升 4-7个百分点
适用场景:
✓ 大规模知识库问答
✓ 实时 RAG 系统
✓ 需要动态调整压缩率的场景输入压缩 vs KV Cache 量化的区别:
| 维度 | 输入压缩 | KV Cache 量化 |
|---|---|---|
| 作用阶段 | 推理前(pre-processing) | 推理中(in-flight) |
| 压缩对象 | prompt token 数量 | KV 数值精度 |
| token 数量 | 减少(删除) | 不变(仅降精度) |
| 质量损失 | 可能有信息丢失 | 可控(理论保证) |
| 额外开销 | 压缩模型调用 | 无额外模型 |
| 适用场景 | 长prompt/RAG片段 | 长上下文推理 |
生产实践建议:
当 input_tokens > 4000 时考虑压缩

策略组合(推荐):
  RAG 场景:xRAG 检索筛选 + LLMLingua 压缩 → 减少 50-70% prompt tokens
  对话场景:Semantic Cache 命中则 0 tokens,未命中则正常输入
  代码生成:一般不需要压缩(代码信息密度已很高)

监控指标:
  - 压缩后 QA 准确率下降幅度(目标 < 2%)
  - TTFT 改善比例(预期 30-60% 缩短)
  - 每千 token 成本节省(按 API 定价计算)
面试话术:
"输入压缩的本质是让模型读得更少、答得更好。LLMLingua 是用小模型学会判断哪些 token 该删,RECOMP 是用信息论公式衡量每个 token 的价值,xRAG 是把压缩整合到检索过程中做端到端优化。生产环境中如果 prompt 超过 4K tokens 就应该考虑压缩,通常在 RAG 场景收益最大——能把 32K 的检索片段压到 4-8K 而保持准确率。"
Q27: 推理服务中的 Preemption(抢占)机制是什么?什么时候会触发?如何避免过度抢占?
🧠 记忆锚点:Preemption 是显存不够时优雅降级的手段——打断正在生成的请求,把它挂起等资源释放后再恢复。
💡 答案要点
什么是 Preemption?
场景:GPU 显存满了,来了一个新请求

方案 A:直接拒绝(drop)
  Request C → 429 Too Many Requests
  → 用户体验差,浪费了 scheduler 的时间

方案 B:Preempt(抢占)← vLLM 默认行为
  Request D 正在生成一半(已写了 200 tokens)
  → 暂停 D,释放它的 KV Cache 和 GPU 资源
  → 让 Request C 先执行
  → C 完成后,D 继续生成剩余部分

Preemption 的核心思想:牺牲一个请求的部分进度,换来整体的公平性和可用性。
Preemption 工作流程:
Step 1: 检测到 KV Cache 不足
  gpu_memory_utilization = 0.97  # 即将溢出
  incoming_request.blocked = True

Step 2: 选择 preempt target(谁被踢?)
  策略:优先 preemted 较长时间但未完成的请求
  └── 评估因子:已生成 token 数 / 预计完成时间 / 等待时间

Step 3: Swap out(换出到 CPU)
  KV_Cache_GPU = {D} → {C}
  KV_Cache_CPU.append(D)
  D.state = RUNNING → PAUSED

Step 4: 执行新请求
  C 获得足够的 block 来运行

Step 5: Swap in(换回)
  C 完成后,从 CPU 取回 D 的 KV Cache
  D.state = PAUSED → RUNNING
  D 从上次暂停的位置继续生成
Preemption 的成本分析:
PCIe Bandwidth 瓶颈:
  A100 PCIe 4.0 x16 ≈ 32 GB/s (双向 ~64GB/s)
  A100 HBM3带宽   ≈ 2,000 GB/s

swap_in/swap_out 延迟:
  假设 swap 1GB 的 KV Cache:
  PCIe: 1GB / 32GB/s ≈ 31ms
  HBM:  1GB / 2000GB/s ≈ 0.5ms
  → PCIe swap 比 HBM 读写慢 60x!

影响:
  频繁 preemption → 大量 swap → 实际吞吐下降而非上升
如何识别和优化 Preemption 问题:
监控指标:
  ├─ preemption_rate: 当前有多少请求被 preemped
  ├─ cpu_cache_swap_bytes: 换出的 KV Cache 总量
  └─ time_to_preempt_ms: 平均 preemption 耗时

正常范围:
  preemption_rate < 0.05 (5%以下)

异常信号:
  preemption_rate > 0.20 → 严重超载
  cpu_cache_swap_bytes 持续增长 → 显存规划有问题
避免过度抢占的策略:
策略1: 增大 max_num_seqs
  vllm.config.scheduler.max_num_batched_tokens=4096
  → 允许更大的 batch,减少排队等待
  → 代价:单个请求延迟略微增加

策略2: 调整 max_model_len 按实际需求
  不要设 32K 如果 95% 的请求都 < 4K
  → 减少预留的 KV Cache 浪费
  → 推荐:观察历史数据的 95th percentile

策略3: 开启 dynamic GPU cache config
  enable_prefix_caching=true
  → 通过前缀复用减少 KV Cache 总占用
  → 命中率 > 30% 时有显著收益

策略4: Rate Limiting(限速)
  在 Preemption 发生前就拒绝超额请求
  → 比等 GPU 满后再 preempt 更有效
  → 保护正在运行的请求不被中断

策略5: 分层部署(Disaggregated)
  Prefill 和 Decode 放在不同 GPU 集群
  → 减少 Decode 资源的竞争
  → 配合 LMCache/Mooncake 跨节点传输 KV
面试话术:
"Preemption 是 vLLM 在显存压力下的优雅降级策略——不是直接丢请求,而是暂停进度较短的请求让它排队,等资源释放后再继续。但它有隐性成本:PCIe swap 比 HBM 慢 60 倍。好的策略是从源头预防 preemption——通过合理的 max_model_len 设置、prefix caching 和 rate limiting 来管理负载,而不是等到 GPU 满了才被动抢占。"
版本: v3.2 | 更新: 2026-10-30 | by 二狗子 🐕